 2026, Vol. 48
 Issue (4): 38-48


受光学成像硬件设备限制,单个传感器获取的图像只能包含部分图像信息[1-2]。因此,融合来自不同传感器的图像有利于丰富图像信息。在图像融合任务中,红外与可见光图像融合是应用最为广泛的一类[3]。红外传感器能够捕捉物体发出的热辐射。但受限于空间分辨率不足,且存在不可避免的噪声干扰,其探测结果难以提供物体的纹理信息和颜色信息。相反,可见光传感器可以捕获场景中的反射光,记录下丰富的纹理和颜色信息,但在受到光照和遮挡影响时,难以捕捉物体的具体轮廓。上述两种模态的信息具有互补性,所得融合图像的纹理与颜色信息丰富、目标特征显著,不仅便于人眼视觉观察,在军事、目标检测[4-5]、语义分割[6-7]、目标跟踪[8]等领域同样具有广泛的应用价值。
在过去的几十年里,已有大量红外图像与可见光图像融合的方法被提出。这些方法大致可分为两类:传统的图像融合方法[9]和基于深度学习的图像融合方法[10]。传统的图像融合方法虽然在多数情况下都能满足特定场景的需求,但仍然存在一些问题:传统方法通常采用相同的方式表达红外图像和可见光图像特征,没有针对相应的特征进行优化;且传统方法需要人工设计融合策略,无法满足复杂场景的需求[11]。近年来,随着深度学习的快速发展,研究人员探索了基于深度神经融合网络的融合方法。目前,主流的深度融合方法是利用卷积神经网络(convolutional neural network,CNN)或Transformer模型来实现的。基于CNN的方法又可进一步分为基于自编码器(auto-encoder,AE)[12]、基于端到端CNN[13]和基于生成对抗网络(generative adversarial network,GAN)[14]3类方法。基于Transformer模型的方法在包括自然语言处理[15]和图像分类[16]在内的各种任务中表现良好。这些方法利用自注意力机制来捕捉全局依赖关系,并能实现有效的特征表示学习。
尽管现有的基于深度学习的融合方法已经取得了令人满意的效果,但这类方法仍存在一些问题[17]。首先,现有的方法通常需要对输入的可见光图像进行处理,即将可见光图像从RGB空间转换到YCbCr空间,并使用Y通道进行融合[18]。融合图像虽然能保留清晰的边缘特征和细节特征,但会出现颜色失真和亮度过暗的问题,影响人眼视觉感知。其次,当前的研究主要聚焦在提升网络的特征提取能力,对融合阶段策略的优化关注较少。红外和可见光图像之间存在相关性和互补性,充分利用这些特性来整合多模态信息对于图像融合任务至关重要[19]。
针对上述问题,提出了一种新的红外和可见光图像融合方法FE-Fusion。级联的可逆卷积注意力模块(invertible convolution attention module,ICAM)和多尺度Transformer模块(multi-scale transformer module,MTRM),用来充分捕捉源图像的局部及全局特征。在融合阶段,所设计的交叉融合模块(cross fusion module,CFM)利用注意力机制学习捕捉特征之间的相关性,从而指导两种模态信息的融合,增强输出图像的特征表达。在损失函数中引入多通道损失约束模型,生成贴合人眼视觉感知的融合图像。在红外和可见光图像融合数据集上进行大量实验,并与当前先进的方法进行了定性和定量比较,证明了本文方法的优越性。为验证该方法的泛化性能,将训练好的模型应用于其他融合任务。优异的实验结果表明,该方法具备良好的泛化能力。
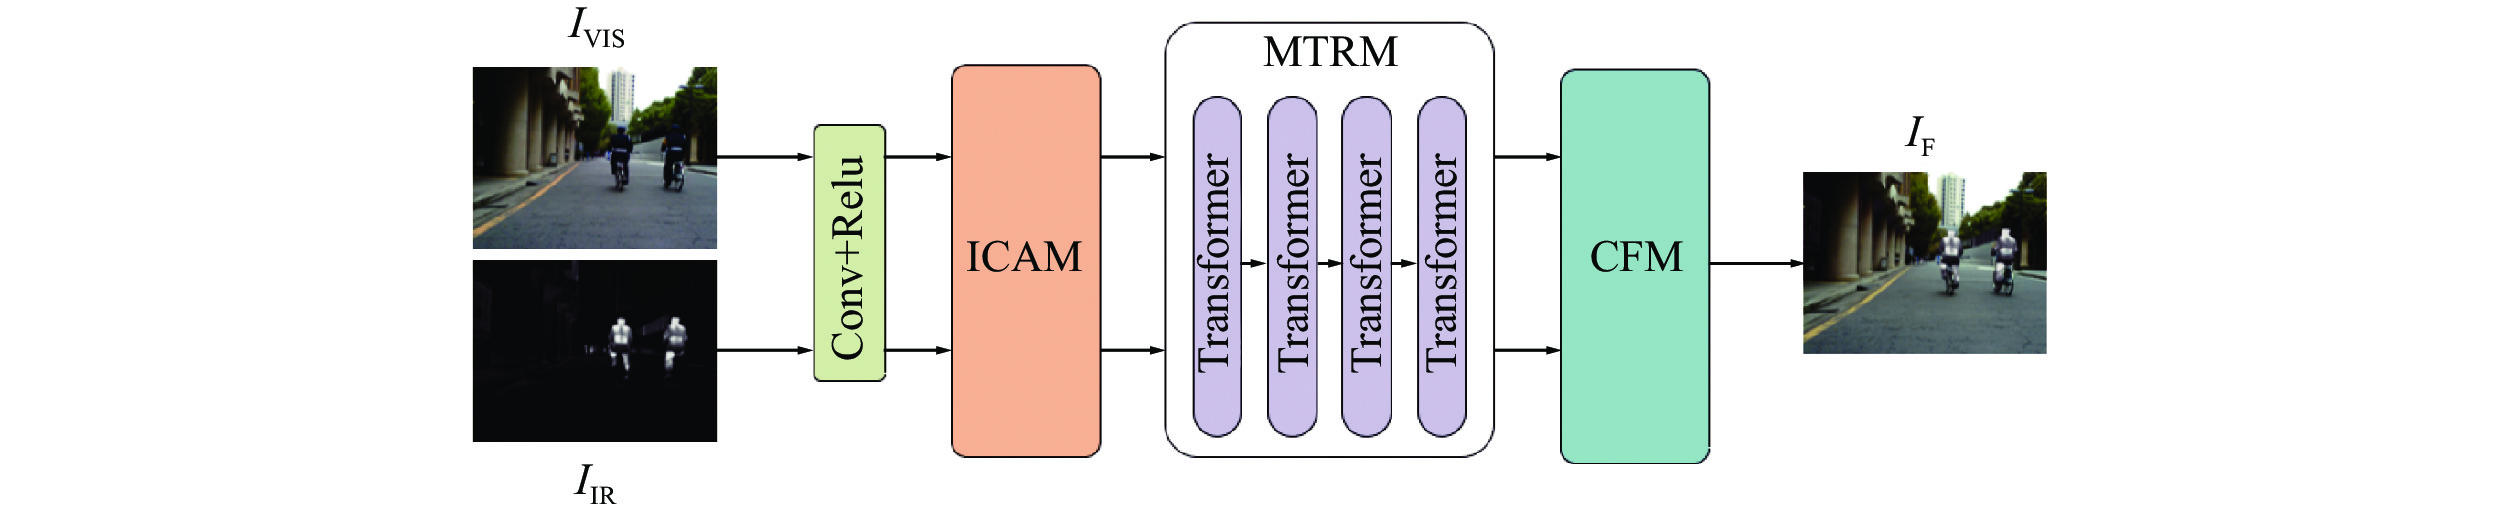
1 网络主体FE-Fusion整体框架如图1所示。整个网络由3个主要模块组成:可逆卷积注意力模块(ICAM)、多尺度Transformer模块(MTRM)和交叉融合模块(CFM)。输入一对配准的红外图像
|
图 1 FE-Fusion整体框架 Figure 1 The overall framework of FE-Fusion |
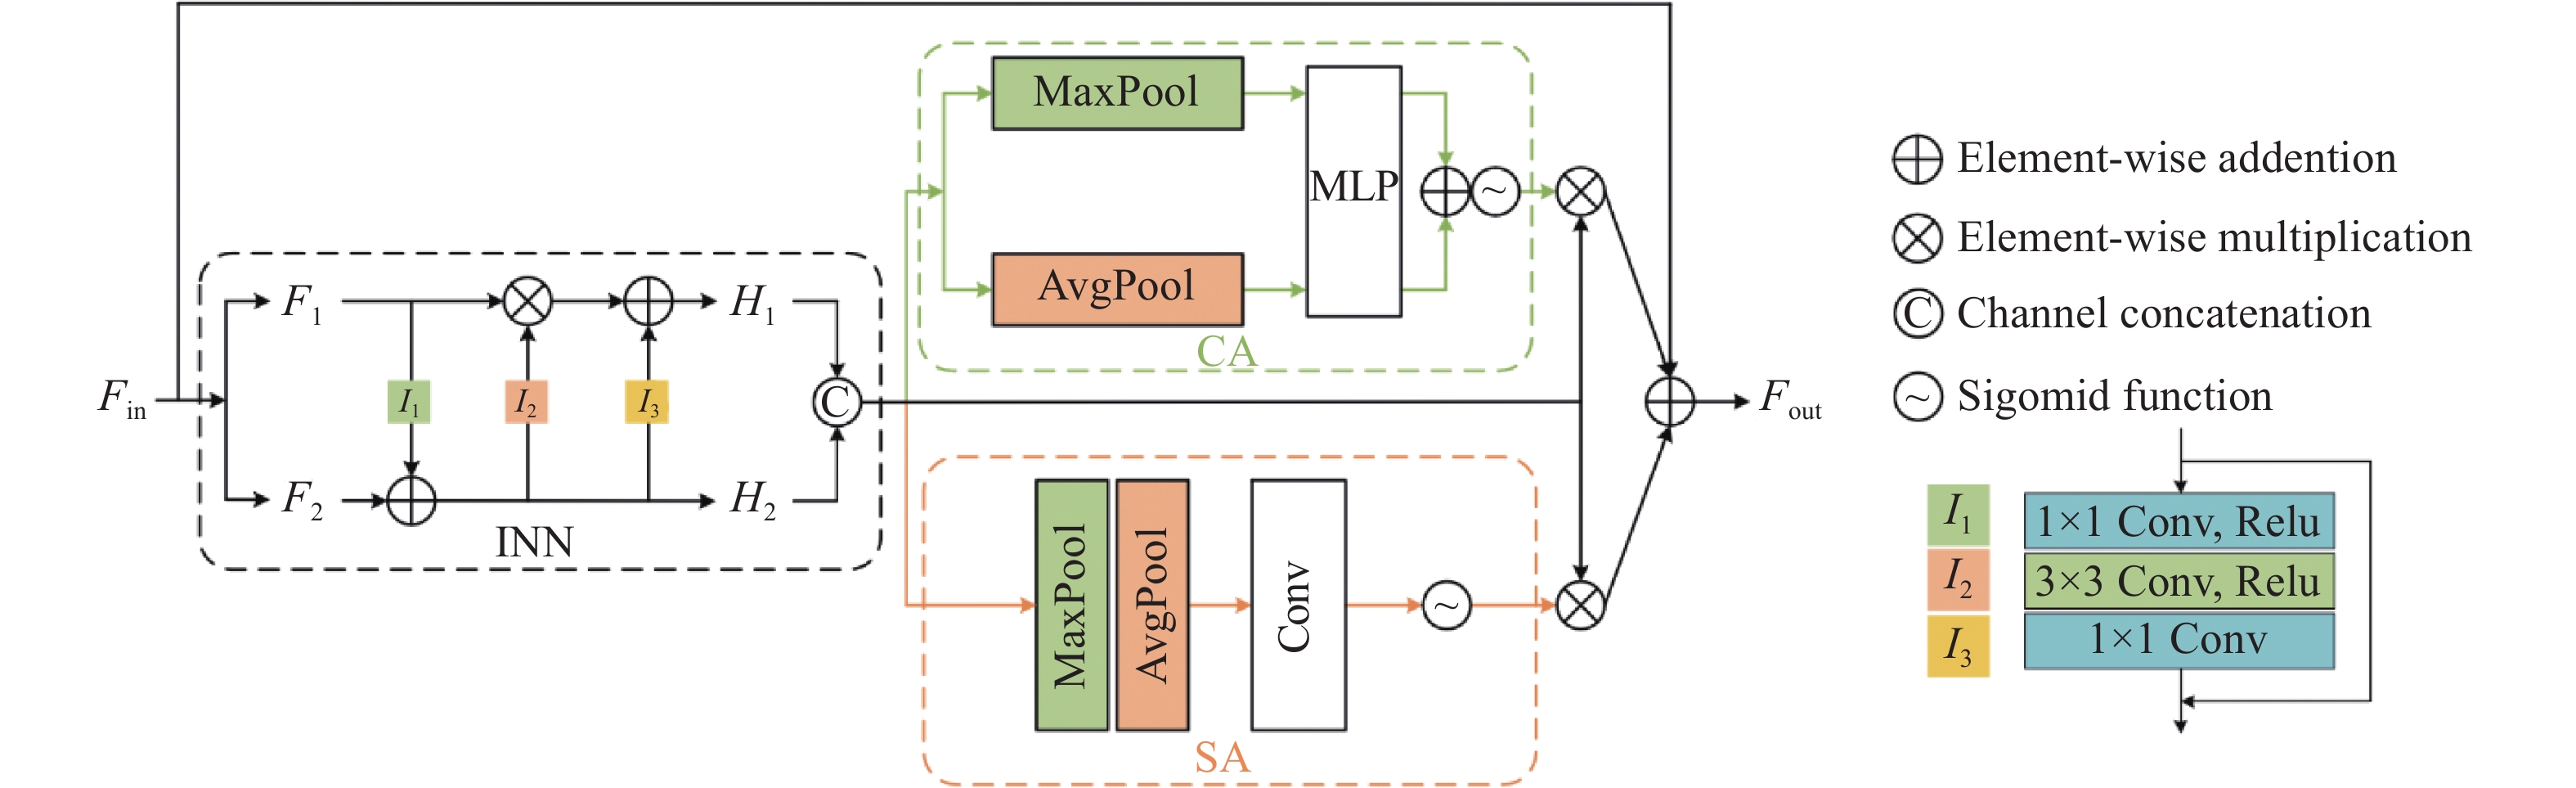
ICAM的结构如图2所示,由可逆神经网络、通道与空间卷积注意力构成。其中,可逆神经网络(invertible neural networks,INN)的输入和输出相互生成,二者特征之间存在无损映射,能够在网络前向传播过程中有效保留细节信息。通道注意力(channel-attention,CA)用于关注图像的颜色信息,空间注意力(spatial-attention,SA)则能更好地捕捉局部纹理和热辐射轮廓。
|
图 2 可逆卷积注意力模块 Figure 2 Invertible convolution attention module |
具体而言,浅层特征
| $ {H}_{1}={F}_{1}\times {I}_{2}\left({H}_{2}\right)+{I}_{3}\left({H}_{2}\right) $ | (1) |
| $ {H}_{2}={F}_{2}+{I}_{1}\left({F}_{1}\right) $ | (2) |
式中,
| $ F_{\text{out}}^{\text{CA}}={F}_{\text{CA}}\cdot F_{\text{out}}^{\text{INN}} $ | (3) |
| $ F_{\text{out}}^{\text{SA}}={F}_{\text{SA}}\cdot F_{\text{out}}^{\text{INN}} $ | (4) |
同时在
| $ {F}_{\text{out}}={F}_{\text{in}}+F_{\text{out}}^{\text{CA}}+F_{\text{out}}^{\text{SA}} $ | (5) |
CA首先通过平均池化(AvgPool)和最大池化(MaxPool)操作对特征图的空间信息进行聚合,生成平均池化特征和最大池化特征。然后,将其传递给多层感知机(multilayer perceptron,MLP),通过元素求和得到输出。
| $ \begin{split} {F}_{\text{CA}}=&\; \sigma \left(MLP\left(AvgPool\left(F_{\text{out}}^{\text{INN}}\right)\right)\right)+\\& \sigma \left(MLP\left(MaxPool\left(F_{\text{out}}^{\text{INN}}\right)\right)\right) \end{split}$ | (6) |
式中,
| $ \begin{split} {F}_{ {\mathrm{SA}}}=\;&\sigma \Big({Conv}^{7\times 7} \Big(\Big[AvgPool\left(F_{\text{out}}^{\text{INN}}\right);\\&MaxPool\left(F_{\text{out}}^{\text{INN}}\right)\Big]\Big)\Big) \end{split} $ | (7) |
式中,
如图1所示,MTRM级联了4组Transformer模块来捕捉全局上下文特征,每组的尺度不同,捕捉到的特征大小也不相同。具体而言,输入图像会被划分成多个大小相同的图像块,不同尺度的Transformer模块会对图像块通道进行扩展,通道数量依次扩展为
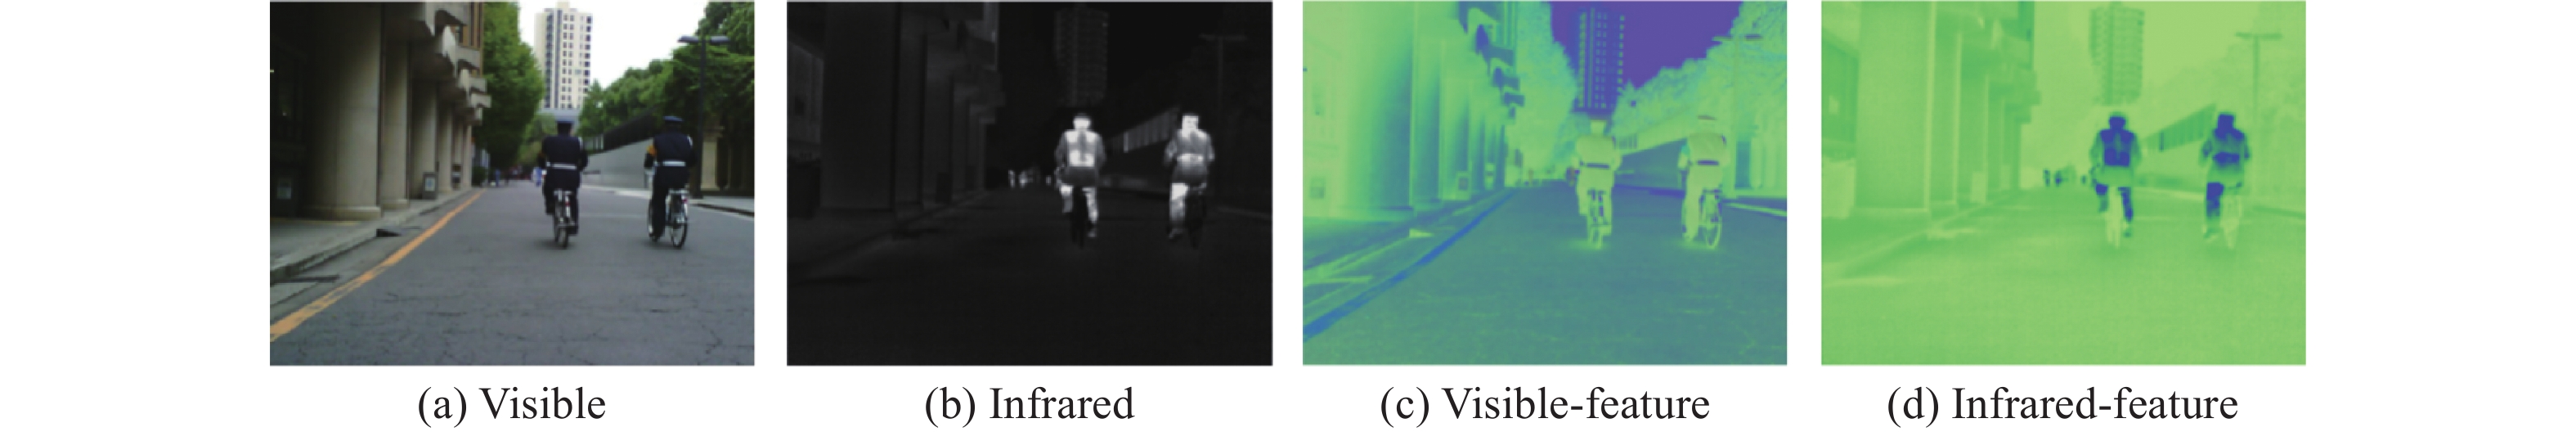
不同模态特征包含的信息各不相同:红外图像特征更多突出了目标的轮廓特征,可见光图像特征则包含了纹理和颜色特征。图3所示为特征提取网络提取到的红外特征和可见光特征,可以看到,两种模态特征不仅提供的信息互补,而且在图像上的分布相互对应。因此,设计了交叉融合模块(CFM),以充分利用多模态特征的相关性引导网络关注它们交汇的部分,在特征融合过程中平衡两种模态的信息,避免信息的冗余和丢失。
|
图 3 多模态特征分布 Figure 3 Distribution of infrared and visible image features |
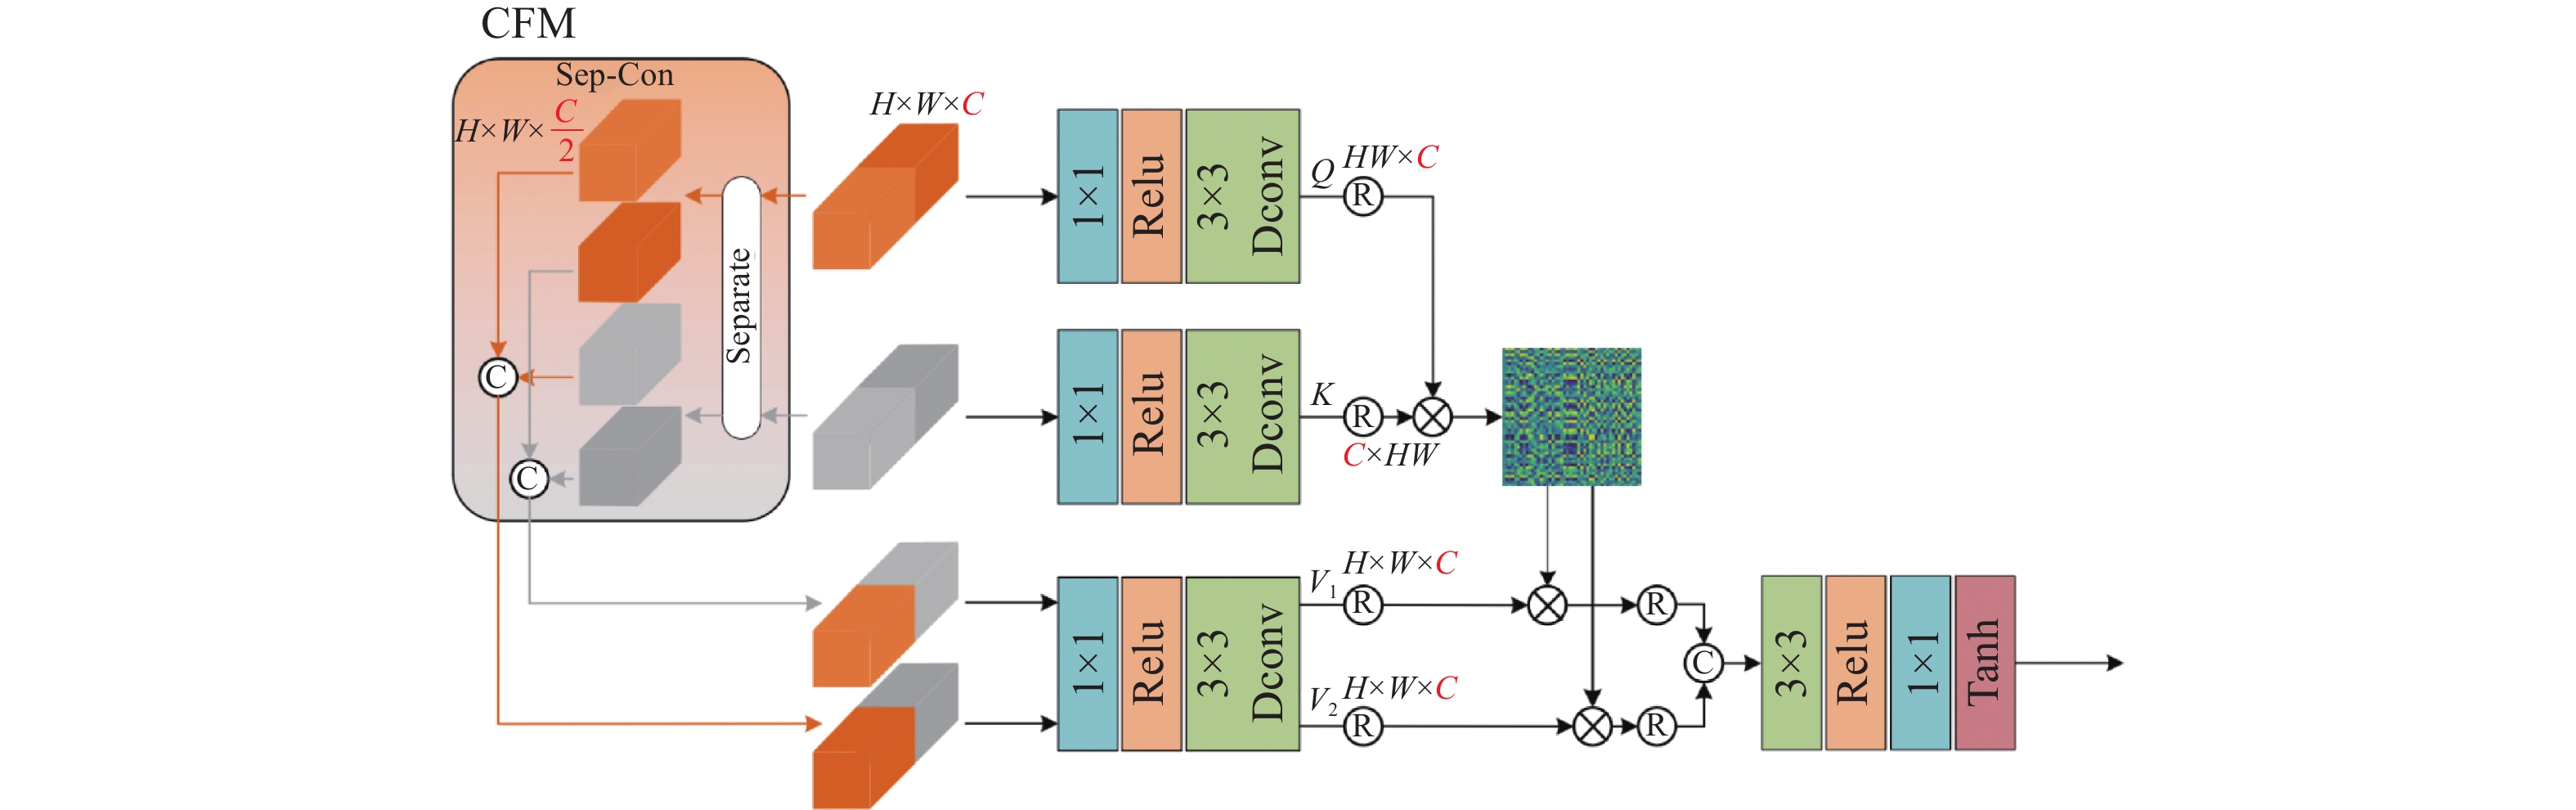
CFM结构如图4所示。首先,对提取到的红外图像特征和可见光图像特征沿通道维度进行切割;随后,对其进行交叉连接操作,得到相应的混合特征;最后,将得到的4类特征一同输入融合模块。经过两个卷积,特征分别重塑为查询向量
|
图 4 交叉融合模块 Figure 4 Cross fusion module |
| $ \boldsymbol{A}=\boldsymbol{Q}{\boldsymbol{K}}^{\mathrm{T}} $ | (8) |
相似矩阵A代表了图像每个位置上红外特征和可见光特征的分布。使用Softmax函数对权重进行归一化,并与
| $ Attention\left(\boldsymbol{Q},\boldsymbol{K},{\boldsymbol{V}}_{j}\right)={\widehat{\boldsymbol{V}}}_{j}\cdot Softmax\left(\boldsymbol{Q}\cdot \boldsymbol{K}\right) $ | (9) |
式中,
图像融合的目标之一是将源图像中的纹理细节集成到融合图像中。梯度损失利用Sobel梯度算子测量融合图像的纹理信息,增强融合图像上纹理和边缘信息的显示。FE-Fusion直接处理多通道输入图像,将原本的梯度损失扩展为多通道梯度损失
| $ {L}_{\text{grad}}=\frac{1}{HW}\sum \limits_{i=1}^{3}{\left|\left|\nabla I_{\mathrm{F}}^{i}-\max \left(\nabla \left| {I}_{\text{IR}}\right| ,\nabla \left| I_{\text{VIS}}^{i}\right| \right)\right|\right|}_{1} $ | (10) |
式中:
热辐射通常以像素强度为特征。应用强度损失使融合图像具有与红外图像和可见光图像相似的强度分布。与
| $ {L}_{\text{int}}=\frac{1}{HW}\sum \limits_{i=1}^{3}{\left|\left|I_{\mathrm{F}}^{i}-\max \left({I}_{\text{IR}},I_{\text{VIS}}^{i}\right)\right|\right|}_{1} $ | (11) |
最终的多通道损失
| $ {I}_{\text{loss}}={L}_{\text{grad}}+{L}_{\text{int}} $ | (12) |
首先,介绍本研究实验内容;然后,在两个公共数据集中将FE-Fusion与当前先进的方法进行比较;最后,用消融实验证明FE-Fusion各模块的有效性。
2.1 数据集和训练内容实验涉及到两个数据集:MSRS和M3FD数据集。MSRS数据集[22]提供了1 444对道路场景的红外与可见光图像。其中1 083对图像用于训练,361对用于测试。M3FD数据集[15]提供了300对红外与可见光图像。每个数据集选取其中的20对图像作定量比较。
在训练阶段,使用MSRS数据集的原始图像大小,不进行裁剪或缩放;在验证泛化性能阶段,使用M3FD数据集,且不针对数据集进行微调。输入的可见光图像大小为
使用8个指标来定量测量融合结果:熵(entropy,EN)、标准差(standard deviation,SD)、空间频率(spatial frequency,SF)、互信息(mutual information,MI)、差异相关和(sum of correlation differences,SCD)、视觉信息保真度(visual information fidelity,VIF)、边缘信息(
针对所提出的网络结构优化与输入图像预处理两项内容,本文选取了6种当前先进的方法进行对比实验:U2Fusion[13]、LRRNet[23]、YDTR[24]、DATFuse[25]、Dif-Fusion[17]和PTET[26]。在网络结构方面:U2Fusion和LRRNet是基于CNN 提出的方法;PTET是基于Transformer提出的方法;YDTR和DATFuse与本文方法相同,都采用了CNN和Transformer结合的网络框架。在输入图像预处理方面,前4种对比方法都需要对输入图像进行颜色空间转换;Dif-Fusion和PTET与本文方法一样,可以直接处理彩色输入图像。用于比较的融合图像使用的是可公开访问的代码和预训练模型生成的。
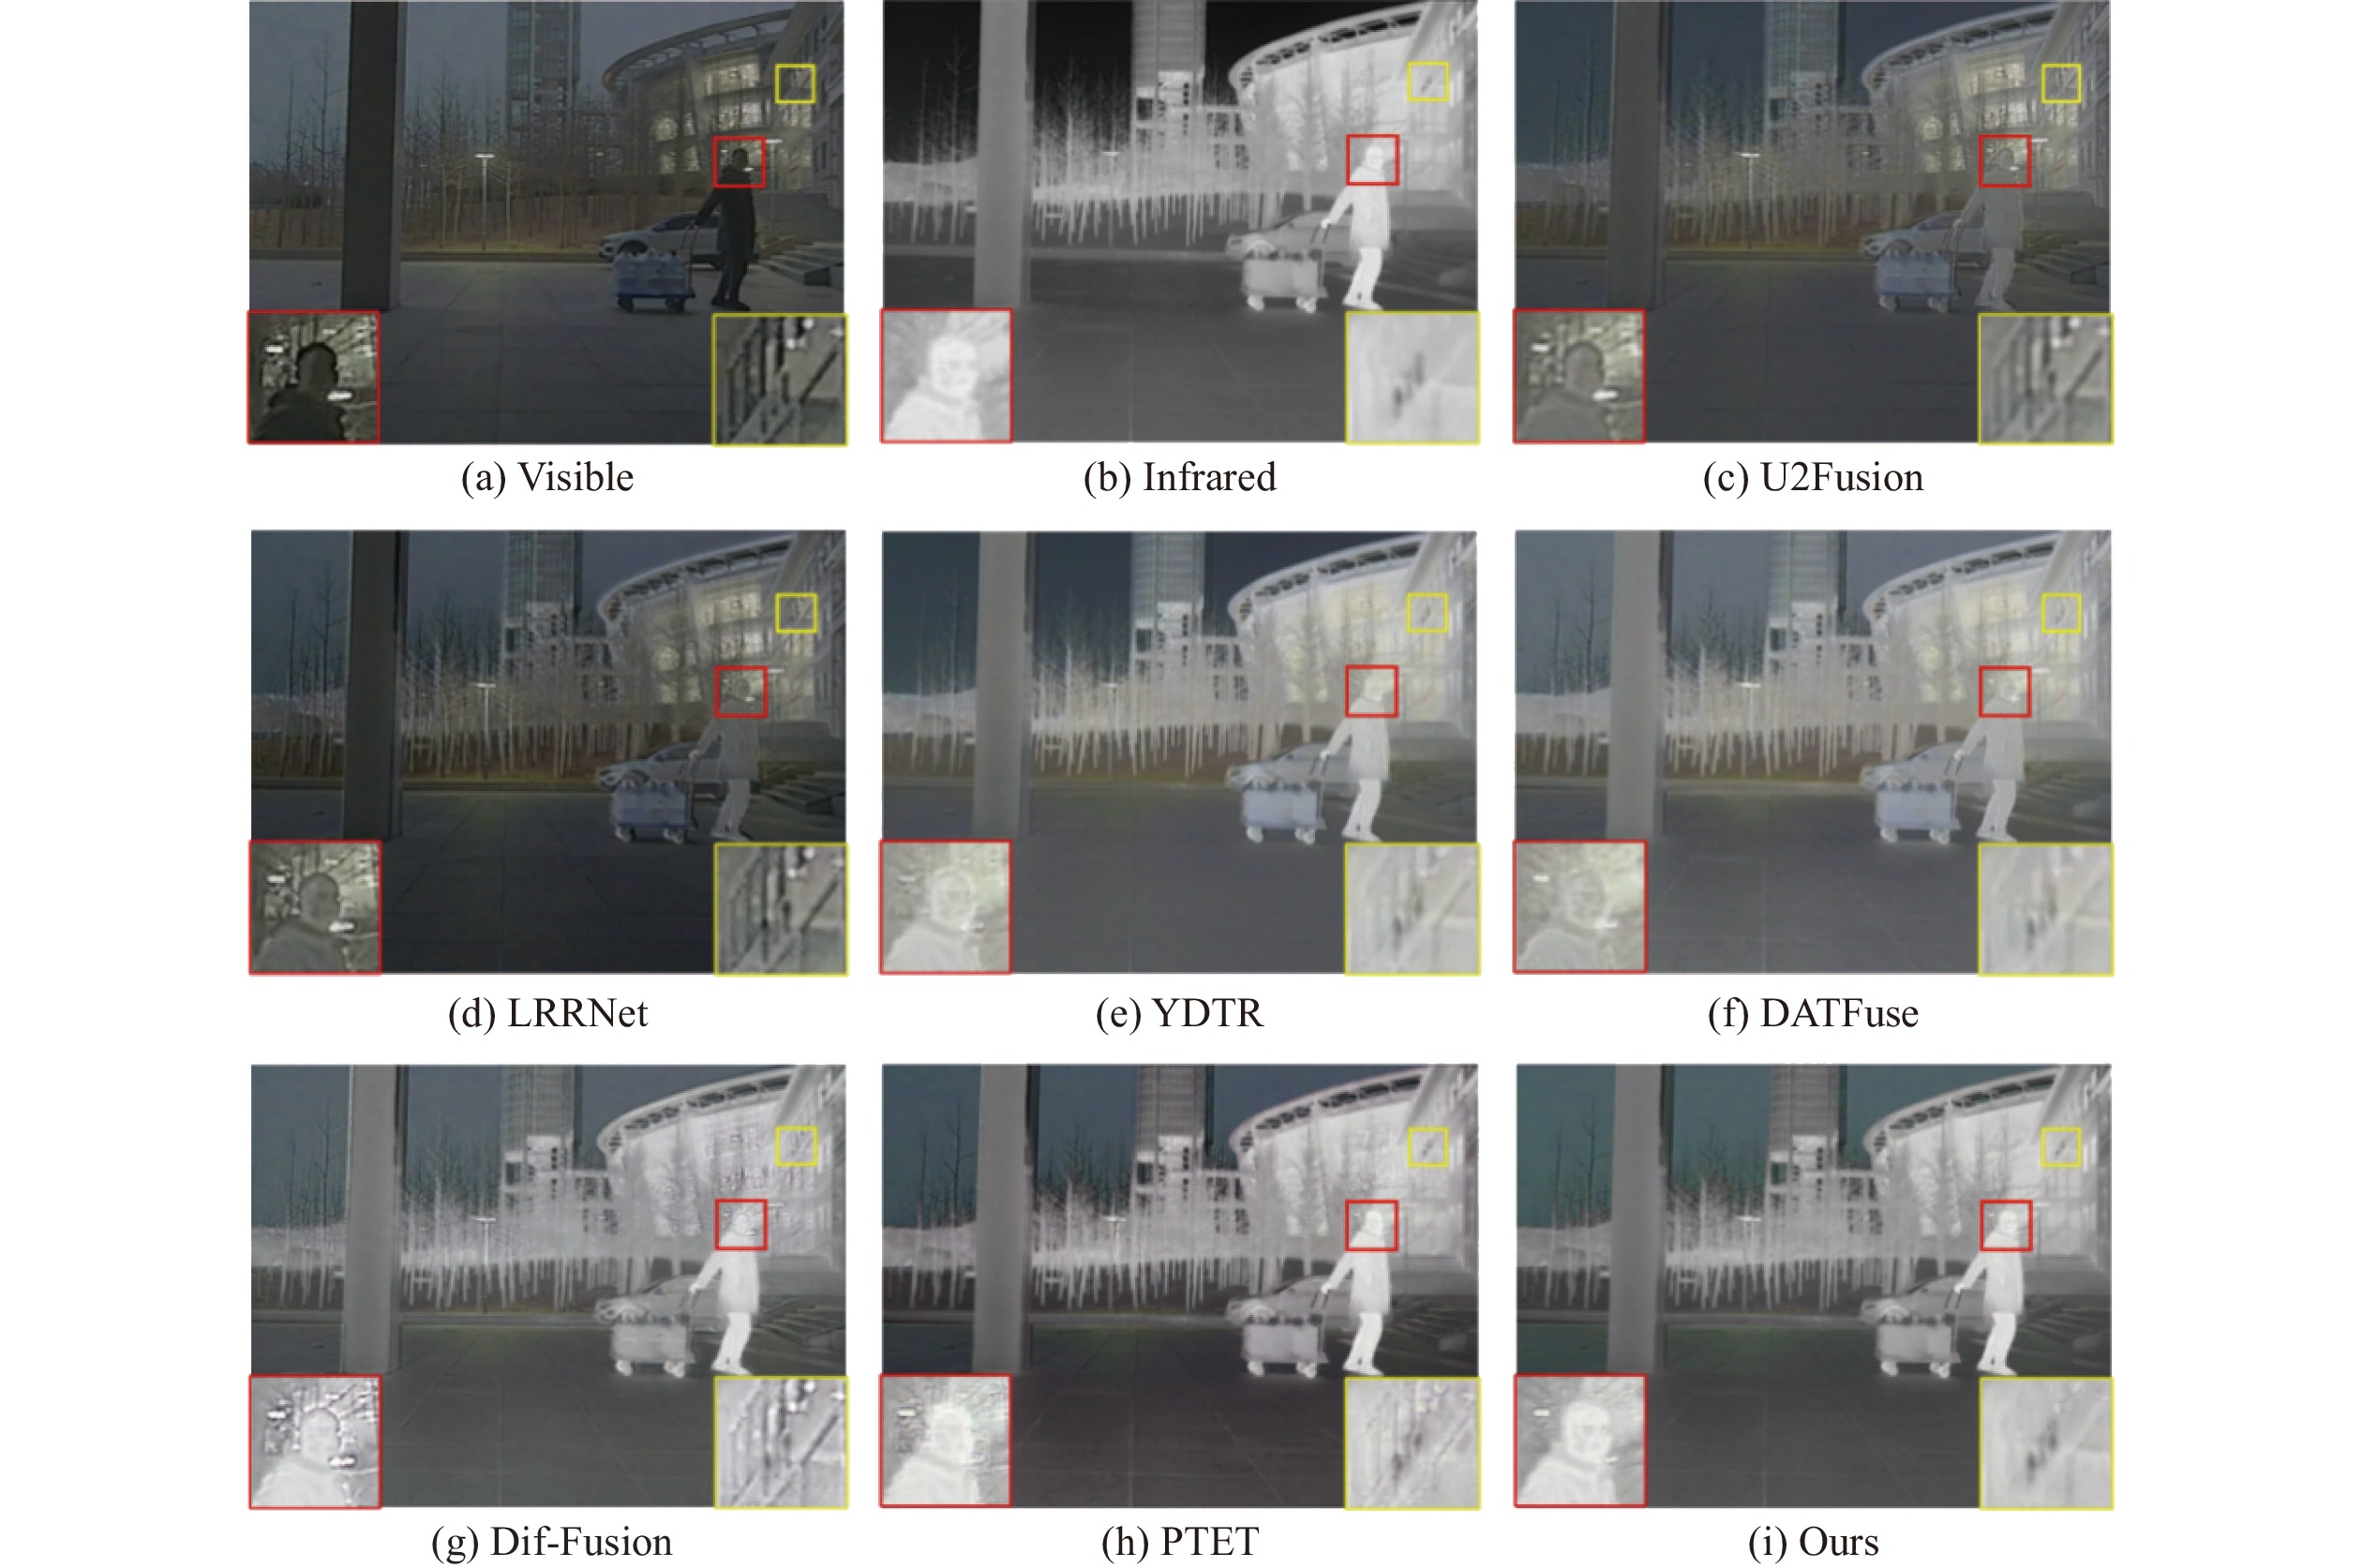
2.3 融合结果分析MSRS数据集包含了白天和黑夜两种场景。为了直观地评估FE-Fusion与对比算法的融合性能,从两种场景中各选一对图像来展示融合结果。
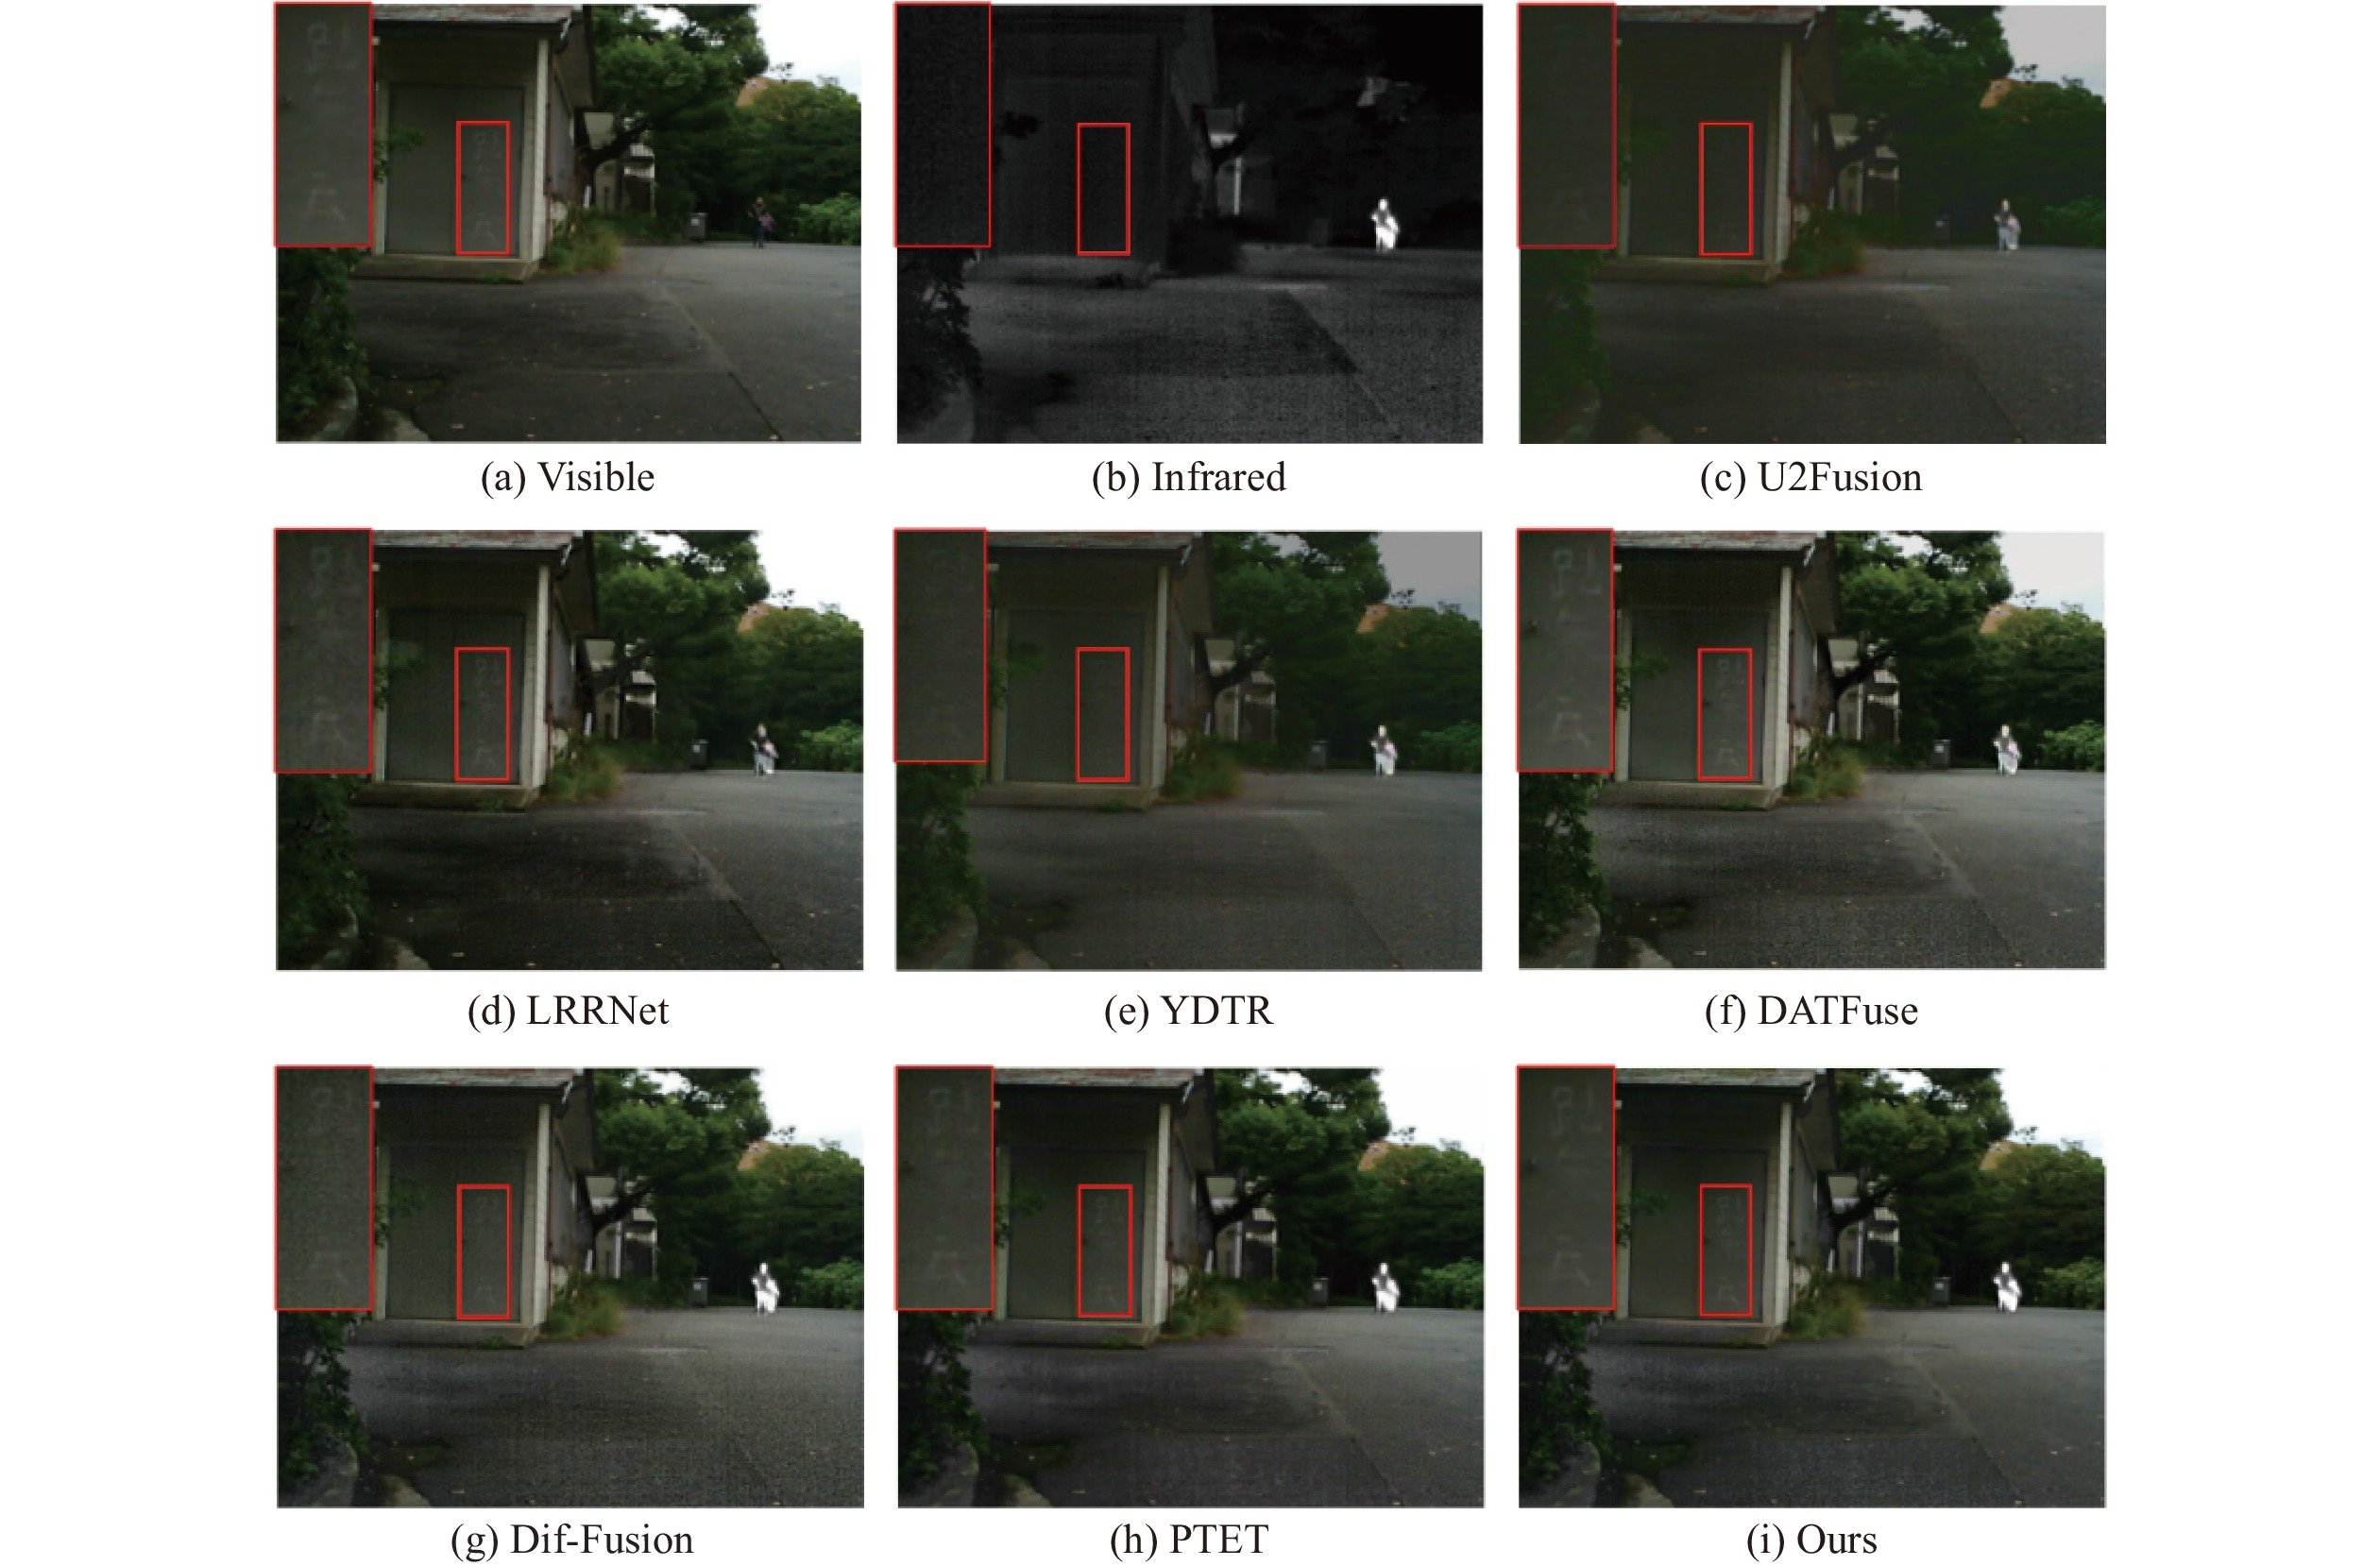
图5是白天场景的可视化结果。可见光图像包含了丰富的颜色和细节纹理,红外图像突出了人物轮廓。所有的融合图像都保留了人物轮廓。U2Fusion和YDTR出现了颜色失真,树木的颜色变黑,整体色调较暗。红色方框区域放大了门上的文字,只有DATFuse、PTET和本文方法捕捉到了细节信息,将文字清晰地展示出来。Dif-Fusion虽然同样捕捉到了红色方框内的文字信息,但受背景颜色的影响,文字不够清晰。此外,由于红外图像中出现了杂乱的热噪声,LRRNet和DATFuse都受到了影响,生成的融合图像不够平滑。本文方法的融合结果不仅在颜色和细节保留上具有优势,还避免了噪声的干扰,图像更加清晰平滑。
|
图 5 MSRS数据集00630D图像对的可视化结果 Figure 5 Visualization results of image 00630D from the MSRS dataset |
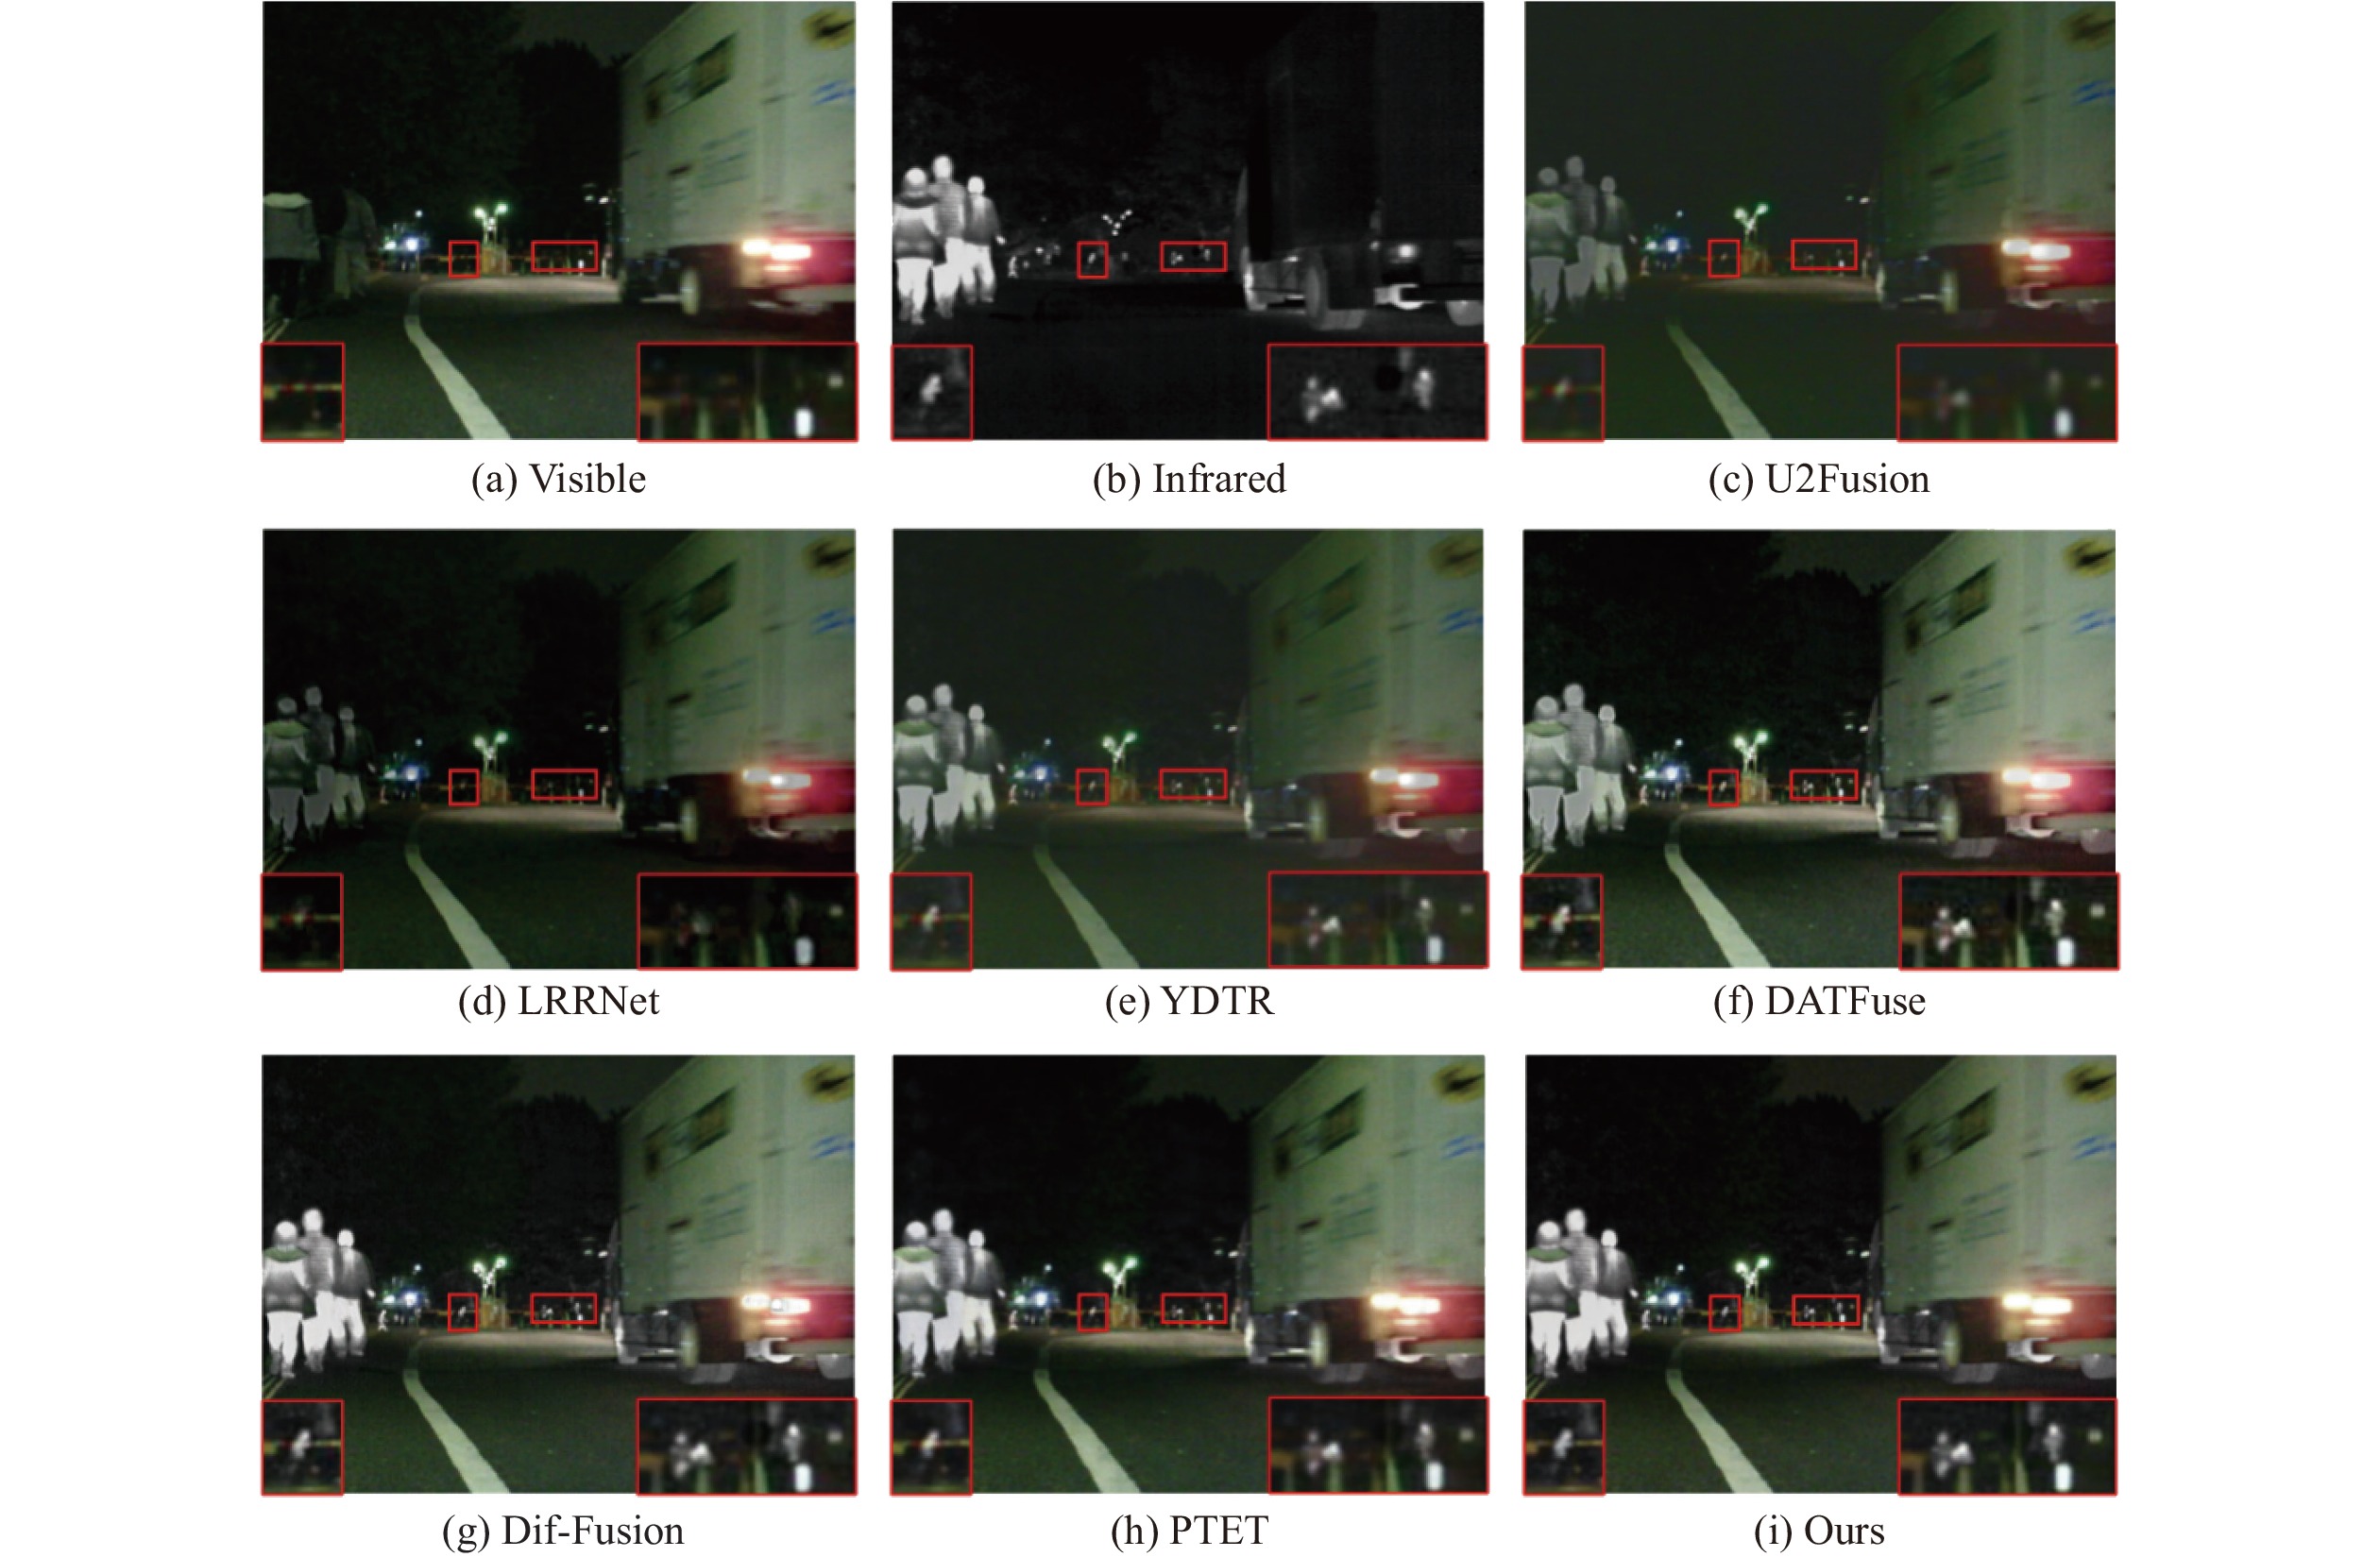
图6是夜间场景的可视化结果,红外图像仍可突出热辐射目标,而可见光图像仅在光照充足时,才能呈现出物体的纹理与颜色信息。希望融合图像能够在突出热辐射目标的同时,尽可能保留可见光图像中有价值的信息。图6(a)红外图像的左半部分有3个近处的行人,同时图像的中间还有3个远处的行人。由于远处的3个行人较小,因此进行了局部放大(见红色框区域)。与其他图像相比,U2Fusion、LRRNet、YDTR和DATFuse在突出近处3个行人轮廓时亮度较低,人物与背景之间的边缘不够明显。Dif-Fusion、PTET和本文方法不仅能清晰地突出近处的行人,而且能捕捉到红色框内远处行人的轮廓,表明其在捕捉微小特征时具有优势。
|
图 6 MSRS数据集00890N图像对的可视化结果 Figure 6 Visualization results of image 00890N from the MSRS dataset |
选取MSRS数据集中的20对图像,针对上述7种方法展开定量对比分析,实验结果如表1所示,各项最优取值用红色标识。结果表明,FE-Fusion在大部分指标上都优于其他方法,虽然在SF项上略有落后,但与其他最优方法差距不大。由此说明,本文方法不仅能完整地提取图像的局部显著特征和全局重要特征,且直接生成的融合图像也能很好地保留纹理、颜色特征。
|
表 1 7种方法的定量对比 Table 1 Quantitative comparison of the seven methods |
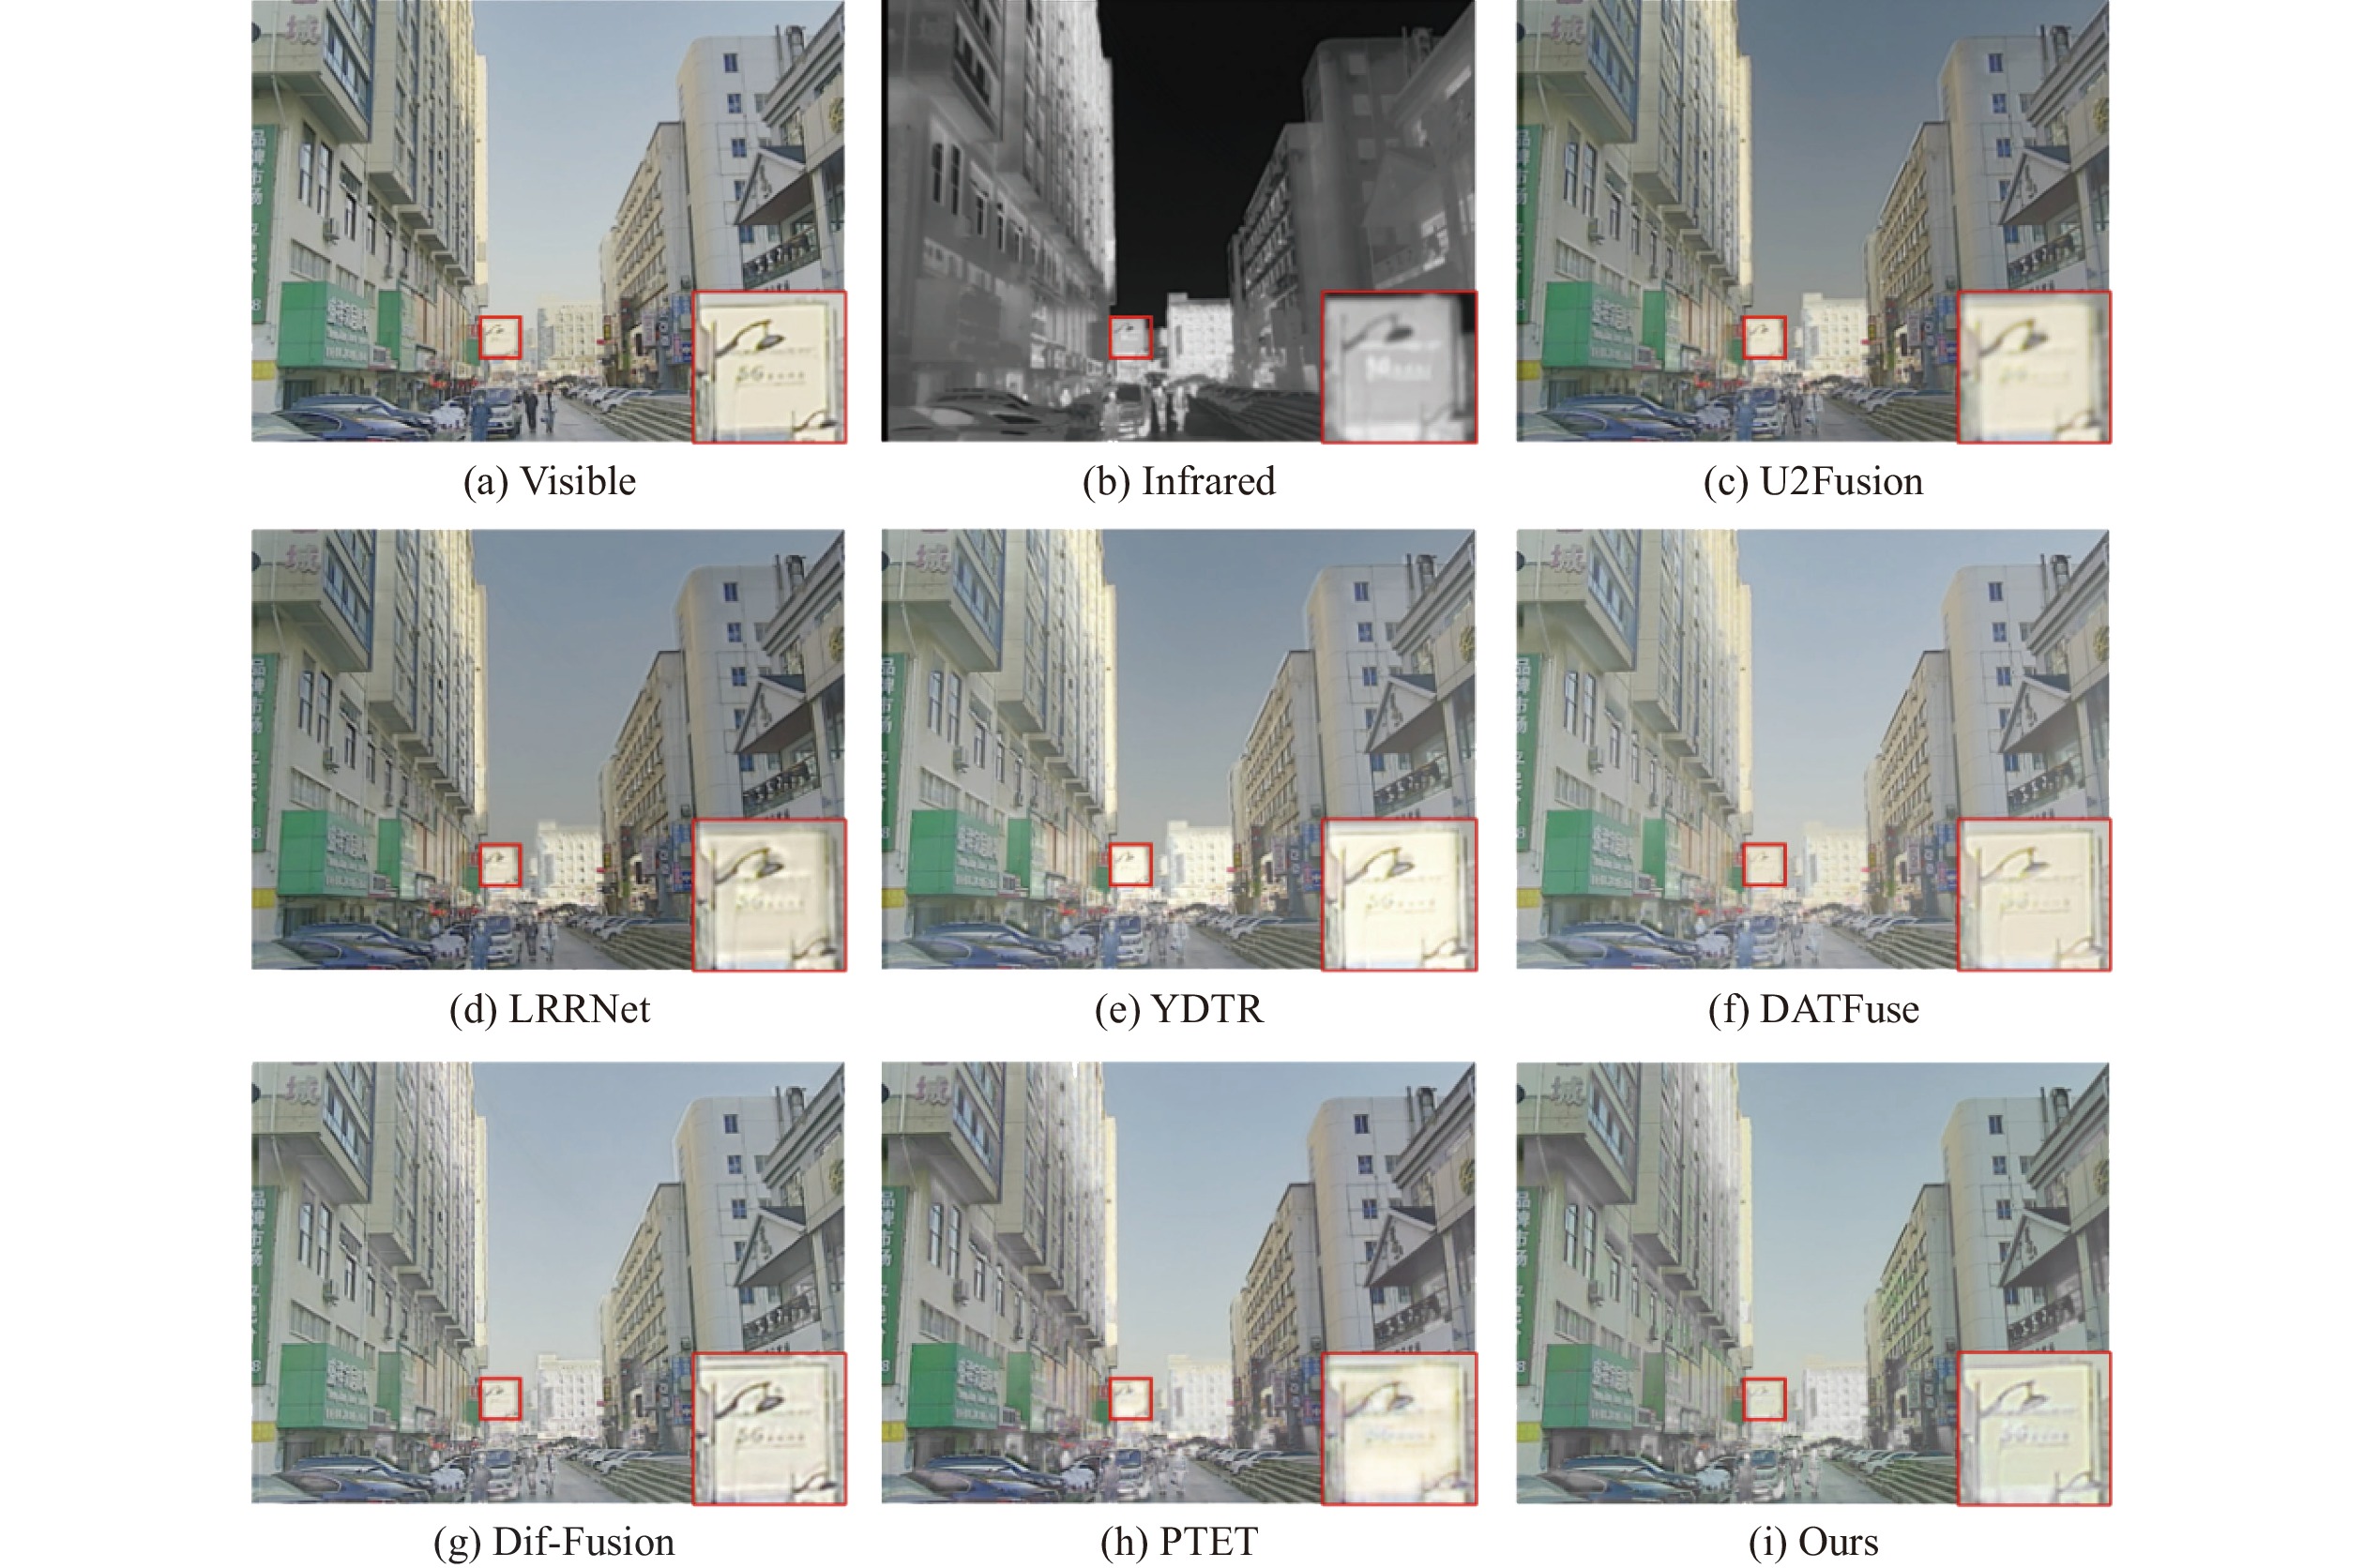
图7和图8所示为本文方法和其他6种方法在M3FD数据集上融合结果的可视化比较。图7中可见光图像呈现了一处街道场景,图像中包含丰富的颜色特征和细节特征。所有方法生成的融合图像,在整体色调上均与可见光图像保持一致。对红色框所选区域进行放大观察可见:U2Fusion、YDTR和PTET 3种方法在对该区域进行融合时,结果出现了失真,表现为色调偏亮、文字模糊不清;LRRNet方法的融合结果则存在明显的伪影;DATFuse方法虽捕捉到了红色方框内的颜色信息,但与Dif-Fusion和本文方法相比,文字较为模糊、难以清晰辨认。仅有Dif-Fusion方法和本文方法,既能清晰还原区域内的文字信息,又未出现任何颜色失真,更便于人眼观察。
|
图 7 M3FD数据集03640图像对的可视化结果 Figure 7 Visualization results of image 03640 from the M3FD dataset |
|
图 8 M3FD数据集04006图像对的可视化结果 Figure 8 Visualization results of image 04006 from the M3FD dataset |
选取了图8中两个区域进行放大。在红外图像的红色框所选区域可以观察到戴眼镜的人,黄色框所选区域中有一行文字。受光照影响,可见光图像中两个框所选区域中的信息都不够明显。除了本文方法,其他方法在捕捉红色框中的细节时表现不佳。YDTR、DATFuse和PTET 3种方法虽然捕捉到了黄色框内的文字,但文字与背景颜色几乎相同,很难辨别出文字的具体轮廓。只有本文方法可以同时呈现两个所选区域的关键特征,显示了其在颜色、细节保留方面的优势。
进一步对M3FD数据集中选取的20对图像进行定量比较,评价指标结果如表2所示,以红色标识各项最优取值。在所有指标中,本文方法于5项指标上取得最优结果,充分证实了FE-Fusion相较于其他对比方法,具备更为显著的性能优势。
|
|
表 2 泛化性实验中7种方法的定量比较 Table 2 Quantitative comparison of seven methods in generalization experiments |
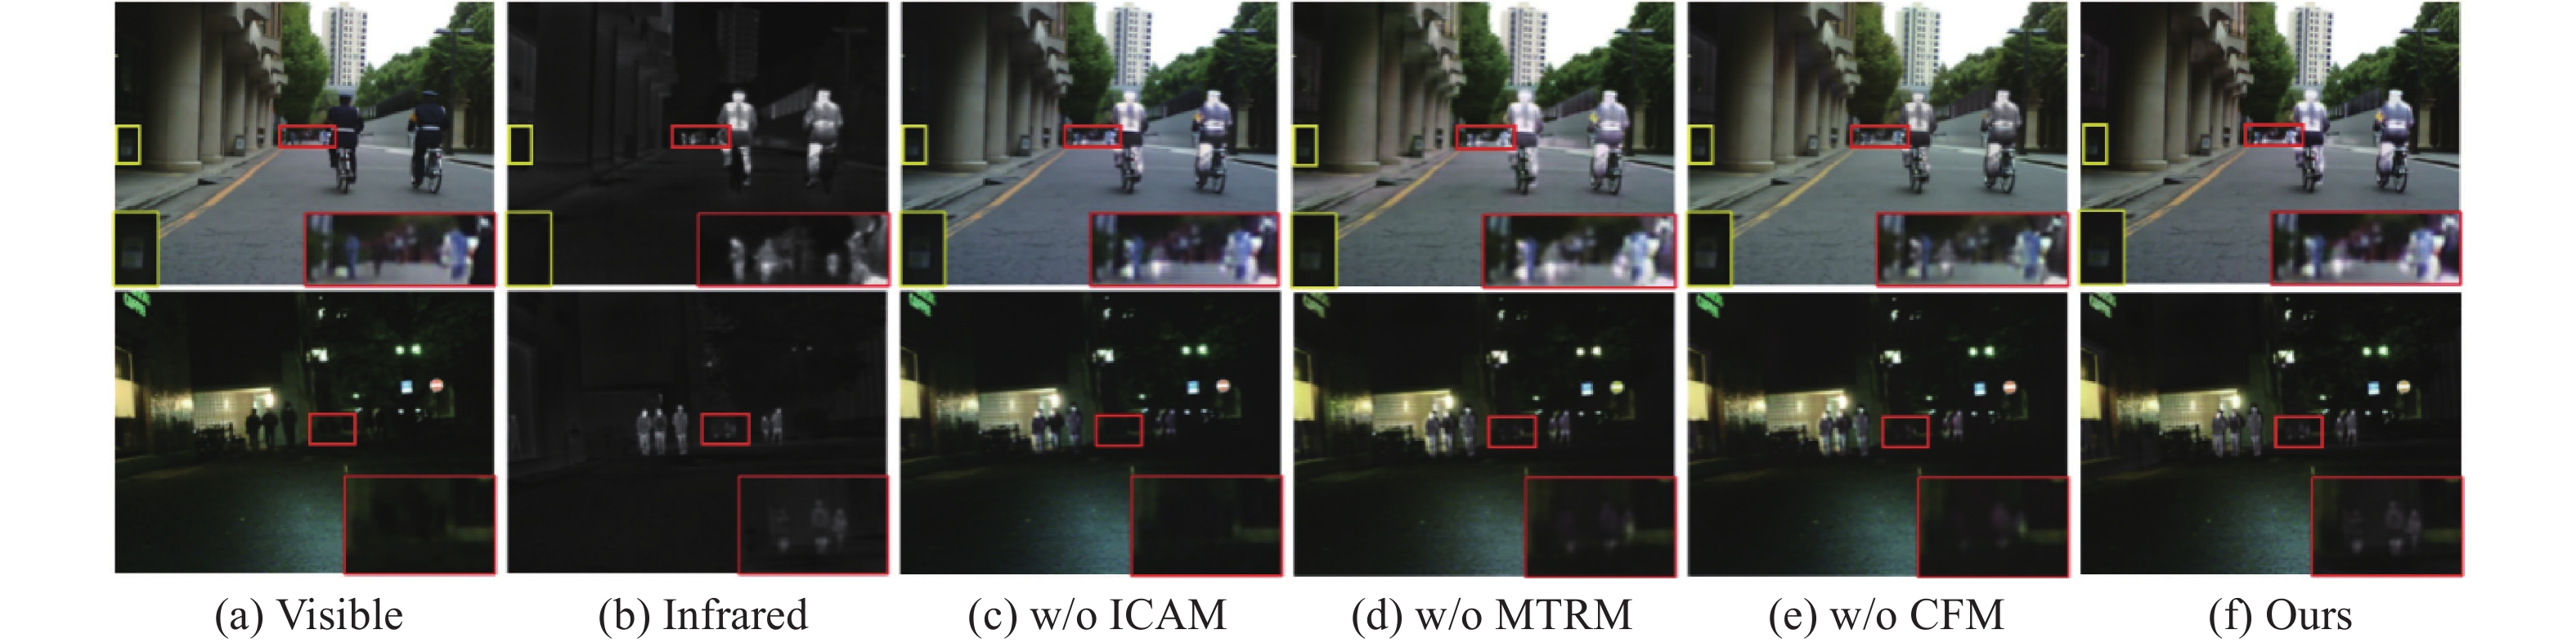
所提出的FE-Fusion方法组合了ICAM、MTRM和CFM 3种模块。ICAM、MTRM有效挖掘了源图像的局部和全局互补特征。CFM充分整合了多模态互补特征,并利用它们的相关性实现特征的互补融合。为调查各模块的有效性,分成w/o ICAM、w/o MTRM和w/o CFM 3种结构进行消融实验。图9所示为来自 MSRS 数据集的两对图像的融合结果。从图9(c)可以看到,红外图像中稍大的红色框选定区域中的3个行人不见了,表明缺少ICAM模块的网络没有捕捉到这一特征,细节信息丢失了。图9(d)所示为缺少MTRM模块的可视化结果。该网络不能很好地构建远程依赖关系,融合图像较为模糊。图9(e)所示为只包含两种特征提取模块,舍去了融合模块CFM的可视化结果。从第一排图像的红色框选定区域中可以看到,网络捕捉到了红外图像中高亮的人物轮廓,但与可见光图像相比,融合图像丢失了一部分颜色特征,背景色调更偏绿色。这说明融合过程中出现了特征丢失的问题。图9(f)为完整FE-Fusion网络的可视化结果。其不仅捕捉到了红外和可见光图像的细节和纹理,还在融合时有效平衡了两种模态信息,避免了色调失真的问题。
|
图 9 MSRS数据集(00537D、01315N图像对)上的消融实验可视化结果 Figure 9 Ablation study on network frameworks from the MSRS dataset(00537D、01315N image pairs) |
表3所示为完整的FE-Fusion网络与各种缺失结构的定量比较,各项最优取值用红色标识。实验结果表明,完整结构明显优于其他的融合网络,验证了各模块的有效性。
|
|
表 3 消融实验的定量比较 Table 3 Quantitative comparison of ablation study |
本文提出了新的特征提取融合网络FE-Fusion。在特征提取阶段,ICAM和MTRM模块既能有效地提取输入图像的局部特征,又能充分构建全局上下依赖关系。在融合阶段,所设计的CFM模块利用注意力机制整合多模态互补特征,在两种信息融合之间取得了很好的平衡。在损失函数中引入多通道梯度和强度损失,可有效保持输出图像的梯度和强度。大量实验表明,FE-Fusion在视觉感知和客观评估方面都达到了最佳的结果。将该方法应用到其他图像融合任务中,实验结果也证明其具有良好的泛化性。
| [1] | ZHANG H, XU H, TIAN X, et al. Image fusion meets deep learning: a survey and perspective[J]. Information Fusion, 2021, 76: 323–336. DOI:10.1016/j.inffus.2021.06.008 |
| [2] | 唐霖峰, 张浩, 徐涵, 等. 基于深度学习的图像融合方法综述[J]. 中国图象图形学报, 2023, 28(1): 3–36. |
| [3] | MA J Y, MA Y, LI C. Infrared and visible image fusion methods and applications: a survey[J]. Information Fusion, 2019, 45: 153–178. DOI:10.1016/j.inffus.2018.02.004 |
| [4] | SUN Y M, CAO B, ZHU P F, et al. DetFusion: a detection-driven infrared and visible image fusion network[C]//Proceedings of the 30th ACM International Conference on Multimedia. Lisboa: ACM, 2022: 4003 − 4011. |
| [5] | 汤应薇, 张荣福, 丁然, 等. MSA-Net: 一种基于多阶段注意力机制的少样本目标检测方法[J]. 光学仪器, 2023, 45(6): 14–24. DOI:10.3969/j.issn.1005-5630.202302030011 |
| [6] | TANG L F, YUAN J T, MA J Y. Image fusion in the loop of high-level vision tasks: a semantic-aware real-time infrared and visible image fusion network[J]. Information Fusion, 2022, 82: 28–42. DOI:10.1016/j.inffus.2021.12.004 |
| [7] | 王俊强, 李建胜, 丁波, 等. 深度学习语义分割方法在遥感影像分割中的性能分析[J]. 计算机测量与控制, 2019, 27(7): 231–235. DOI:10.16526/j.cnki.11-4762/tp.2019.07.050 |
| [8] | LI H, WU X J, KITTLER J. RFN-Nest: an end-to-end residual fusion network for infrared and visible images[J]. Information Fusion, 2021, 73: 72–86. DOI:10.1016/j.inffus.2021.02.023 |
| [9] | ZHOU Z Q, WANG B, LI S, et al. Perceptual fusion of infrared and visible images through a hybrid multi-scale decomposition with Gaussian and bilateral filters[J]. Information Fusion, 2016, 30: 15–26. DOI:10.1016/j.inffus.2015.11.003 |
| [10] | LIU Y, CHEN X, WANG Z F, et al. Deep learning for pixel-level image fusion: recent advances and future prospects[J]. Information Fusion, 2018, 42: 158–173. DOI:10.1016/j.inffus.2017.10.007 |
| [11] | LI S T, KANG X D, FANG L Y, et al. Pixel-level image fusion: a survey of the state of the art[J]. Information Fusion, 2017, 33: 100–112. DOI:10.1016/j.inffus.2016.05.004 |
| [12] | LI H, WU X J. DenseFuse: a fusion approach to infrared and visible images[J]. IEEE Transactions on Image Processing, 2019, 28(5): 2614–2623. DOI:10.1109/TIP.2018.2887342 |
| [13] | XU H, MA J Y, JIANG J J, et al. U2fusion: a unified unsupervised image fusion network[J]. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2022, 44(1): 502–518. DOI:10.1109/TPAMI.2020.3012548 |
| [14] | MA J Y, YU W, LIANG P W, et al. FusionGAN: a generative adversarial network for infrared and visible image fusion[J]. Information Fusion, 2019, 48: 11–26. DOI:10.1016/j.inffus.2018.09.004 |
| [15] | VASWANI A, SHAZEER N, PARMAR N, et al. Attention is all you need[C]//Proceedings of the 31st International Conference on Neural Information Processing Systems. Long Beach: Curran Associates Inc. , 2017: 6000 − 6010. |
| [16] | DOSOVITSKIY A, BEYER L, KOLESNIKOV A, et al. An image is worth 16×16 words: transformers for image recognition at scale[C]//International Conference on Learning Representations, 2021. |
| [17] | YUE J, FANG L Y, XIA S B, et al. Dif-Fusion: toward high color fidelity in infrared and visible image fusion with diffusion models[J]. IEEE Transactions on Image Processing, 2023, 32: 5705–5720. DOI:10.1109/TIP.2023.3322046 |
| [18] | LIU J Y, FAN X, HUANG Z B, et al. Target-aware dual adversarial learning and a multi-scenario multi-modality benchmark to fuse infrared and visible for object detection[C]//Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. New Orleans: IEEE, 2022: 5792 − 5801. |
| [19] | WANG Z S, CHEN Y L, SHAO W Y, et al. SwinFuse: a residual Swin transformer fusion network for infrared and visible images[J]. IEEE Transactions on Instrumentation and Measurement, 2022, 71: 5016412. DOI:10.1109/tim.2022.3191664 |
| [20] | HE K M, ZHANG X Y, REN S Q, et al. Deep residual learning for image recognition[C]//Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition. Las Vegas: IEEE, 2016: 770 − 778. |
| [21] | WANG W H, XIE E Z, LI X, et al. Pyramid vision transformer: a versatile backbone for dense prediction without convolutions[C]//Proceedings of the IEEE/CVF International Conference on Computer Vision. Montreal: IEEE, 2021: 548 − 558. |
| [22] | TANG L F, YUAN J T, ZHANG H, et al. PIAFusion: a progressive infrared and visible image fusion network based on illumination aware[J]. Information Fusion, 2022, 83/84: 79 − 92. |
| [23] | LI H, XU T Y, WU X J, et al. LRRNet: a novel representation learning guided fusion network for infrared and visible images[J]. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023, 45(9): 11040–11052. DOI:10.1109/TPAMI.2023.3268209 |
| [24] | TANG W, HE F Z, LIU Y. YDTR: infrared and visible image fusion via Y-shape dynamic transformer[J]. IEEE Transactions on Multimedia, 2023, 25: 5413–5428. DOI:10.1109/TMM.2022.3192661 |
| [25] | TANG W, HE F Z, LIU Y, et al. DATFuse: infrared and visible image fusion via dual attention transformer[J]. IEEE Transactions on Circuits and Systems for Video Technology, 2023, 33(7): 3159–3172. DOI:10.1109/TCSVT.2023.3234340 |
| [26] | HUANG J, CHEN Z A, MA Y, et al. PTET: a progressive token exchanging transformer for infrared and visible image fusion[J]. Image and Vision Computing, 2024, 144: 104957. DOI:10.1016/j.imavis.2024.104957 |