 2026, Vol. 48
 Issue (3): 63-76


超透镜是一种基于超表面技术的二维亚波长透镜结构[1-2]。相比传统透镜,超透镜能够通过调整几何结构的形状和旋转角度,实现光波波前相位、偏振、振幅等特性的灵活调控,具有体积小,成本低,易于集成等特点,为光学系统小型化、轻量化与集成化的发展趋势提供了潜在的解决方案[3]。目前,已研发出多种功能各异的超透镜,包括消色差超透镜[4]、偏振不敏感超透镜[5]、多焦点超透镜[6]等。其中,多焦点超透镜因为能将入射光同时聚焦于多个位置,在生物医学、成像系统、通信等领域具有重要的研究价值[7-8]。
在传统的设计过程中,通常采用时域有限差分法(finite difference time domain,FDTD)等数值模拟方法对麦克斯韦方程组进行分析求解[9]。该过程需要设计者具备扎实的光学知识与经验积累,同时为了获取特定的响应,往往需要耗费大量的时间与计算成本,并且随着所需响应复杂度的提升,设计成本也将进一步增加。随着计算机硬件与人工智能技术的飞速发展,利用数学工具从目标结果反推对应结构的逆向设计方法逐渐崭露头角[10]。该方法不仅能够提高设计的灵活性和效率,而且在设计复杂结构时,可以有效地降低时间和计算成本。在众多逆向设计方法中,基于神经网络的深度学习可以从超透镜的几何结构和光学响应组成的数据集中探索,学习其中的内在联系,并通过自动调整内部参数来优化性能,具有强大的泛化能力和鲁棒性,在帮助研究者深入理解物理问题的本质方面有重要的作用[11]。
基于深度学习的超透镜逆向设计可追溯到2018年,Malkiel团队针对“H”形金纳米单元结构设计了两套深度神经网络(deep neural network, DNN),其中一套用于前向预测光谱,另一套用于逆向预测结构参数,从而高效且准确地获得预测的光谱和结构[12]。此外,该研究还尝试将两套网络串联起来,通过将逆向网络得到的结构参数输入到前向网络中来训练预测光谱的能力,取得了比分开训练更好的效果。该研究为后续超透镜的逆向设计奠定了基础。此后,研究者们尝试用多种不同的神经网络实现了超透镜功能和应用上的逆向设计[13-15]。
当前,逆向设计研究主要聚焦于超透镜单一功能和应用的实现,因此,利用神经网络实现具备复合功能和应用的超透镜逆向设计具有重要的研究价值。针对该问题,本文提出了一种基于串联神经网络(tandem neural network, TNN)的多焦点超透镜逆向设计方法。基于该网络模型,本文开展了单焦点超透镜、双焦点超透镜和多焦点超透镜的逆向设计工作,并通过仿真实验验证了该技术方法的可行性。
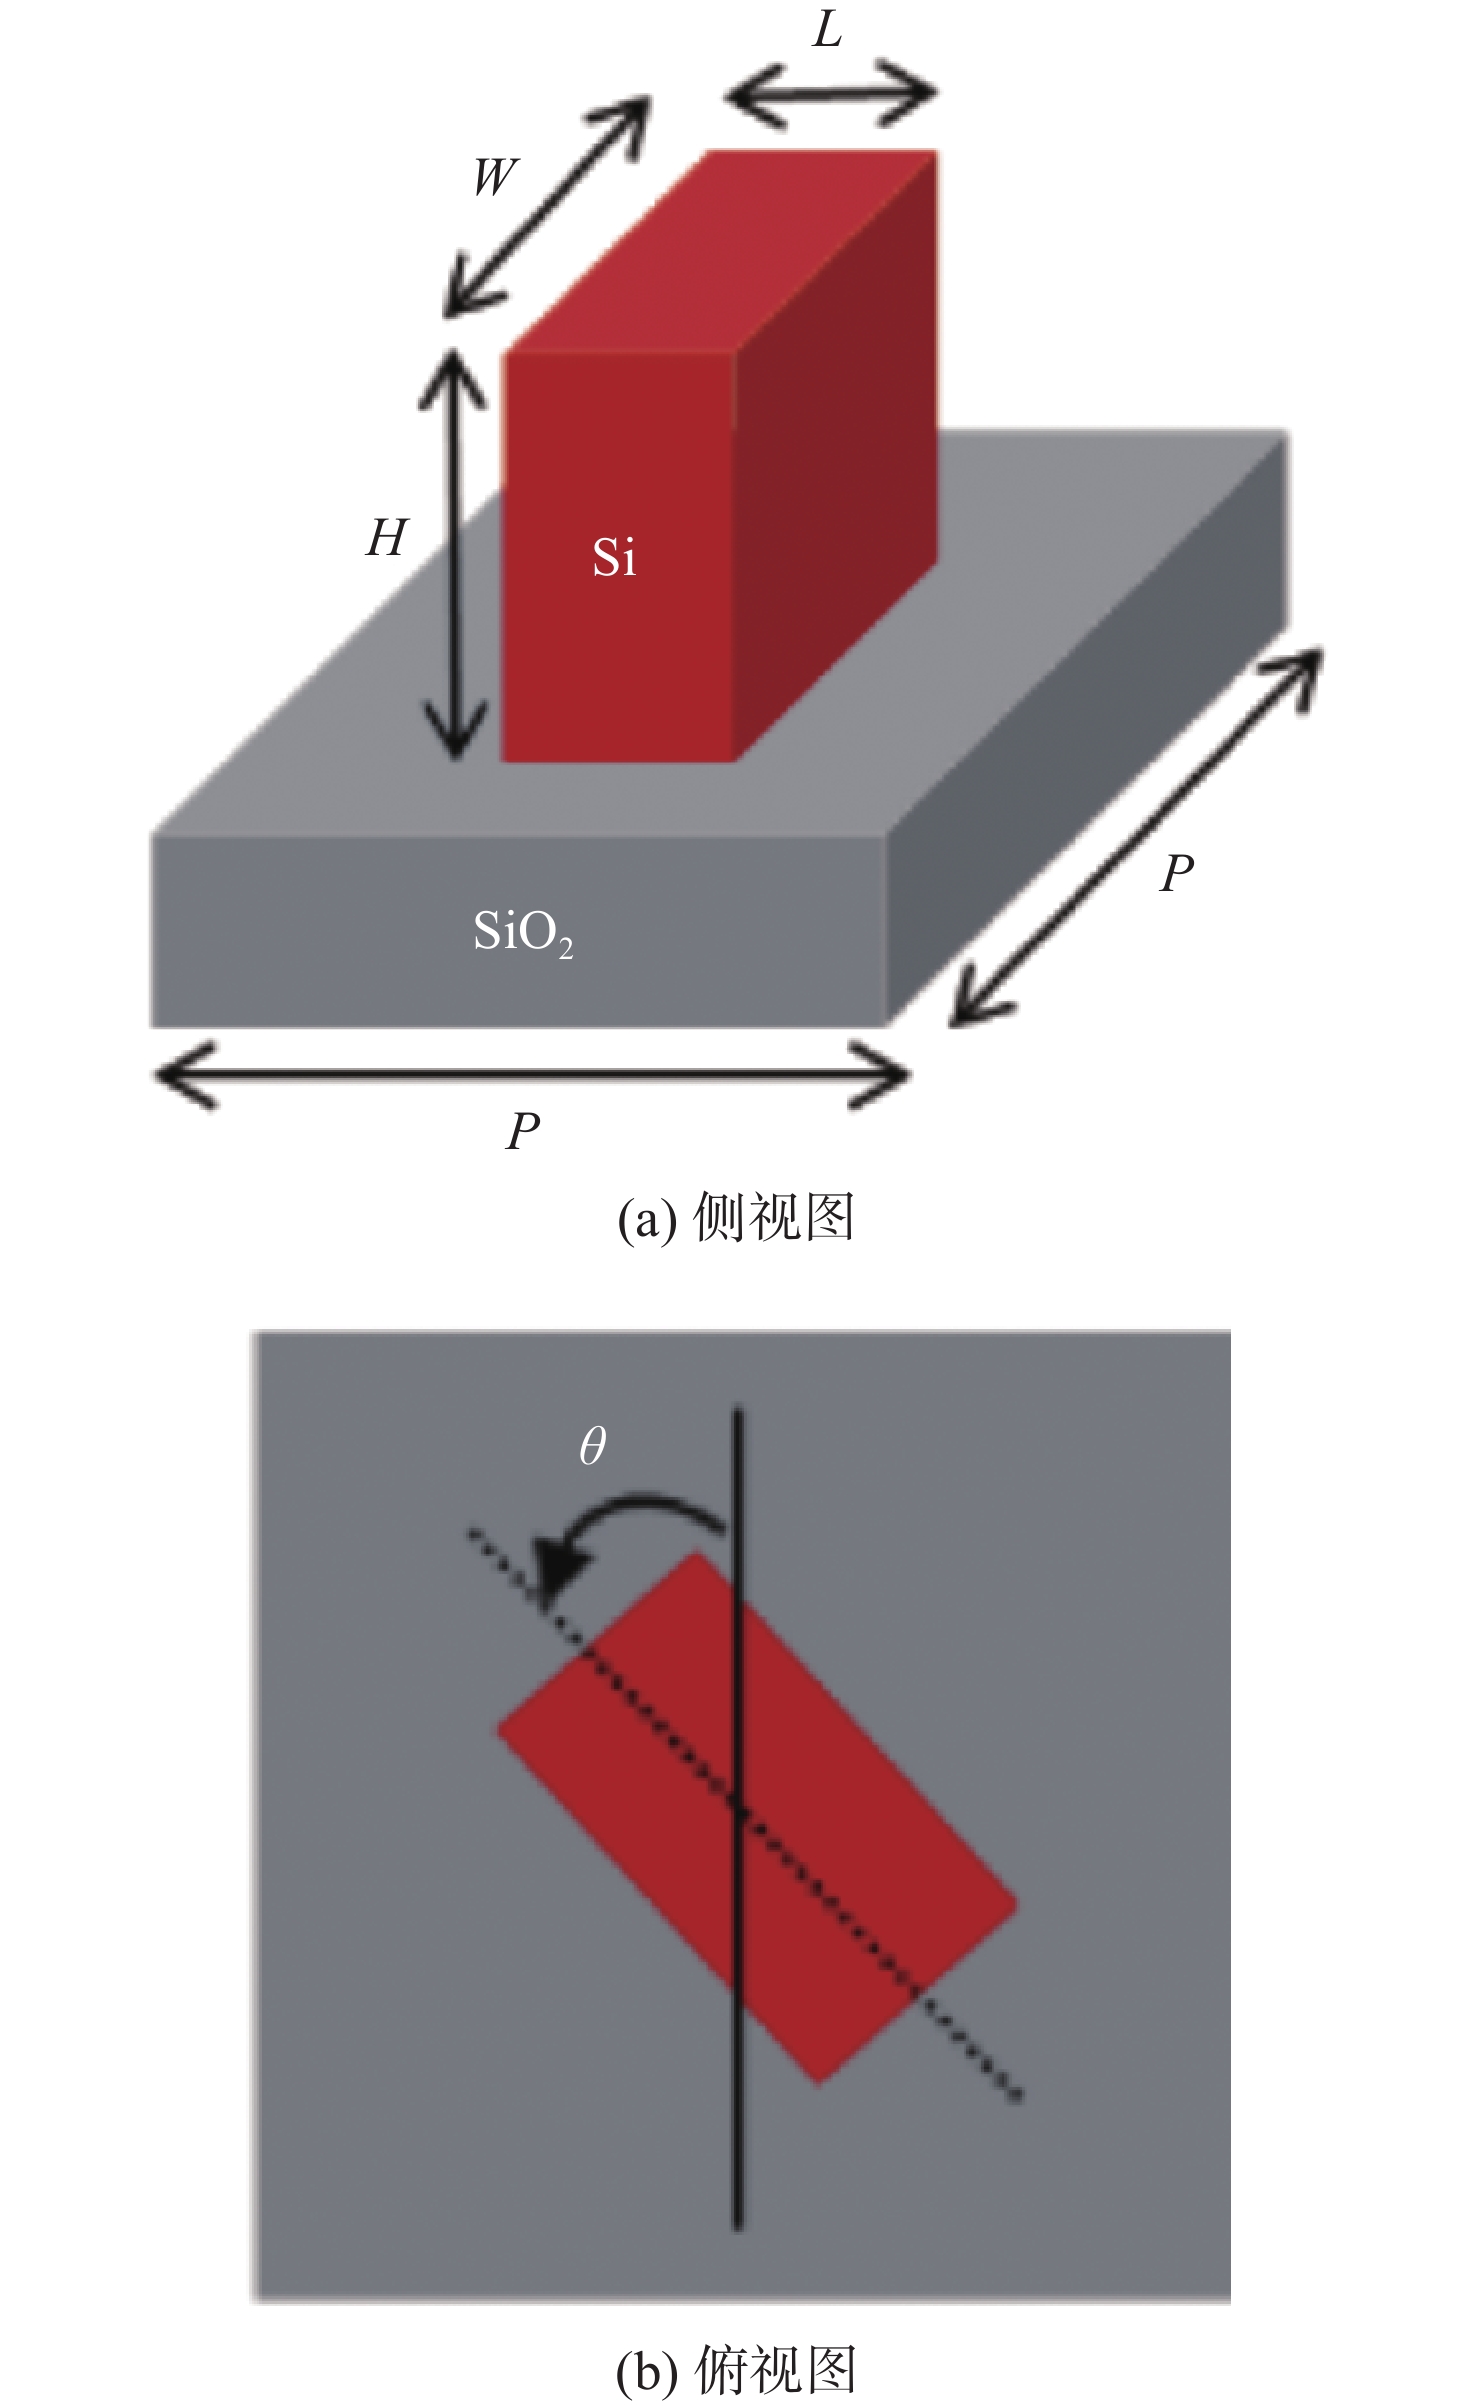
1 超透镜原理与逆向设计算法 1.1 超透镜衍射单元设计如图1所示,超透镜衍射单元采用方柱结构[16]。方柱由折射率为3.882的硅(silicon, Si)材料构成,衬底采用折射率为1.5的二氧化硅(silicon dioxide, SiO2)材料。选择高折射率的硅有助于实现光场的局域振荡,增强相位补偿,同时低折射率的二氧化硅有利于减少入射光的反射。衍射单元结构设计包括5个参数:单元周期P,方柱高度H、长度L、宽度W和旋转角度
|
图 1 FDTD衍射单元仿真结构参数示意图 Figure 1 The schematic diagram of the diffractive unit structure in FDTD |
为了实现超透镜的多焦点成像,本文采用复合相位调制的原理,即结合传输相位调制与几何相位(Pancharatnam-Berry,PB)调制技术[17-18]。一方面,利用几何相位光场的控制可独立依赖于入射光偏振态,即左旋圆偏振( left-circularly polarized,LCP )光和右旋圆偏振( right-circularly polarized,RCP )光。另一方面,传输相位与入射光的波长、材料折射率相关,与偏振或自旋态无关。因此可以通过调整几何结构的尺寸来调控传输相位,实现焦点强度的控制。
假设超透镜表面为x-y平面,垂直方向为z轴,超透镜的中心点为
| $ \left\{\begin{split}& \varphi \left(x,y,0\right) = -\frac{2\text{π} }{\lambda }\left( \sqrt{{\left(x-{{x}_{f}}\right)}^{2}+{\left(y-{{y}_{f}}\right)}^{2}+{\textit z}_{f}^{2}}-f\right)\\& f=\sqrt{x_{f}^{2}+y_{f}^{2}+{\textit z}_{f}^{2}} \end{split} \right.$ | (1) |
式中,λ是工作波长。通过式(1)可以计算出目标位置获得焦点所需的相位分布。为实现复合相位调制,旋转角度
| $ \left\{\begin{split}& {\varphi }_{\mathrm{L}/\mathrm{R}}=\varphi _{\mathrm{L}/\mathrm{R}}^{\mathrm{Pro}}+\varphi _{{}^{\mathrm{L}/\mathrm{R}}}^{\mathrm{PB}}\\& {\varphi }^{\mathrm{Pro}}=\varphi _{\mathrm{L}}^{\mathrm{Pro}}+\varphi _{\mathrm{R}}^{\mathrm{Pro}}\\& \varphi _{\mathrm{L}}^{\mathrm{PB}}=-\varphi _{\mathrm{R}}^{\mathrm{PB}}=2\theta \end{split} \right. $ | (2) |
由此可得
| $ \left\{\begin{split}& {\varphi }^{\mathrm{Pro}}=\frac{{\varphi }_{\mathrm{L}}+{\varphi }_{\mathrm{R}}}{2}\\& \theta =\frac{{\varphi }_{\mathrm{L}}-{\varphi }_{\mathrm{R}}}{4} \end{split} \right. $ | (3) |
式(3)表明所需的传播相位与旋转角度可通过计算LCP光与RCP光入射时衍射单元所需的总相位来获得。考虑到几何相位的调制需求,衍射单元沿x轴和y轴的相位延迟
| $ \left\{\begin{split}& |{\varphi }_{x}-{\varphi }_{y}|=\text{π} \\& {\varphi }_{x}={\varphi }^{\mathrm{Pro}} \end{split} \right. $ | (4) |
因此
| $ \left\{\begin{split}& {\varphi }_{x}=\text{angle}\left({\mathrm{e}}^{\mathrm{i}{{\varphi }^{\mathrm{Pro}}}}\right)\\& {\varphi }_{y}=\text{angle}[{\mathrm{e}}^{\mathrm{i}\left({{\varphi }^{\mathrm{Pro}}}+\text{π} \right)}] \end{split} \right. $ | (5) |
通过上述计算,便可求得神经网络所需实现的相位分布目标,并以此为基础,将计算得到的
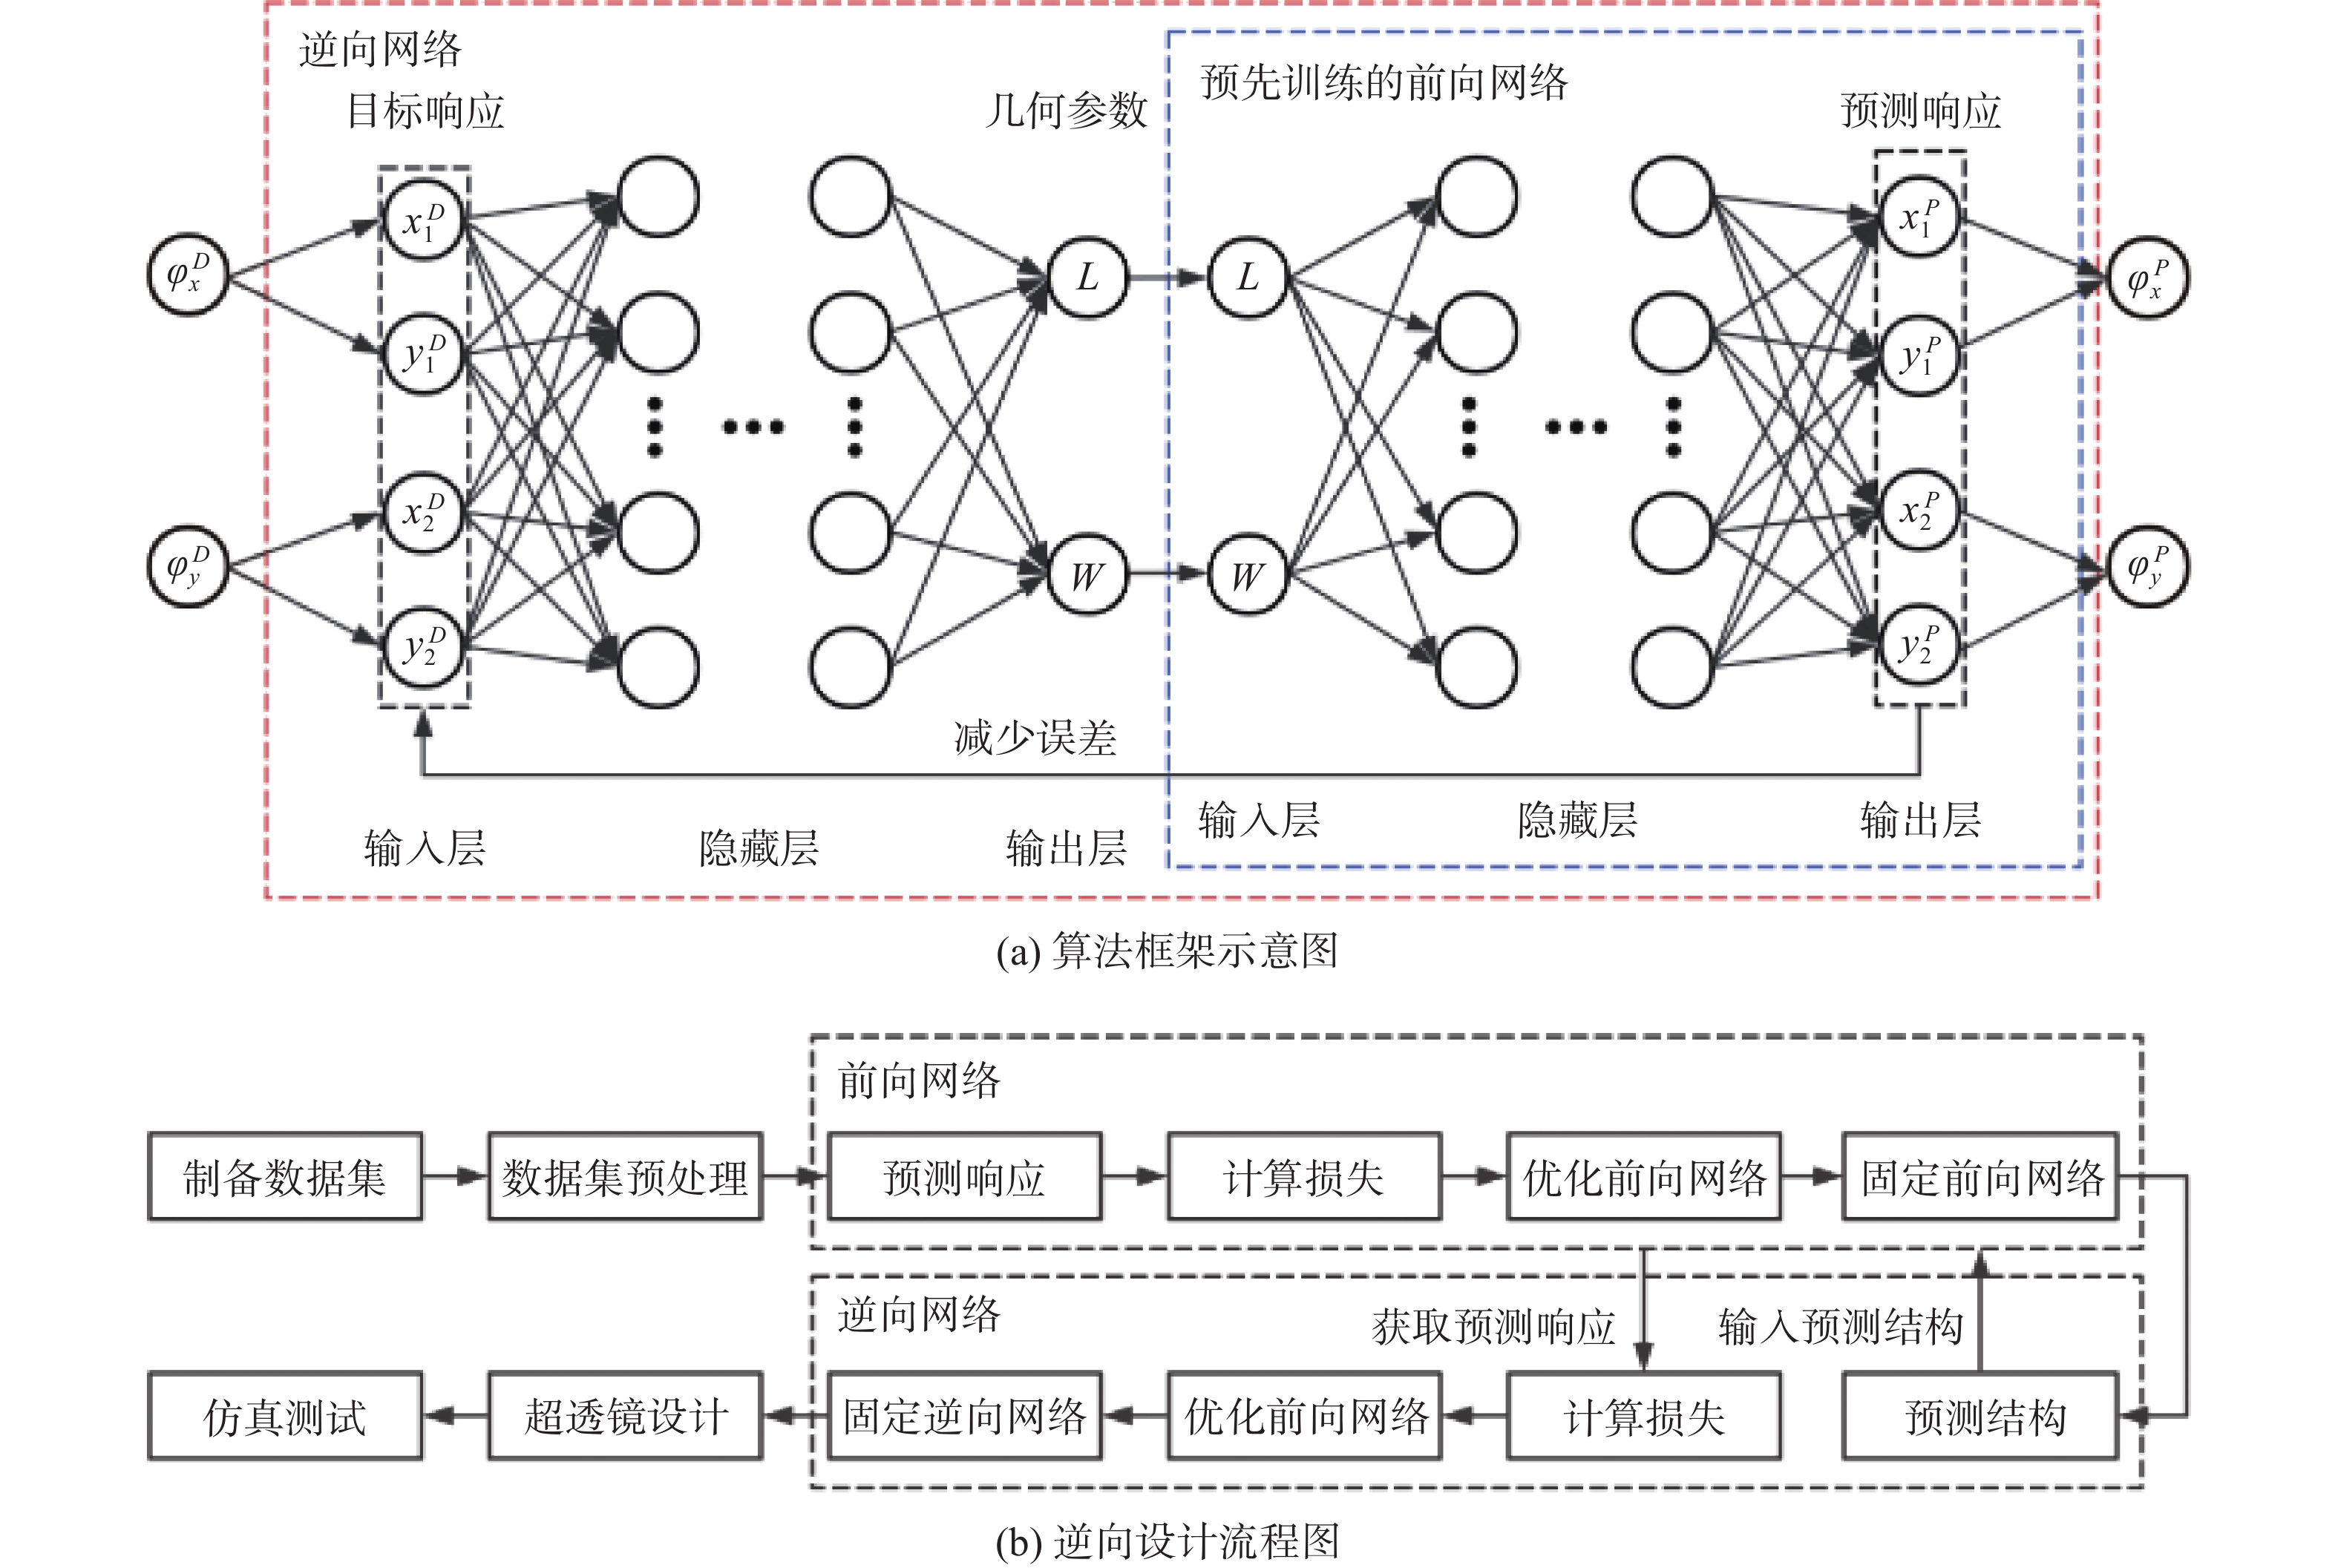
本文构建串联神经网络(tandem neural network, TNN)算法进行逆向设计,算法框架如图2(a)所示[20-21]。其中,
|
图 2 串联神经网络TNN的算法框架示意图和逆向设计整体流程图 Figure 2 The schematic diagram of the framework of the tandem neural network and the total flowchart of the inverse design |
经过测试分析,前向网络隐藏层节点数分别设定为100、250、300、250和100,输出层选用Tanh函数作为非线性激活函数以确保输出值被限制在−1到1之间,而逆向网络隐藏层节点数同样分别设定为100、250、300、250和100,输出层采用Softplus函数作为非线性激活函数,保证输出恒大于0,即确保几何参数的合理性,此时可以获得较为可靠的结果。权重初始化采用均值为0,标准差为0.1的正态分布,确保权重初始值在一个合理的范围内,既不会过大也不会过小,避免反向传播中的梯度爆炸或梯度消失问题,有助于保持梯度的稳定性,并且正态分布的随机初始化可以避免不同神经元可能会在训练过程中学习到相同的特征,确保每个神经元在训练初期学习到不同的特征。偏置项初始值设置为常数0,避免在网络训练初期引入不必要的偏差,简化网络的初始状态,确保训练初期的输出不会受到偏置的干扰。通过把5组随机划分的数据集作为样本,在前向网络中进行测试,批次大小分别为10、20、50时,对应最佳损失平均值为
对神经网络权重与偏置进行优化的优化器算法部分选择了结合自适应学习率优化算法和动量算法的Adam优化器,在实现简单高效计算的同时,也减少了对内存的需求。在初始学习率上通过前述相同的样本测试,初始学习率为默认值0.001、0.01、
| $ f\left(x\right)=\left\{\begin{split}& x & x {{>}} 0\\& \alpha x & x{{≤}} 0 \end{split} \right. $ | (6) |
式中,
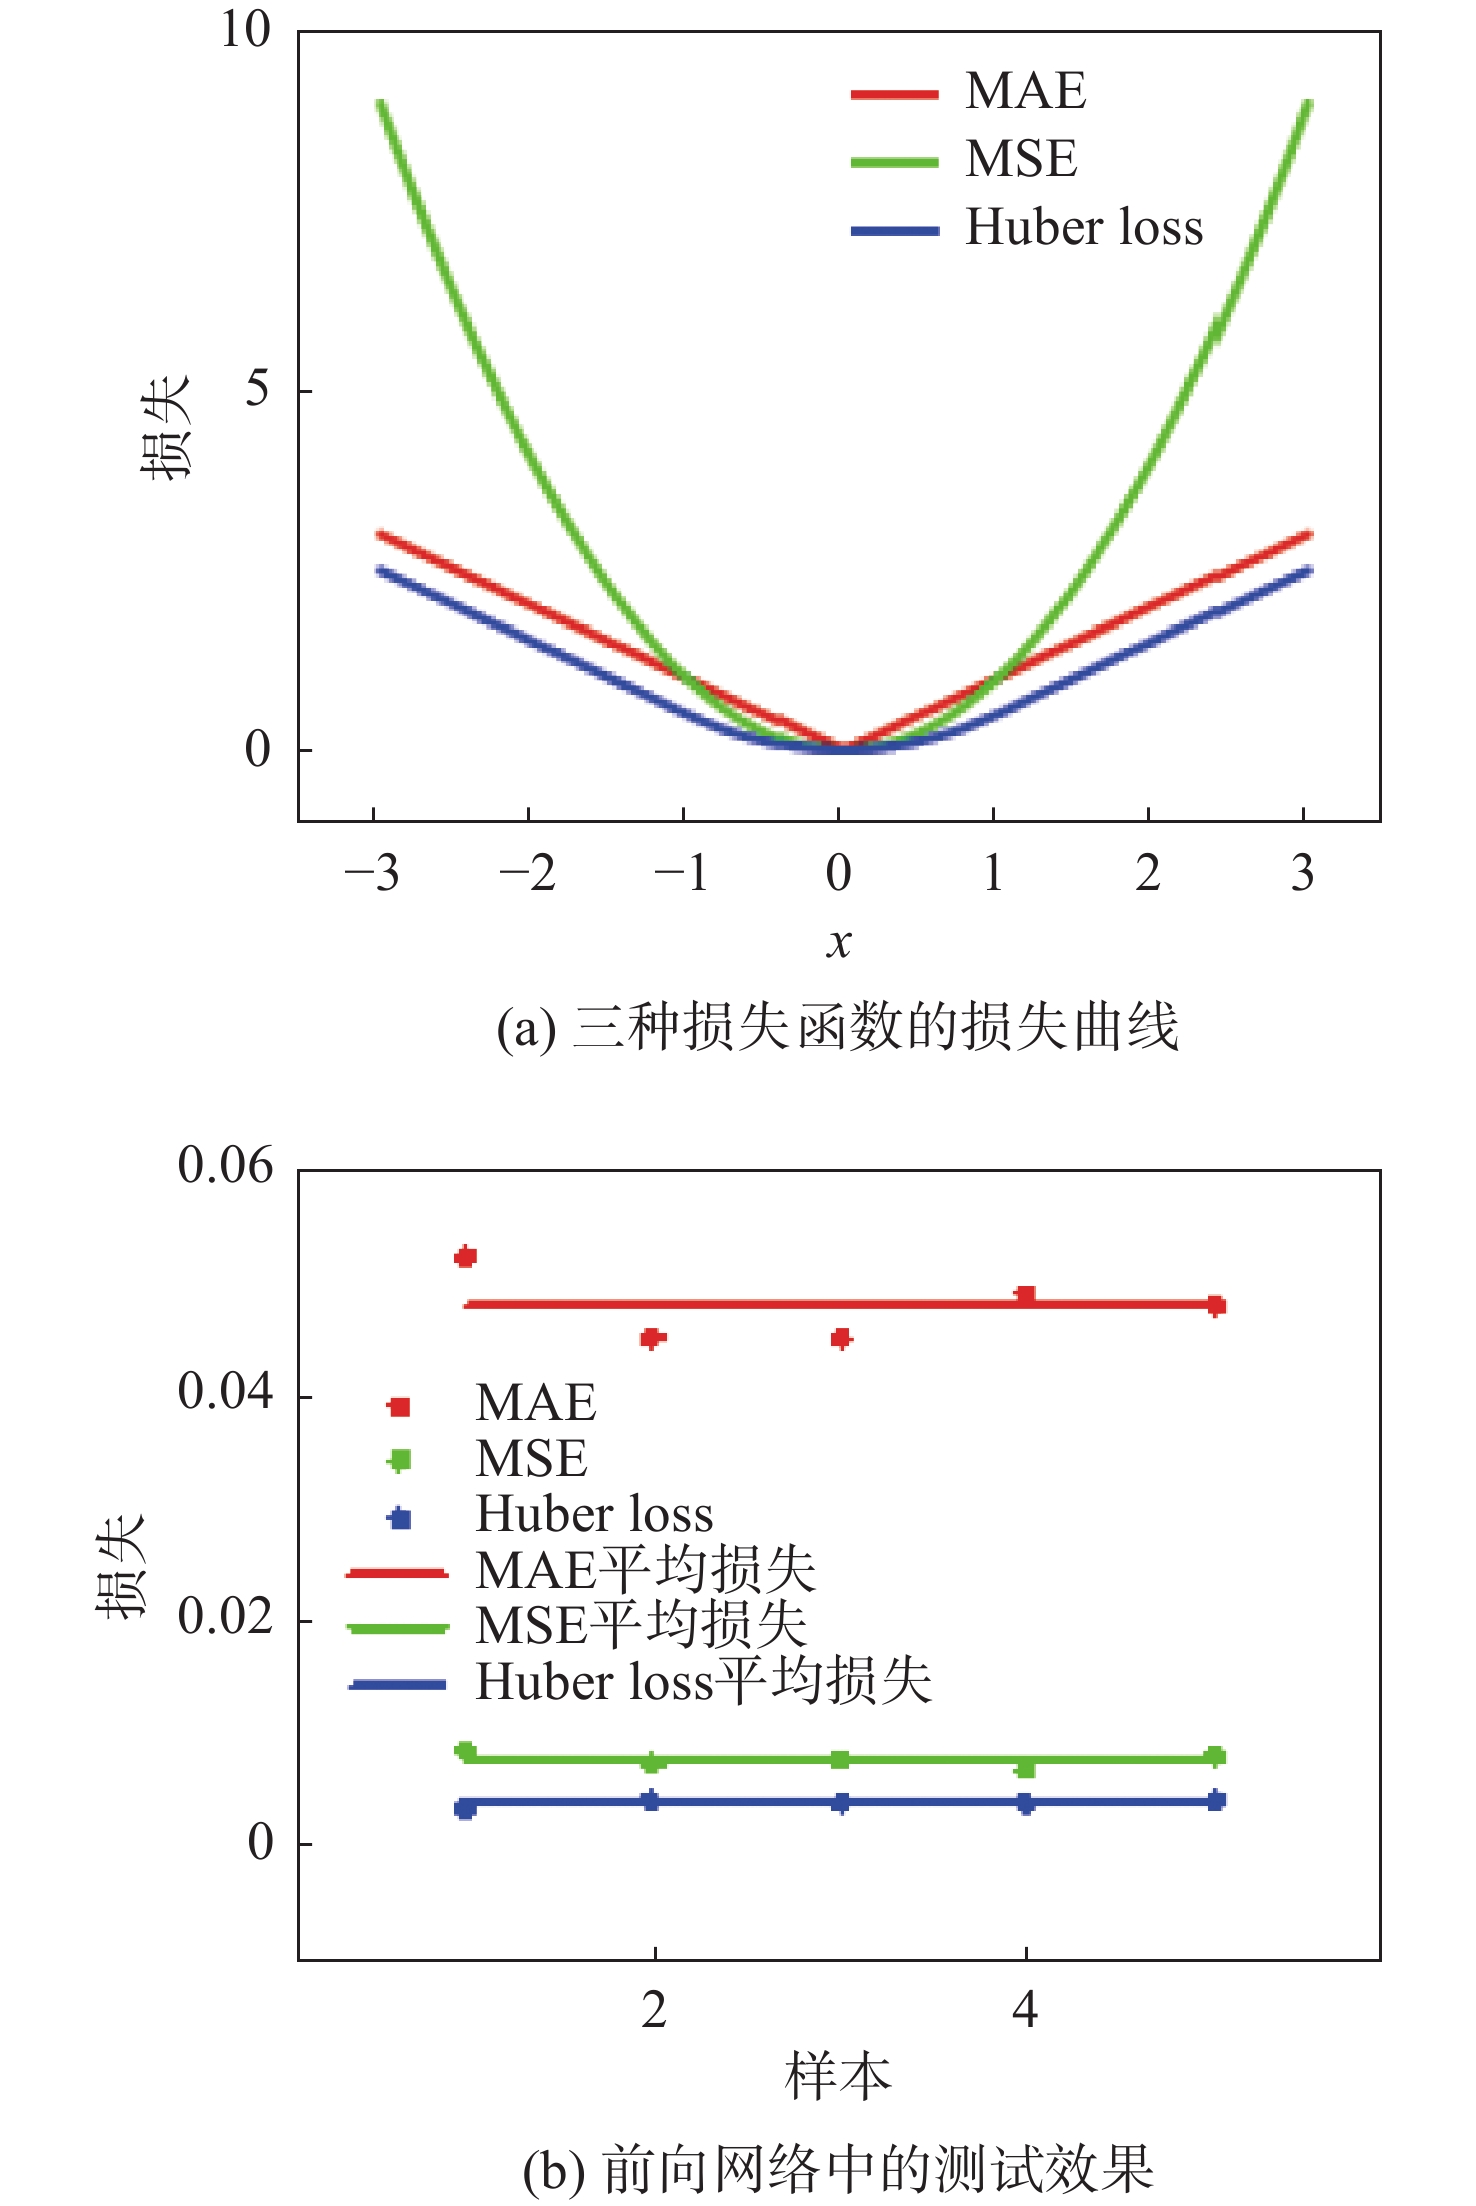
神经网络训练的目的是使预测值尽可能接近真实值,损失函数将神经网络所有样本的预测值和真实值作为输入,输出一个标量作为反映预测值与真实值之间的总体差异,这个标量被称为损失。损失是衡量神经网络在整个数据集上预测不准确性的总体指标,通常在训练中将最小化损失作为目标来优化参数,从而改进预测性能。本文的损失函数选择Huber Loss函数,也被称作SmoothL1函数。该函数可以灵活适应不同数据集的训练需求[24]。其表达式为
| $ { Huber\; Loss }=\frac{1}{n} \sum_{i=1}^n \left\{\begin{split}&\frac{1}{2}\left(Y_i-\hat{Y}_i\right)^2\;\;\quad \left|Y_i-\hat{Y}_i\right| {{≤}} \delta \\& \delta\left|Y_i-\hat{Y}_i\right|-\frac{1}{2} \delta \;\; \left|Y_i-\hat{Y}_i\right|{{>}} \delta\end{split}\right. $ | (7) |
式中:n是样本数;
|
图 3 Huber Loss 和MAE、MSE的效果对比 Figure 3 The comparison of the effect of Huber Loss and MAE, MSE |
模型最大训练周期(Epoch,训练集内所有样本均训练一次的过程,即样本内所有批次完成一次迭代训练的过程)设置为500,并采取一定耐心值(Patience,训练过程中对性能变化的耐心程度,决定了在多少个训练周期后,性能仍未得到改善时,停止网络训练)的早停机制来防止过拟合现象,同时缩短训练时间。耐心值过小时,网络可能陷入局部最小值而没有充分优化,导致欠拟合;耐心值过大或取消耐心值时,网络会继续训练很长时间,但性能已经不再提升,浪费计算资源。通过前述的样本,在前向网络中测试,耐心值为10,最佳损失平均值为
逆向设计的整体流程如图2(b)所示,首先利用MATLAB软件生成
在获取数据集后,利用MATLAB对数据进行预处理。通过三角关系,将
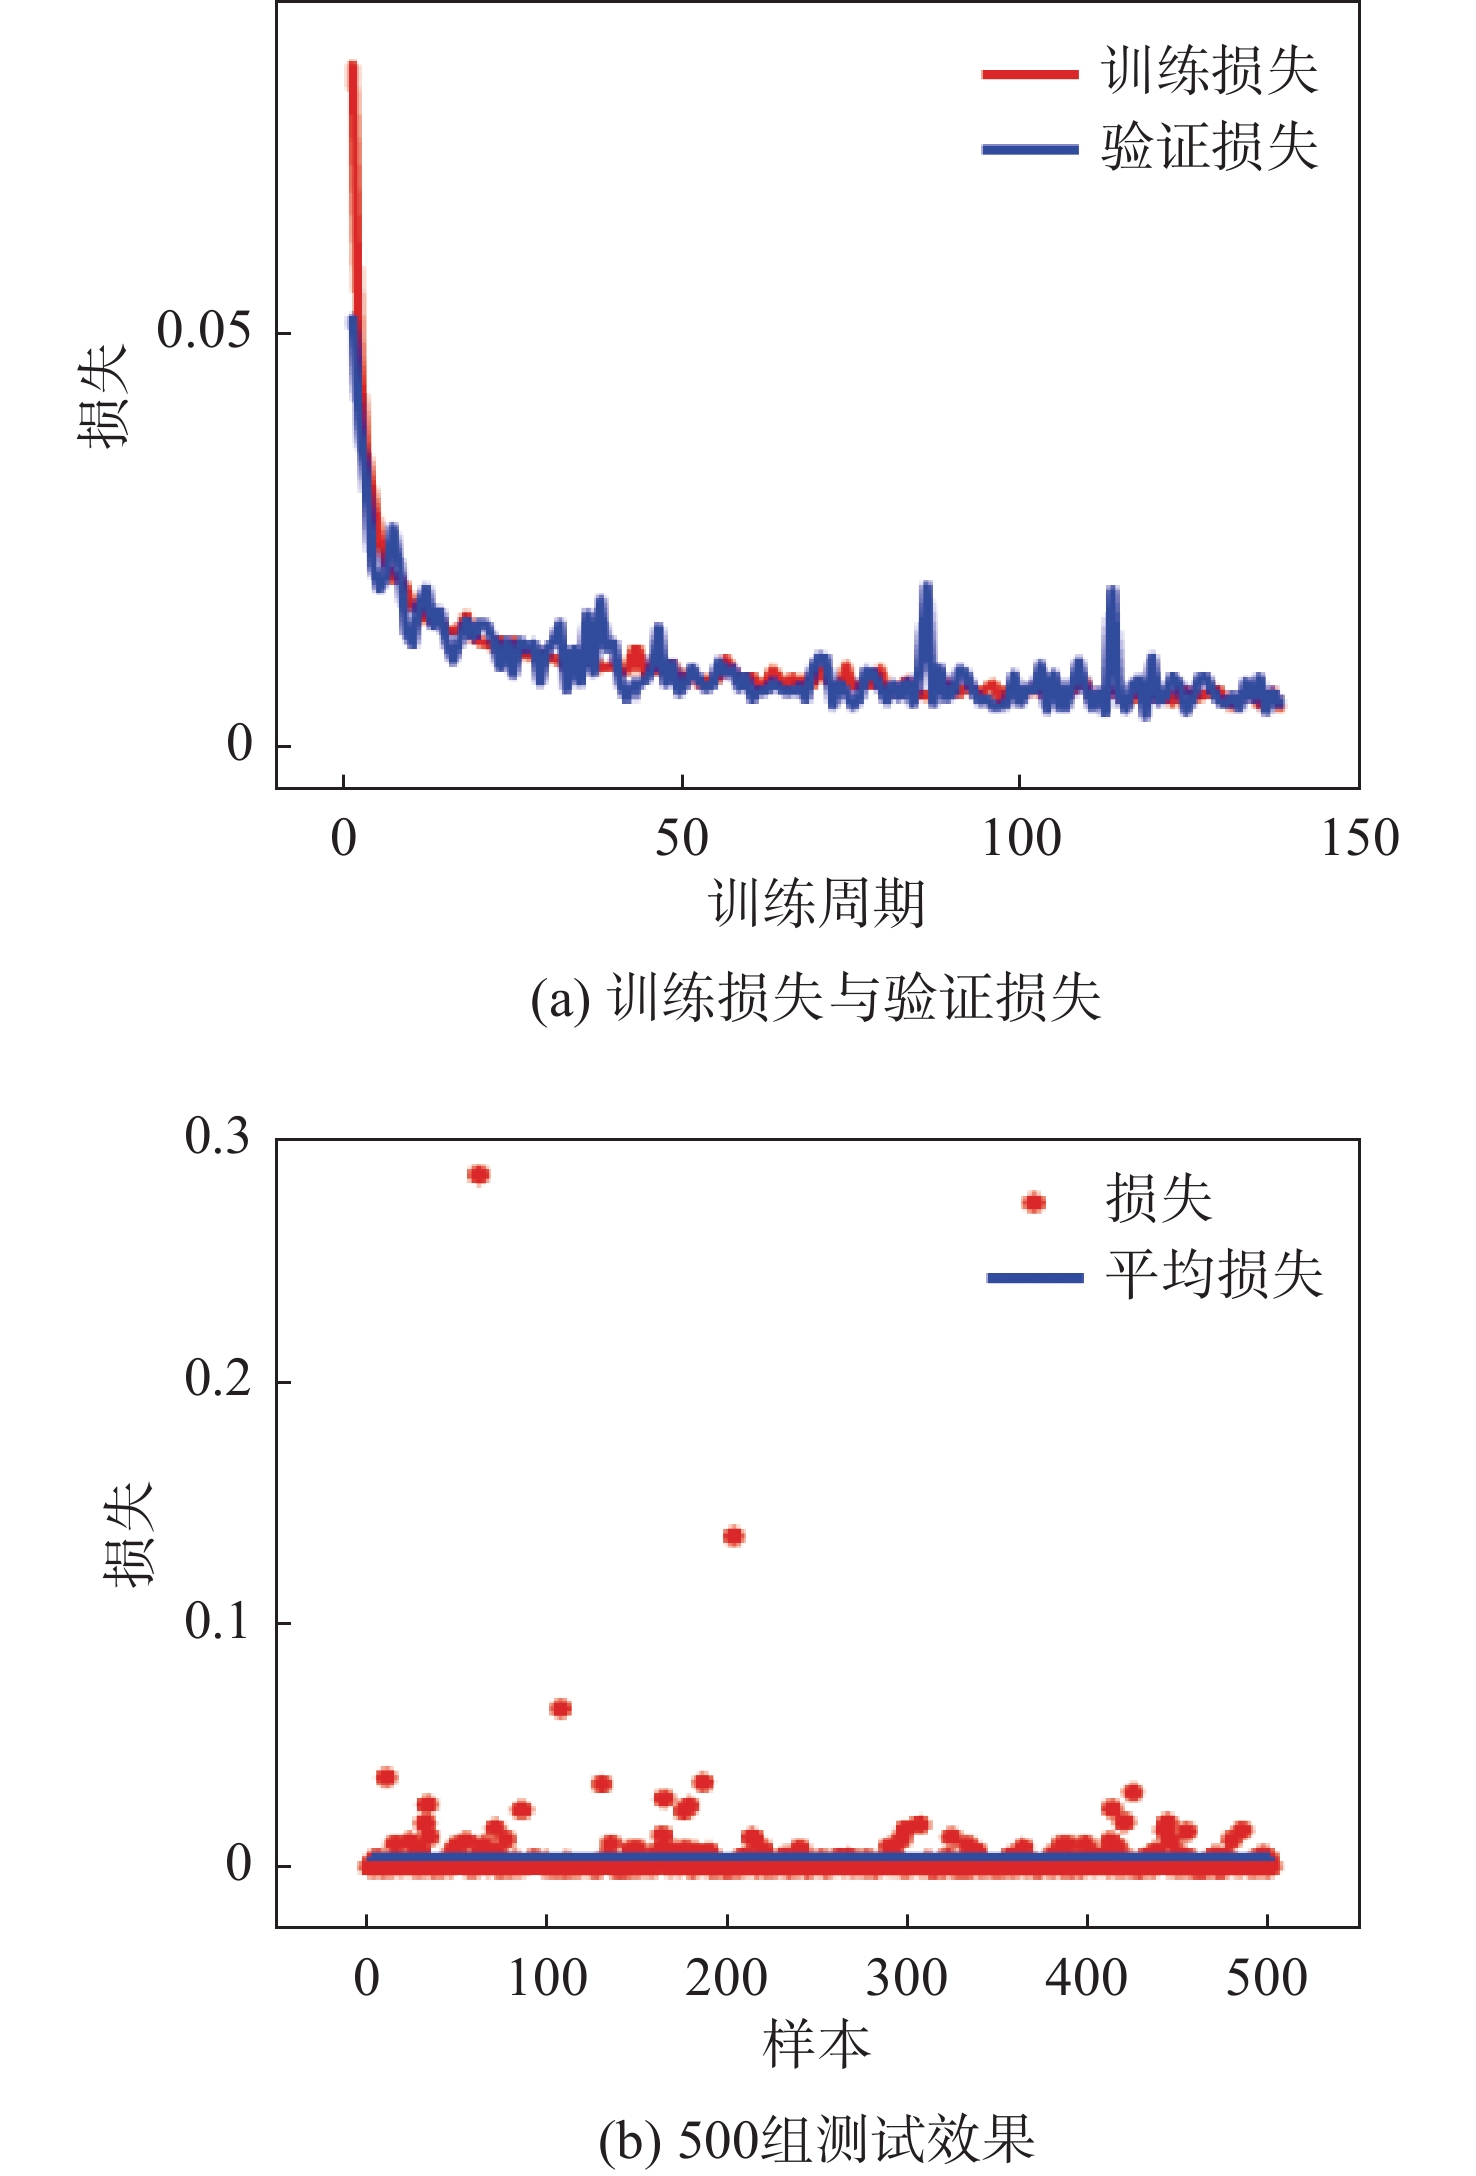
在训练过程中,
|
图 4 前向网络训练效果 Figure 4 The training effect of the forward network |
在完成对前向网络训练后,将前向网络的权重和偏置固定,然后展开对逆向网络的训练。将规模大小为
| $ Loss\mathrm{_{inverse}}=Huber\ Loss\left(R\mathrm{^{real}}-R^{\mathrm{pred}}\right) $ | (8) |
式中:
|
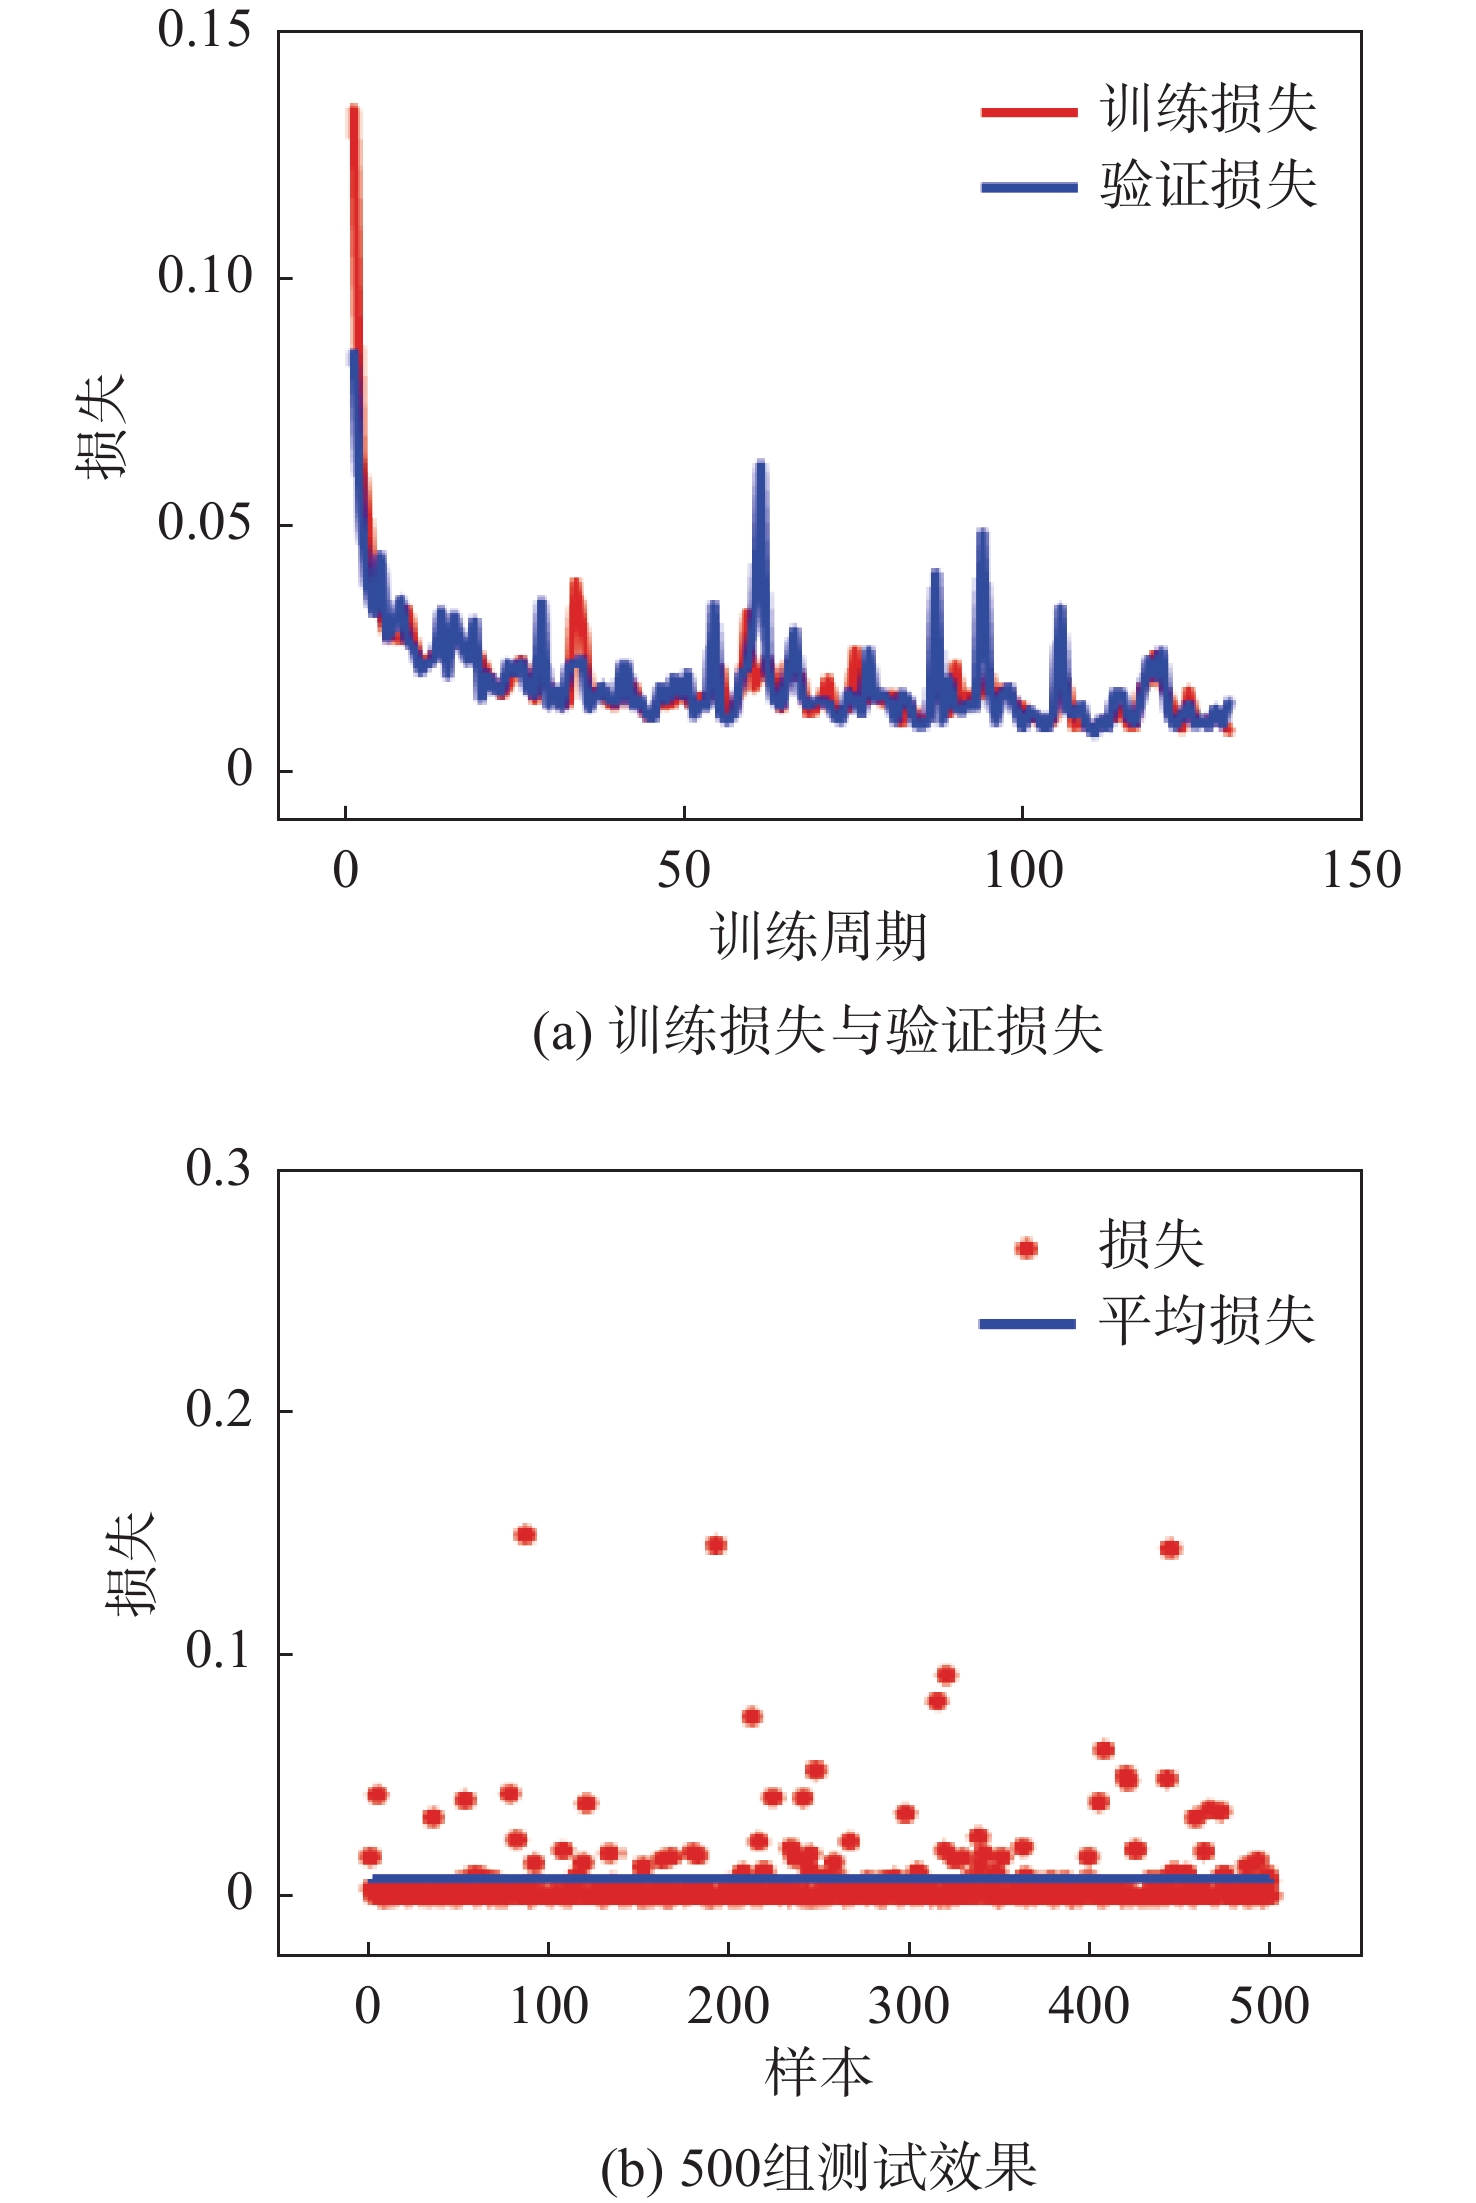
图 5 逆向网络训练效果 Figure 5 The training effect of the inverse network |
鉴于实际运行的训练周期数,导致整体曲线呈现非平滑的特性,同时由于逆向设计的训练依赖于前向网络的预测结果,前向网络的误差会传递到逆向网络中,逆向设计涉及到的解空间更大,且可能存在多个局部最优解,导致训练过程更加不稳定,因此损失值更为显著,误差也相对前向网络较高。此外,虽然网络整体上表现良好,但在某些特定样本上可能由于参数调整仍旧不够精细,训练过程中的随机性等原因,导致预测值与真实值偏差较大。在生成训练数据时,仿真也可能会引入一定的数值误差,这些误差在训练过程中会被神经网络学习,导致某些样本的预测值与真实值偏差较大。测试集中的部分样本可能具有特殊的特征,如相位分布极端等,但在训练集中出现频率较低,导致网络在处理这些样本时表现不佳。最后Huber Loss函数虽然对离群点有一定的鲁棒性,但当偏差较大时,仍会导致损失值显著增加。在完成逆向网络的训练后,即可着手进行超透镜结构的仿真设计工作。
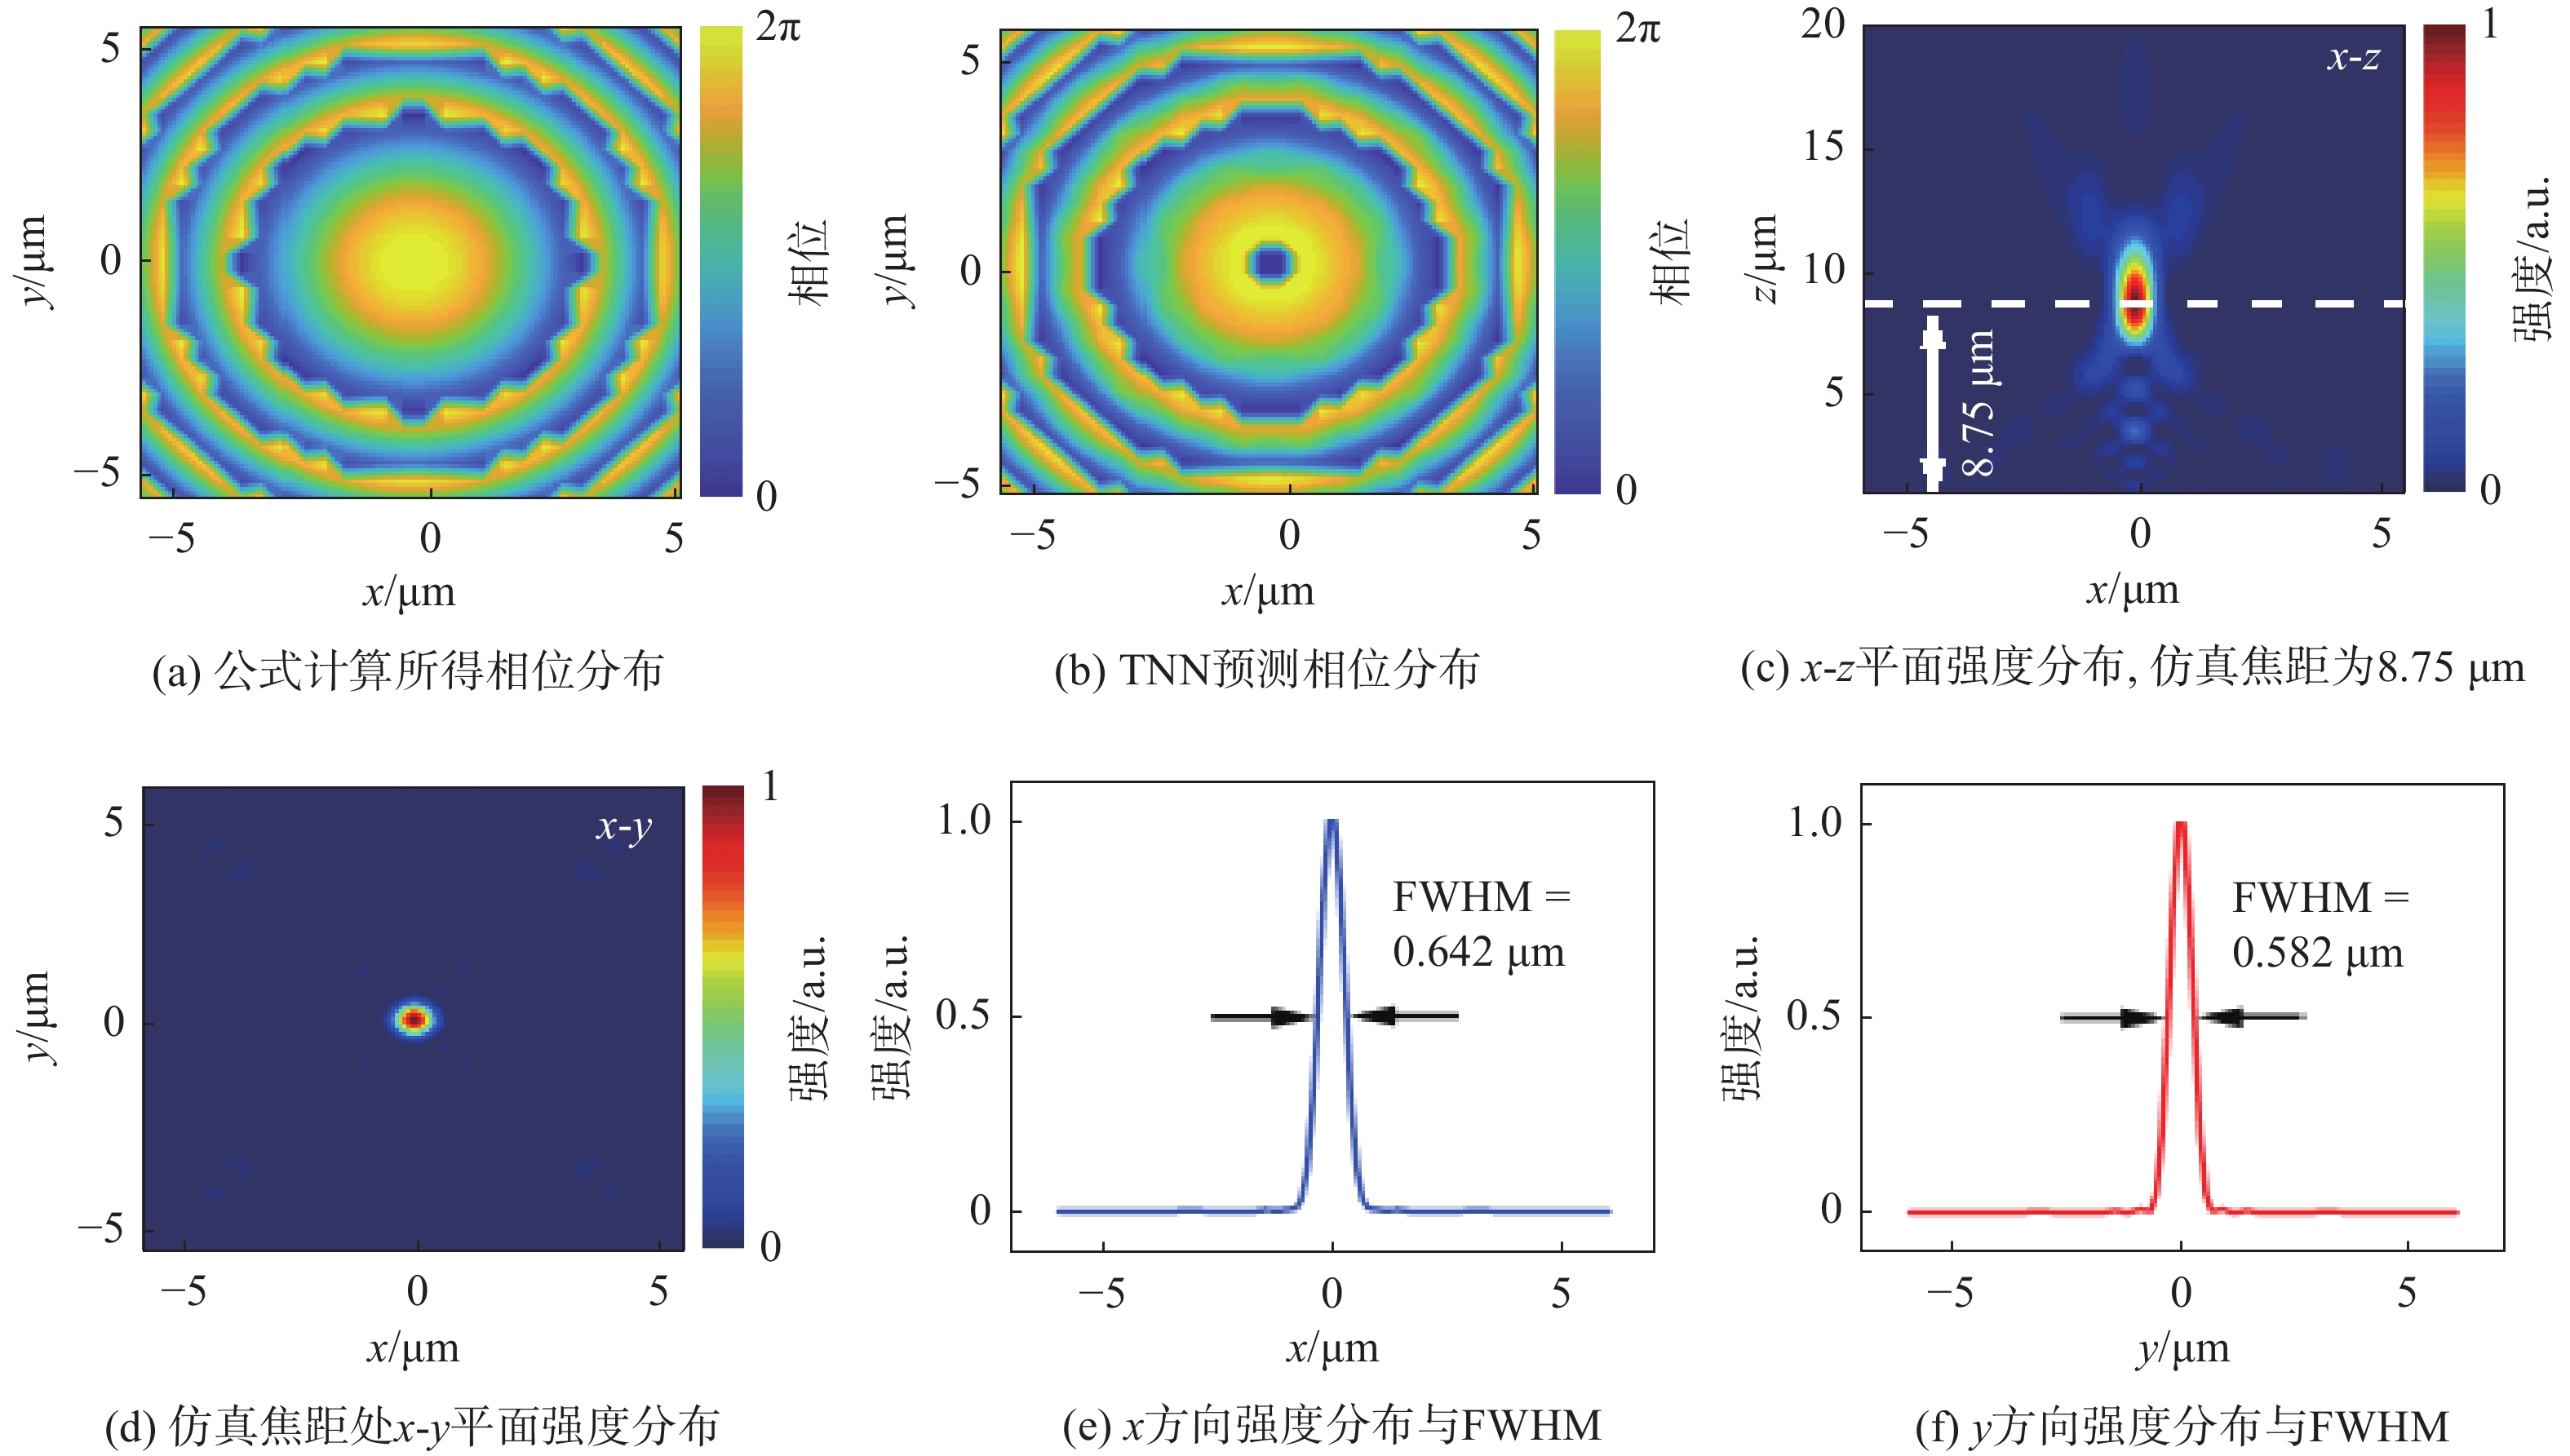
2 结果与分析 2.1 单焦点超透镜设计为了验证TNN在仿真设计中的可行性,首先选取单焦点超透镜作为设计对象。在该超透镜中,由于可以仅依靠传输相位调制,即调整结构的尺寸,因此不需要改变旋转角度,可以相对直观地观察到由网络生成的结构对聚焦效果带来的影响。该超透镜的横向与纵向周期为28,直径为11.2 µm,工作波长为632 nm,设计目标是实现9 µm的焦距。首先图6(a)和图6(b)为通过公式计算获得的相位分布与通过网络生成结构对应的预测相位。可以观察到,预测相位分布整体上已趋近于目标分布,但由于在0到2π的相位区间内,目标相位中心区域的数值已趋近于其上限值。受两套网络误差的综合影响,预测所得相位中心区域的数值突破了上限阈值,经函数映射后,数值跌落至接近下限的区域,从而引发了数值的急剧下降,形成了一个局部的低谷。通过对预测相位和目标相位的数值计算,误差控制在6.3%以下,表明网络在预测过程中存在一定的偏差,这种偏差会对后续仿真结果的准确性产生一定影响。由此可见,当前网络设计在精度和鲁棒性方面仍有较大的优化空间,未来可通过改进网络结构、优化训练策略以及引入物理约束等方法进一步提升其性能。
|
图 6 波长为632 nm时,目标焦距为9 µm单焦点超透镜相位预测与仿真结果 Figure 6 The phases’ prediction and the simulation result of the monofocal metalens with the target focal length of 9 µm at the wavelength of 632 nm |
图6(c)至图6(f)展示了通过Lumerical FDTD软件进行仿真得到的结果。图6(c)显示在x-z平面上,光束在9 µm附近实现了有效焦距,计算所得仿真焦距为8.75 µm,与目标焦距间的误差约为2.7%。此外,图6(d)显示在该高度的x-y平面上,实现了强聚焦,形成一个聚焦光斑,这表明该超透镜所受串扰影响不显著。在评估超透镜性能时,通常会使用半峰全宽(full width at half maximum, FWHM)和聚焦效率进行分析。FWHM是指强度为波峰峰值最大值一半处的波长差,反映了超透镜的分辨率与稳定性。聚焦效率定义为焦点处的光强与入射光总能量之比,反映了超透镜聚焦于特定点的能力。聚焦光斑的光场分布一般呈高斯分布,在高斯分布中,大约99.7%的能量集中在峰值附近的3倍标准差范围内。由于在超透镜中,FWHM可以直接从光强分布中测量,不需要复杂的拟合过程,因此聚焦效率可以通过计算3倍FWHM半径平面区域内入射能量与入射光总量的比值获得。如图6(e)和图6(f)所示,在该高度处,x和y方向上,电场强度在焦点处达到峰值,呈现高斯分布特性,经过计算,FWHM分别为0.642 µm 和0.582 µm,聚焦效率达到 60.6%。通过调整仿真空间规模、网格精度、光源高度和监视器高度等仿真参数,仿真焦距和FWHM未发生显著变化,聚焦效率与原聚焦效率间的仿真误差低于10%,这表明该超透镜在仿真条件下具有较高的稳定性,仿真软件引入的误差对结果影响较小。考虑实际制造中尺寸会存在5 nm的公差,因此在仿真过程中,对衍射单元引入5 nm的公差进行测试,仿真焦距和FWHM同样未发生显著变化,聚焦效率与原聚焦效率间的仿真误差低于4.2%,表明该超透镜可以容忍一定的制造公差。除了神经网络预测误差外,其他潜在的影响因素包括未充分考虑衍射单元本身的透射率以及材料折射率对成像效果的影响。尽管如此,实验结果验证了TNN在传输相位设计中的有效性,为进一步优化设计提供了基础。
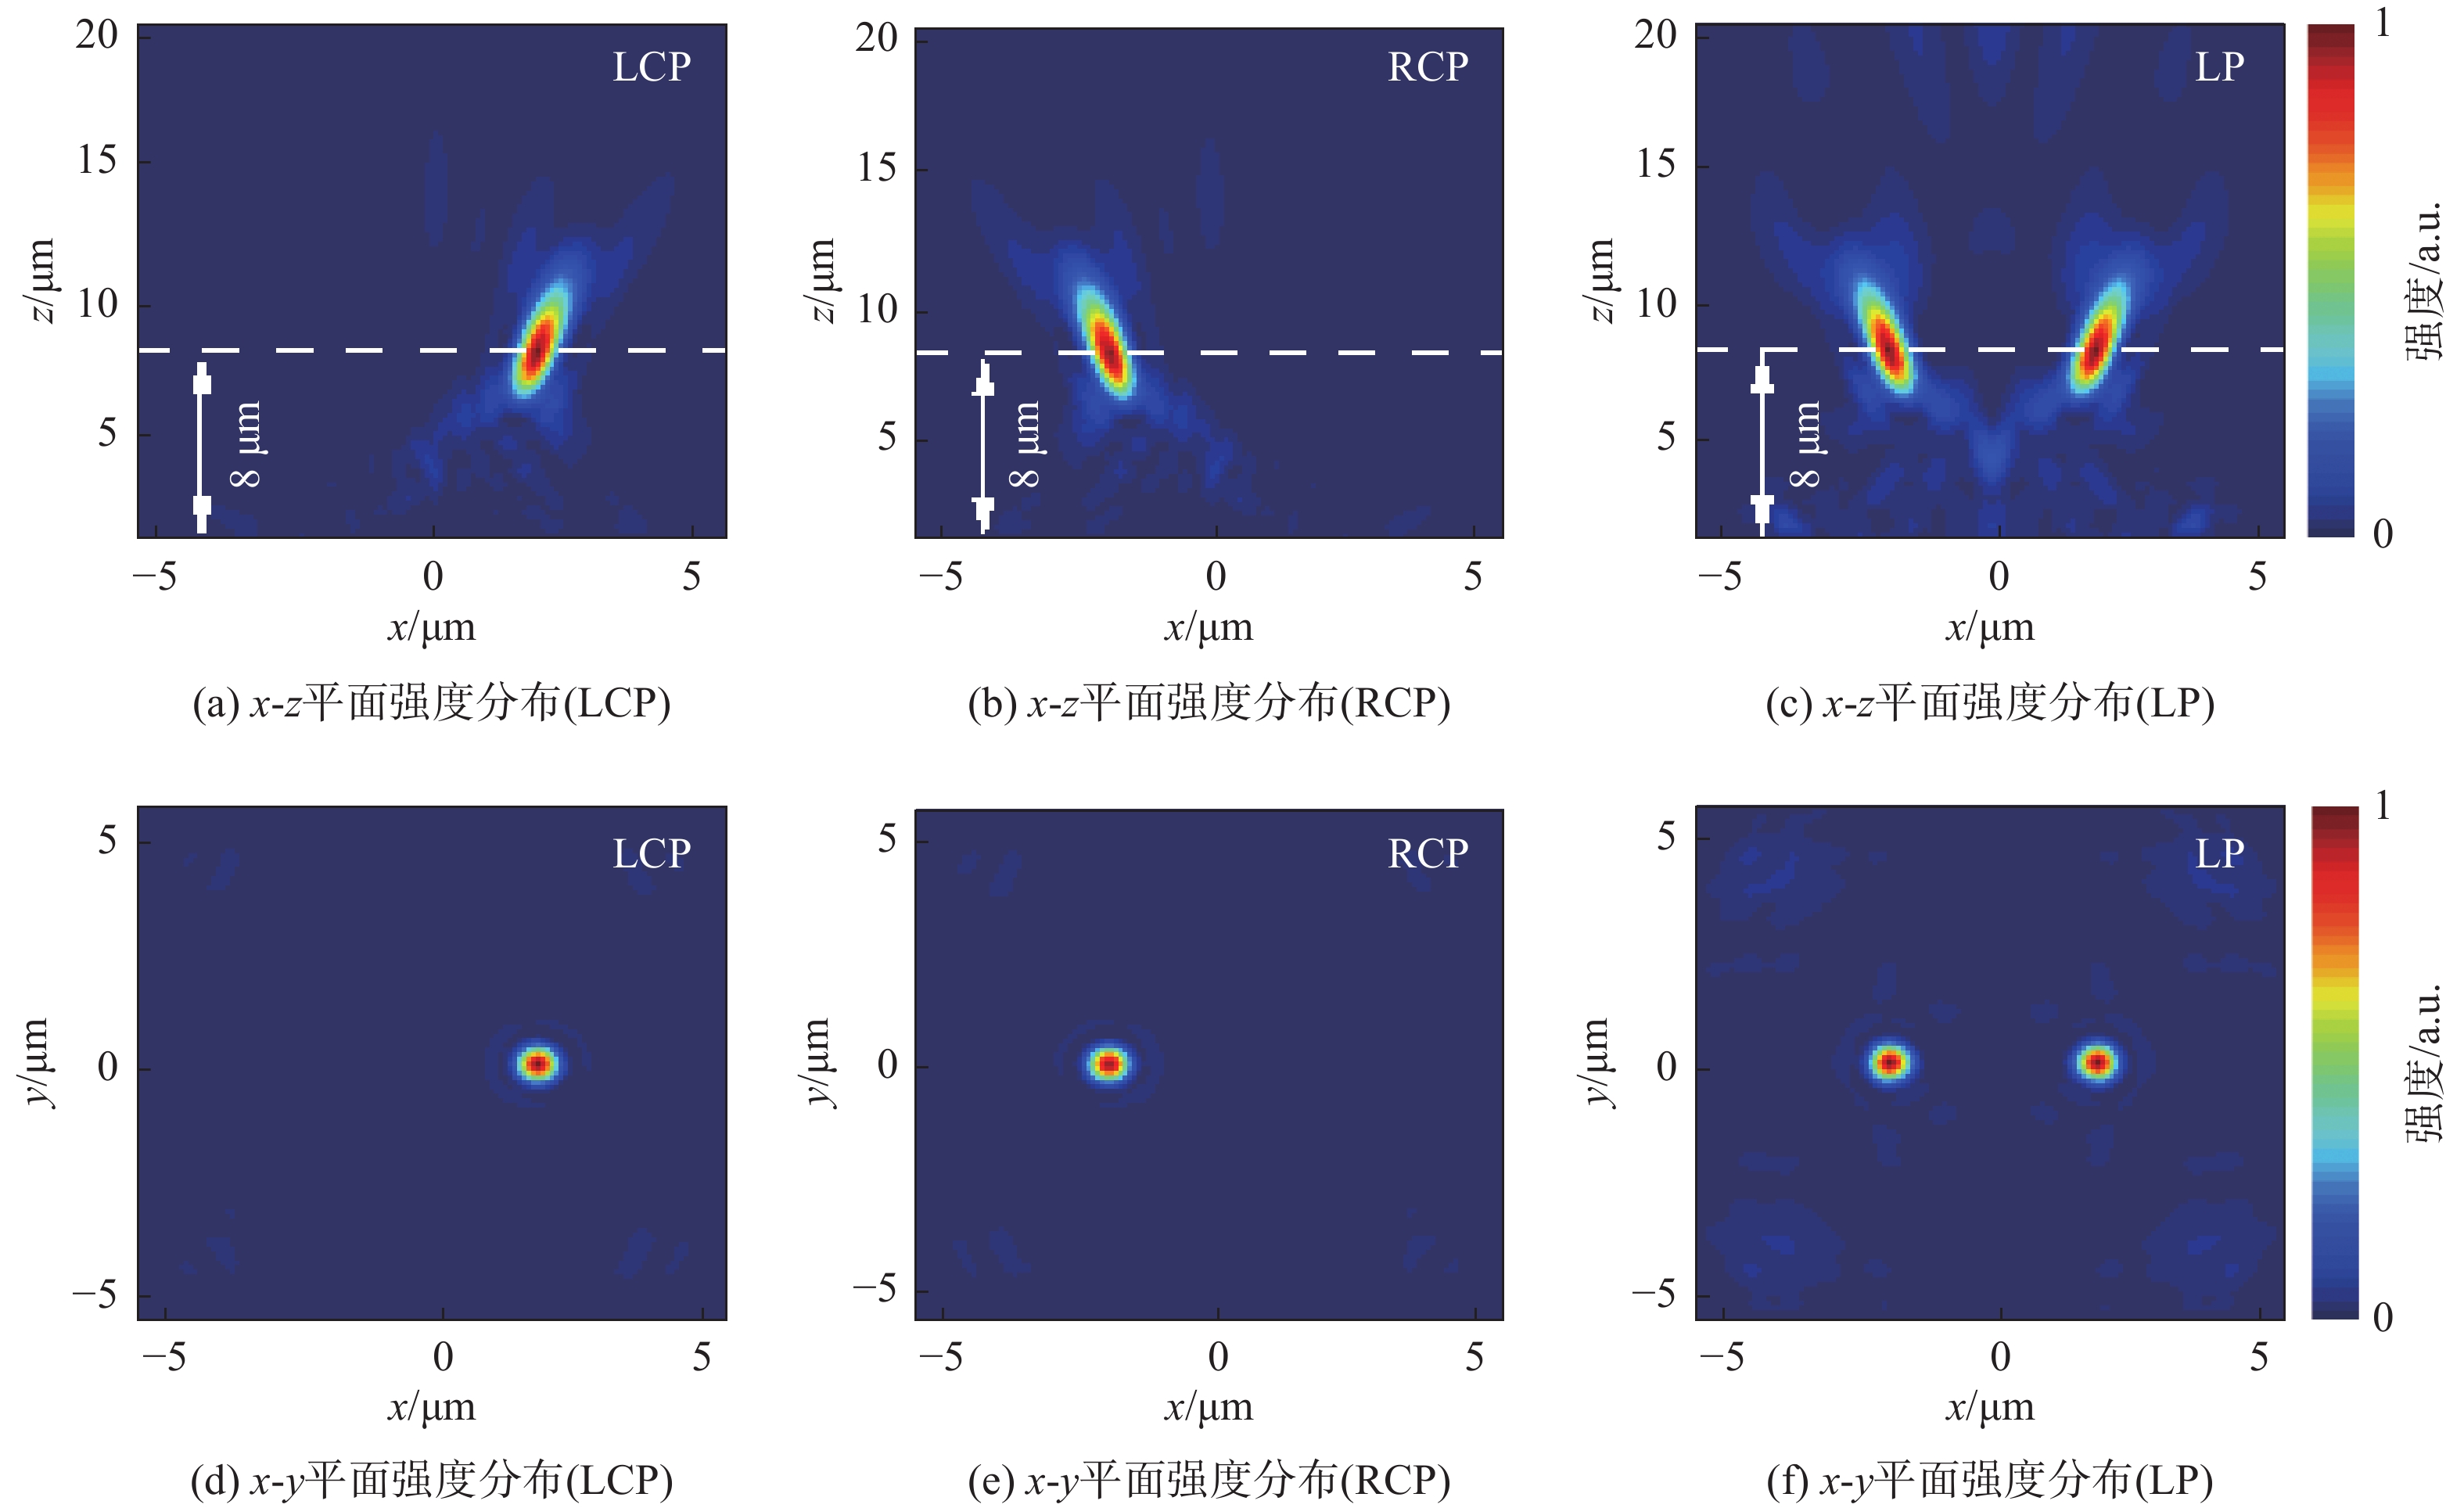
2.2 双焦点超透镜设计设计了对称双焦点超透镜,来检验TNN生成的结构在复合相位调制上的可行性。该超透镜的横向与纵向周期为28,直径为11.2 µm,工作波长为632 nm,LCP光设定的焦点为(2 µm, 0, 8 µm),RCP光的焦点则是(−2 µm, 0, 8 µm)。仿真结果如图7所示,可以观察到,当 LCP或RCP光入射时,均只在对应位置形成单个聚焦光斑,且串扰影响不显著。当LP光入射时,尽管由于误差的存在以及LCP和RCP分量的叠加,导致x-z平面中间部分串扰有所增加,但仍在可控范围内,并未影响到成像效果,如图8(f)所示,在8 µm高度处的x-y平面上,形成两个对称的聚焦光斑。
|
图 7 波长为632 nm时,对称双焦点超透镜在LCP光、RCP光以及LP光入射时的仿真结果 Figure 7 The simulation result of the symmetrical bifocal metalens under LCP, RCP, or LP light incidence at the wavelength of 632 nm |
|
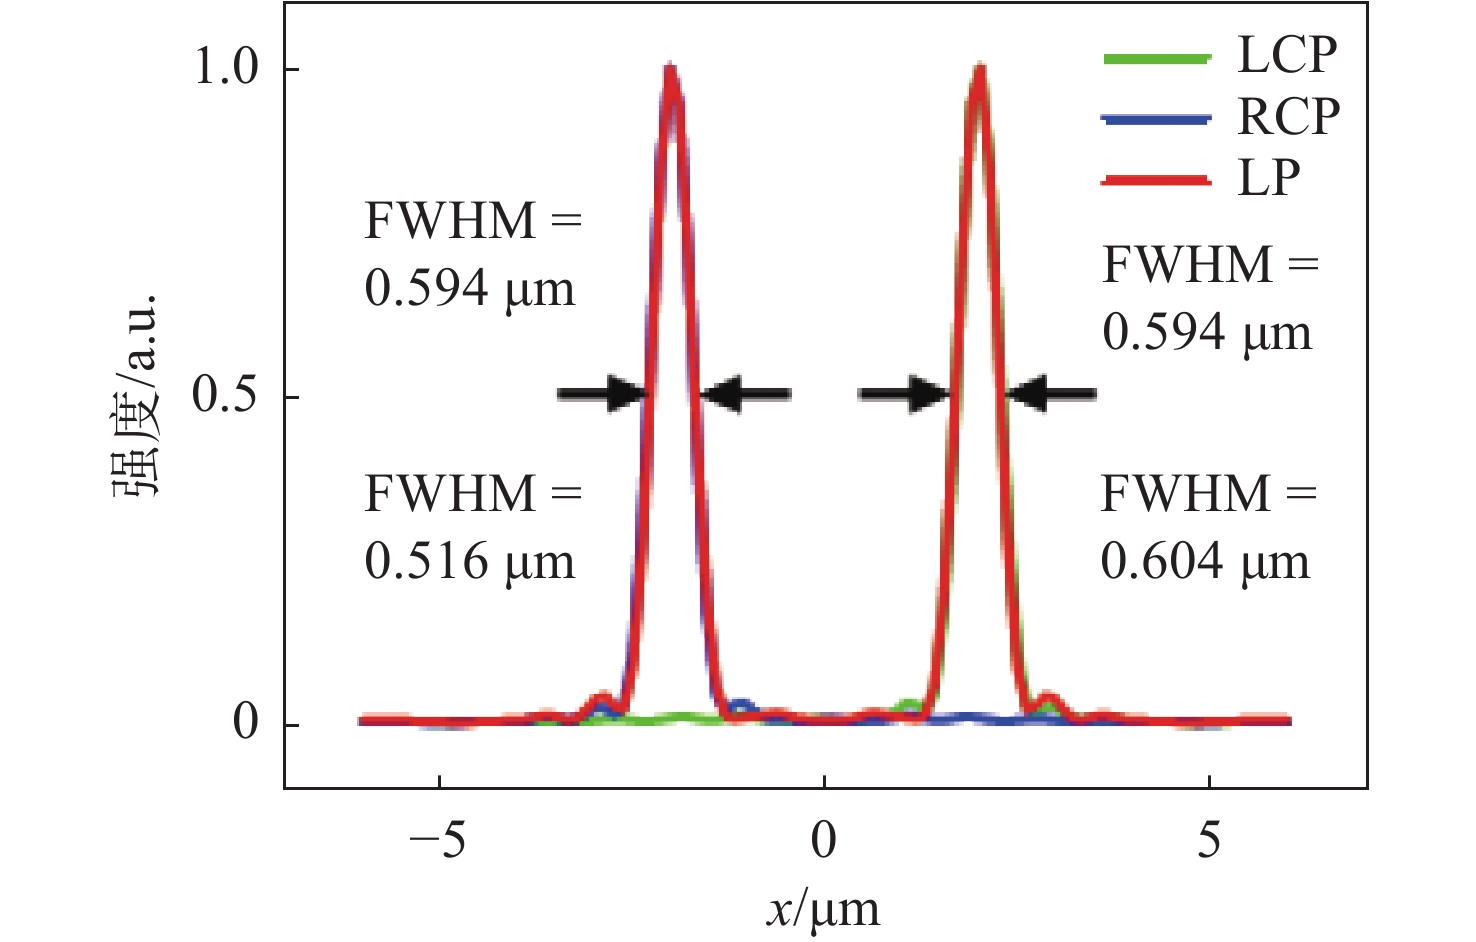
图 8 对称双焦点超透镜在8 µm高度处x方向上的强度分布与FWHM Figure 8 The intensity distribution and FWHM of the symmetrical bifocal metalens along the x direction at the height of 8 µm |
图8 展示了双焦点超透镜在两个焦点位置处的电场强度分布与FWHM,绿线表示LCP光入射时的情况,蓝线表示RCP光入射时的情况,红线表示LP光入射时的情况。可以观察到,当LCP光入射时,光聚焦于右侧波峰处,FWHM为0.606 µm;而当RCP光入射时则是聚焦于左侧波峰处,FWHM为0.516 µm;当LP光入射时,光同时聚焦于左右两侧波峰,两侧FWHM同为0.594 µm。该结果表明超透镜可以有效地将LP光分化为LCP和RCP分量,验证了该结构能实现对LCP和RCP光的按需独立控制,即传输相位与几何相位的复合调控。
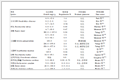
2.3 多焦点超透镜设计在上述的基础上,通过TNN对具备复合功能的超透镜进行设计,验证其可行性,本文采用具备4个区域的多焦点超透镜进行验证。该透镜横向与纵向周期为56,直径为24.3 µm。该超透镜分为4个区域,左下半圆为区域1,左上半圆为区域2,右下半圆为区域3和右上半圆为区域4,每个区域均能独立实现双焦点成像,其中区域1和区域3实现对称成像,区域2和区域4实现非对称成像。此外区域1和区域4两焦点在x方向上分布,区域2和区域3两焦点则在y方向上分布,其预期焦点分布如表1所示。
|
表 1 多焦点超透镜各区域的焦点预期位置 Table 1 The expected locations of the focal points in each region of the multifocal metalens |
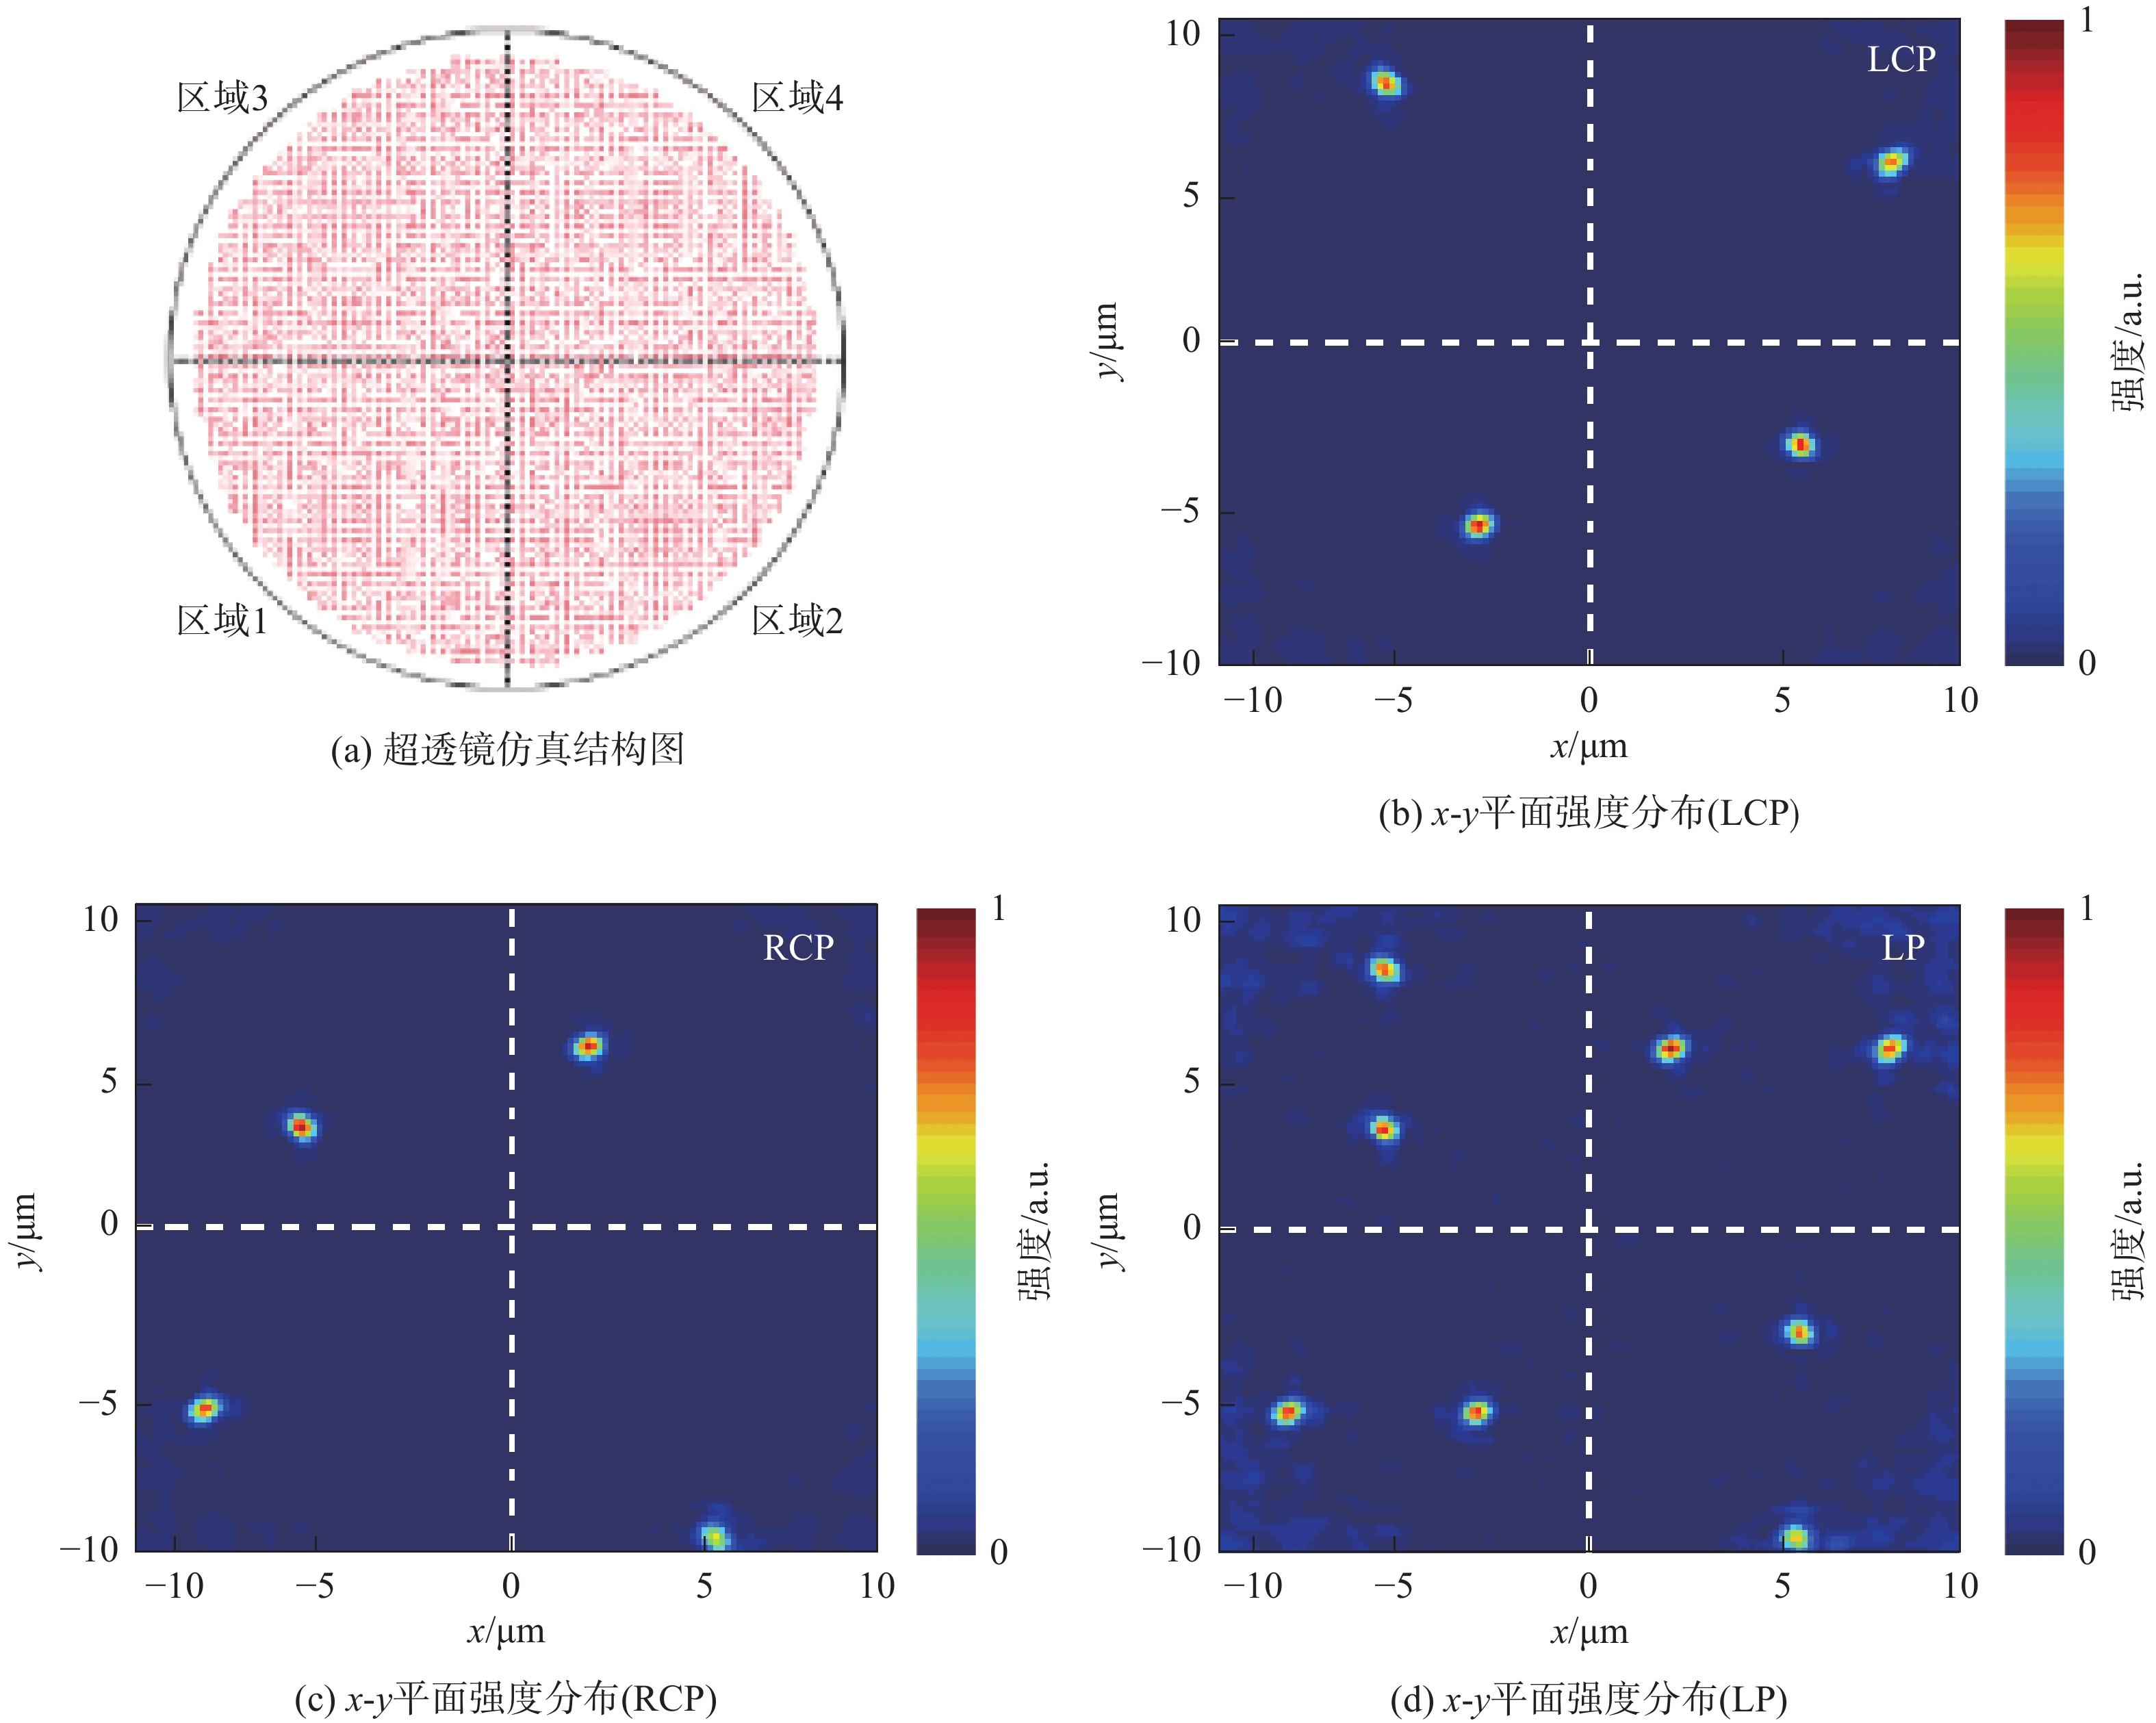
如图9所示,展示了该超透镜的仿真结果。图10(a)展示了该超透镜在FDTD软件中运行的仿真结构图,各个衍射单元在旋转后均未与其他衍射单元发生交错现象。图10(b)到图10(d)展示了LCP光、RCP光、LP光入射时的成像情况。当LCP光或RCP光入射时,各区域均能聚焦于一个对应的光斑处,总计四个光斑。当LP光入射时,各区域则各形成两个对应光斑,共计8个光斑。但需要注意的是,区域2下焦点的光斑强度相较于其他焦点略显减弱,而区域4左焦点的光斑尺寸则略大于其他焦点。
|
图 9 多焦点超透镜的结构图与波长为632 nm时,在LCP光、RCP光以及LP光入射时的仿真结果 Figure 9 The structural diagram and simulation results of the multifocal metalens under LCP, RCP, or LP light incidence at the wavelength of 632 nm |
|
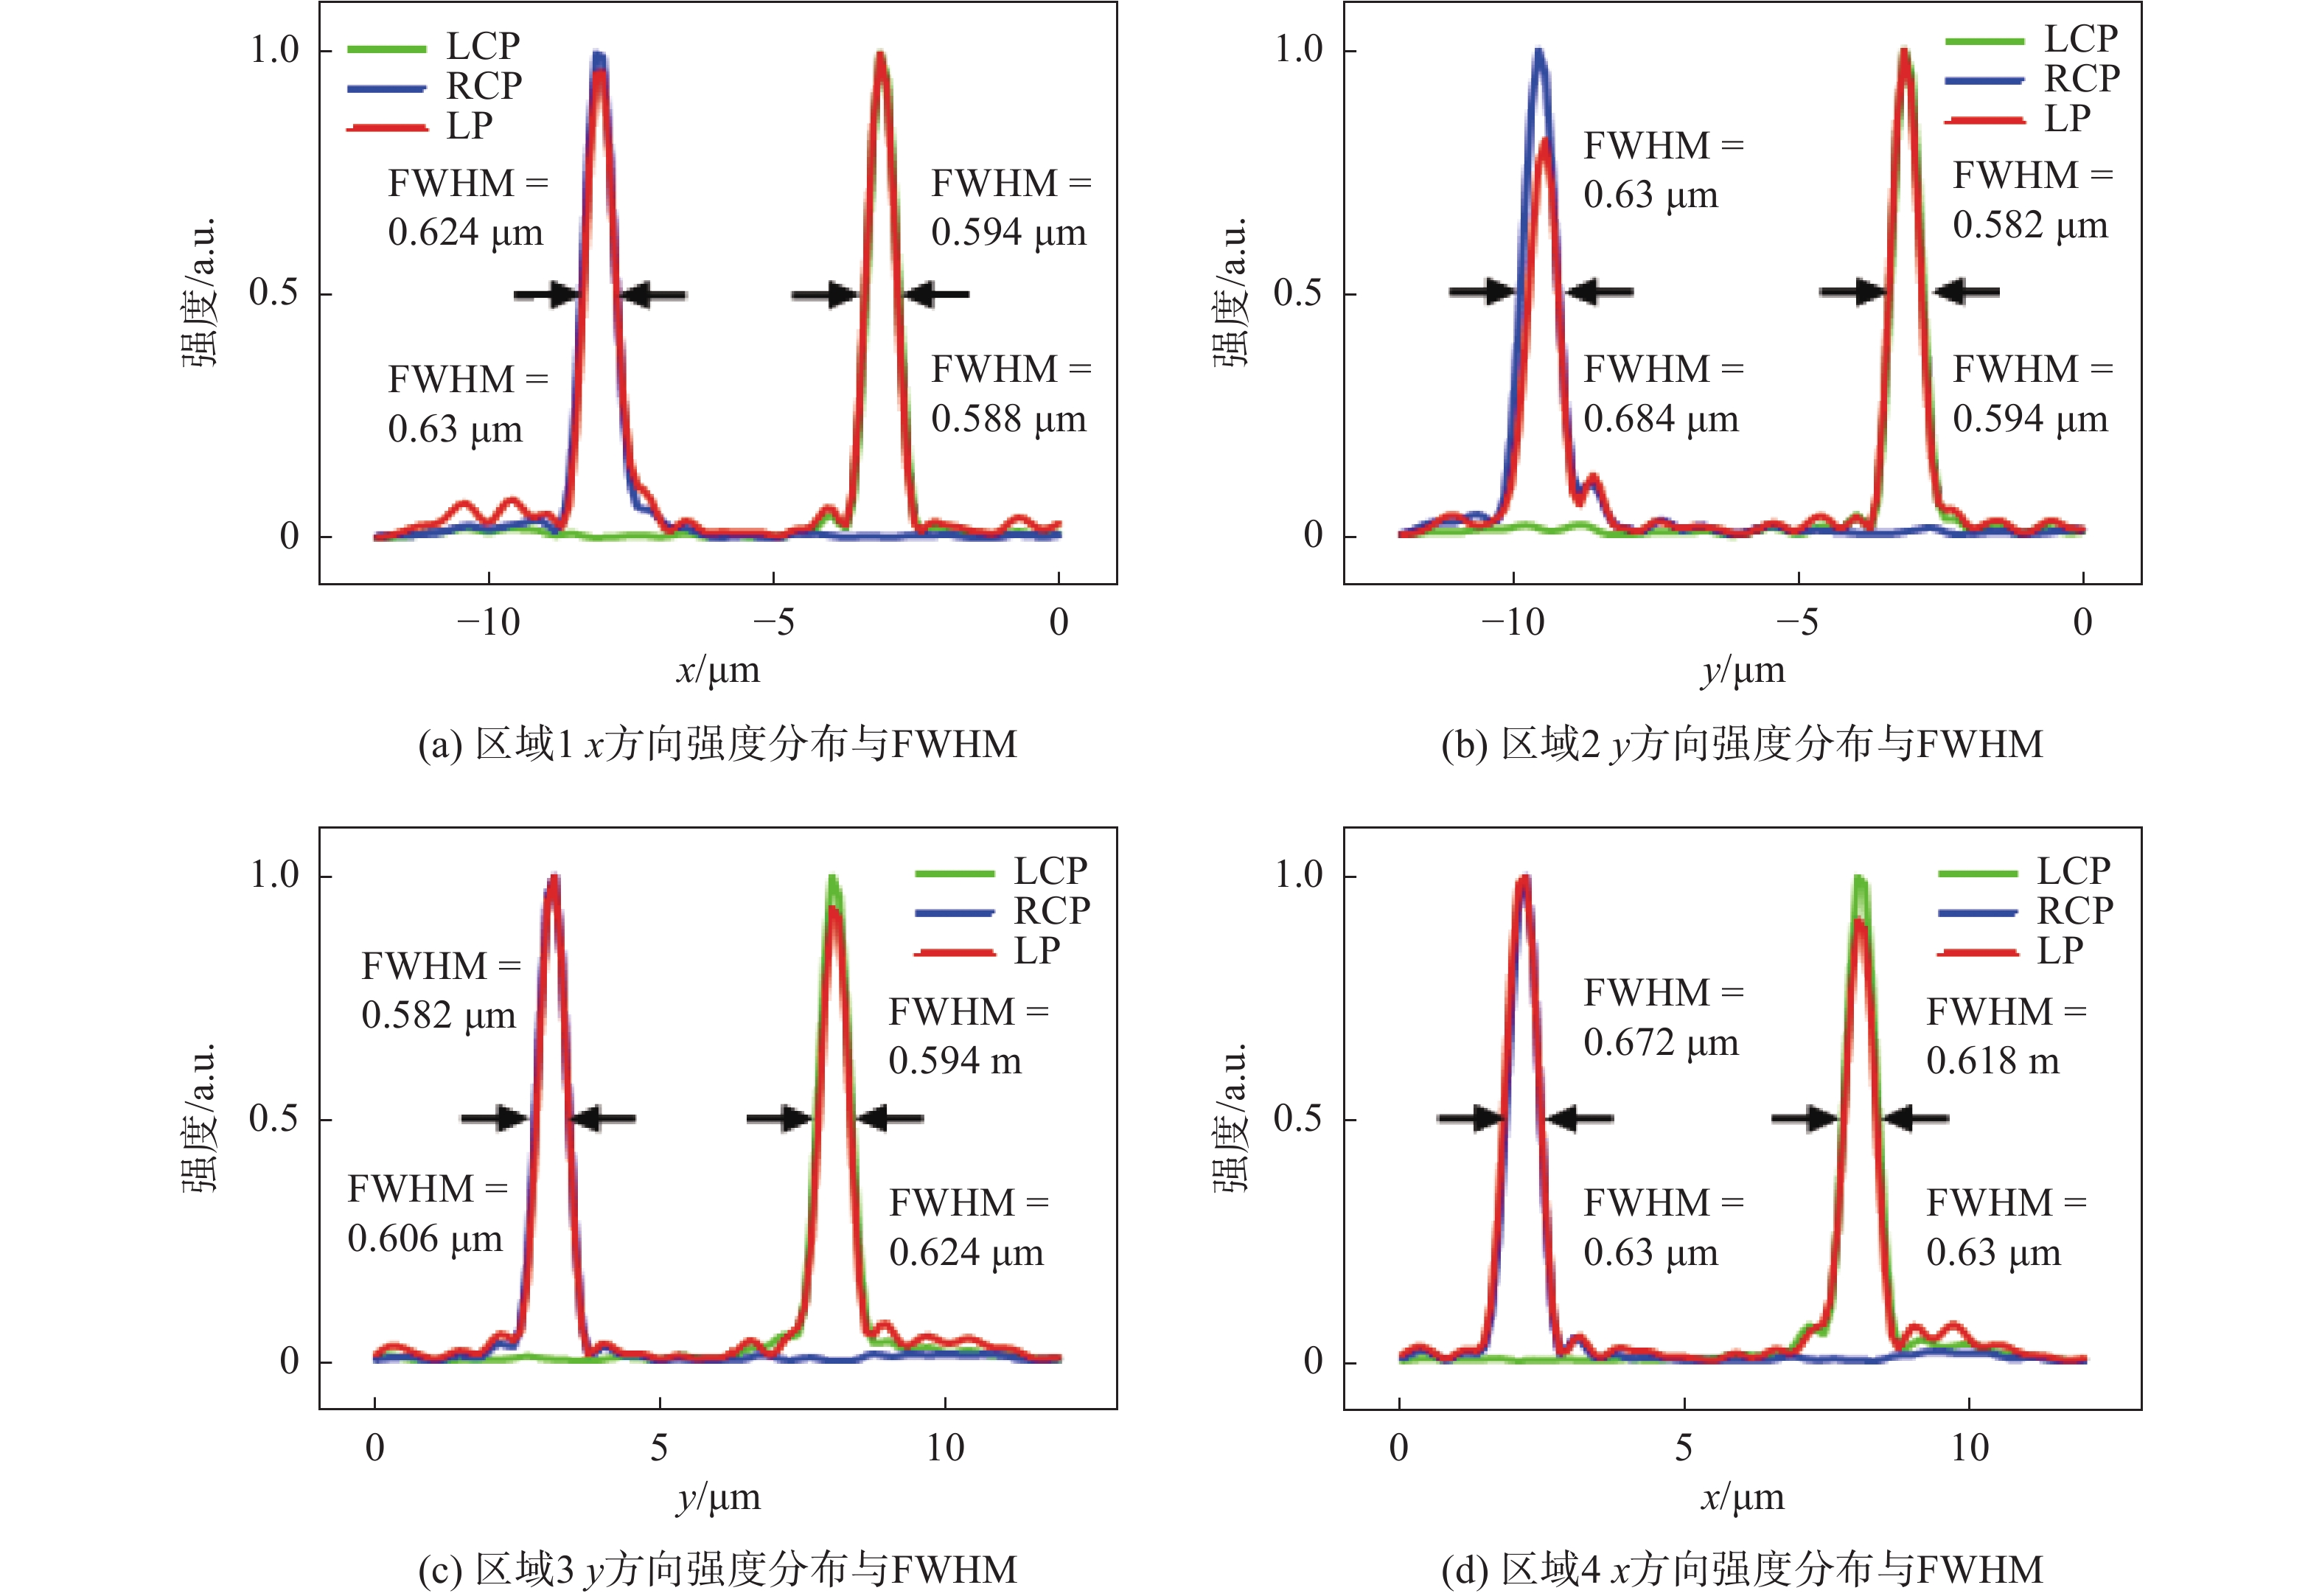
图 10 多焦点超透镜各区域在8 µm高度处,沿x或y方向上的强度分布与FWHM Figure 10 The intensity distribution and FWHM of each region of the multifocal metalens along the x or y direction at the height of 8 µm |
图10展示了该透镜各区域在焦点位置处的电场强度分布与FWHM,绿线表示LCP光入射时的情况,蓝线表示RCP光入射时的情况,红线表示LP入射时的情况。当LCP光入射时,区域1右焦点的FWHM为0.588 µm;区域2上焦点的FWHM为0.594 µm;区域3上焦点的FWHM为0.624 µm;区域4右焦点的FWHM为0.63 µm。当RCP光入射时,区域1左焦点的FWHM为0.63 µm;区域2下焦点的FWHM分别为0.684 µm;区域3下焦点的FWHM为0.606 µm;区域4左焦点的FWHM为0.63 µm。当LP光入射时,区域1双焦点的FWHM分别为0.624 µm和0.594 µm;区域2双焦点的FWHM分别为0.63 µm和0.582 µm;区域3双焦点的FWHM分别为0.582 µm和0.594 µm;区域4双焦点的FWHM分别为0.672 µm和0.618 µm。可知,多焦点超透镜在不同偏振光(LCP、RCP和LP)入射时,各区域焦点的FWHM值大多集中在0.6 µm附近,这表明该超透镜在大多数情况下能够实现较为理想的聚焦效果,不同区域间的相互影响不显著,能够实现各区域间独立成像,从而验证了该网络在超透镜复杂功能设计中的可行性。然而,RCP光入射时的区域2下焦点和LP光入射时的区域4左焦点的FWHM值接近0.7 µm,略高于其他焦点。此外LP光入射时区域2下焦点的相对强度明显低于其他各焦点。
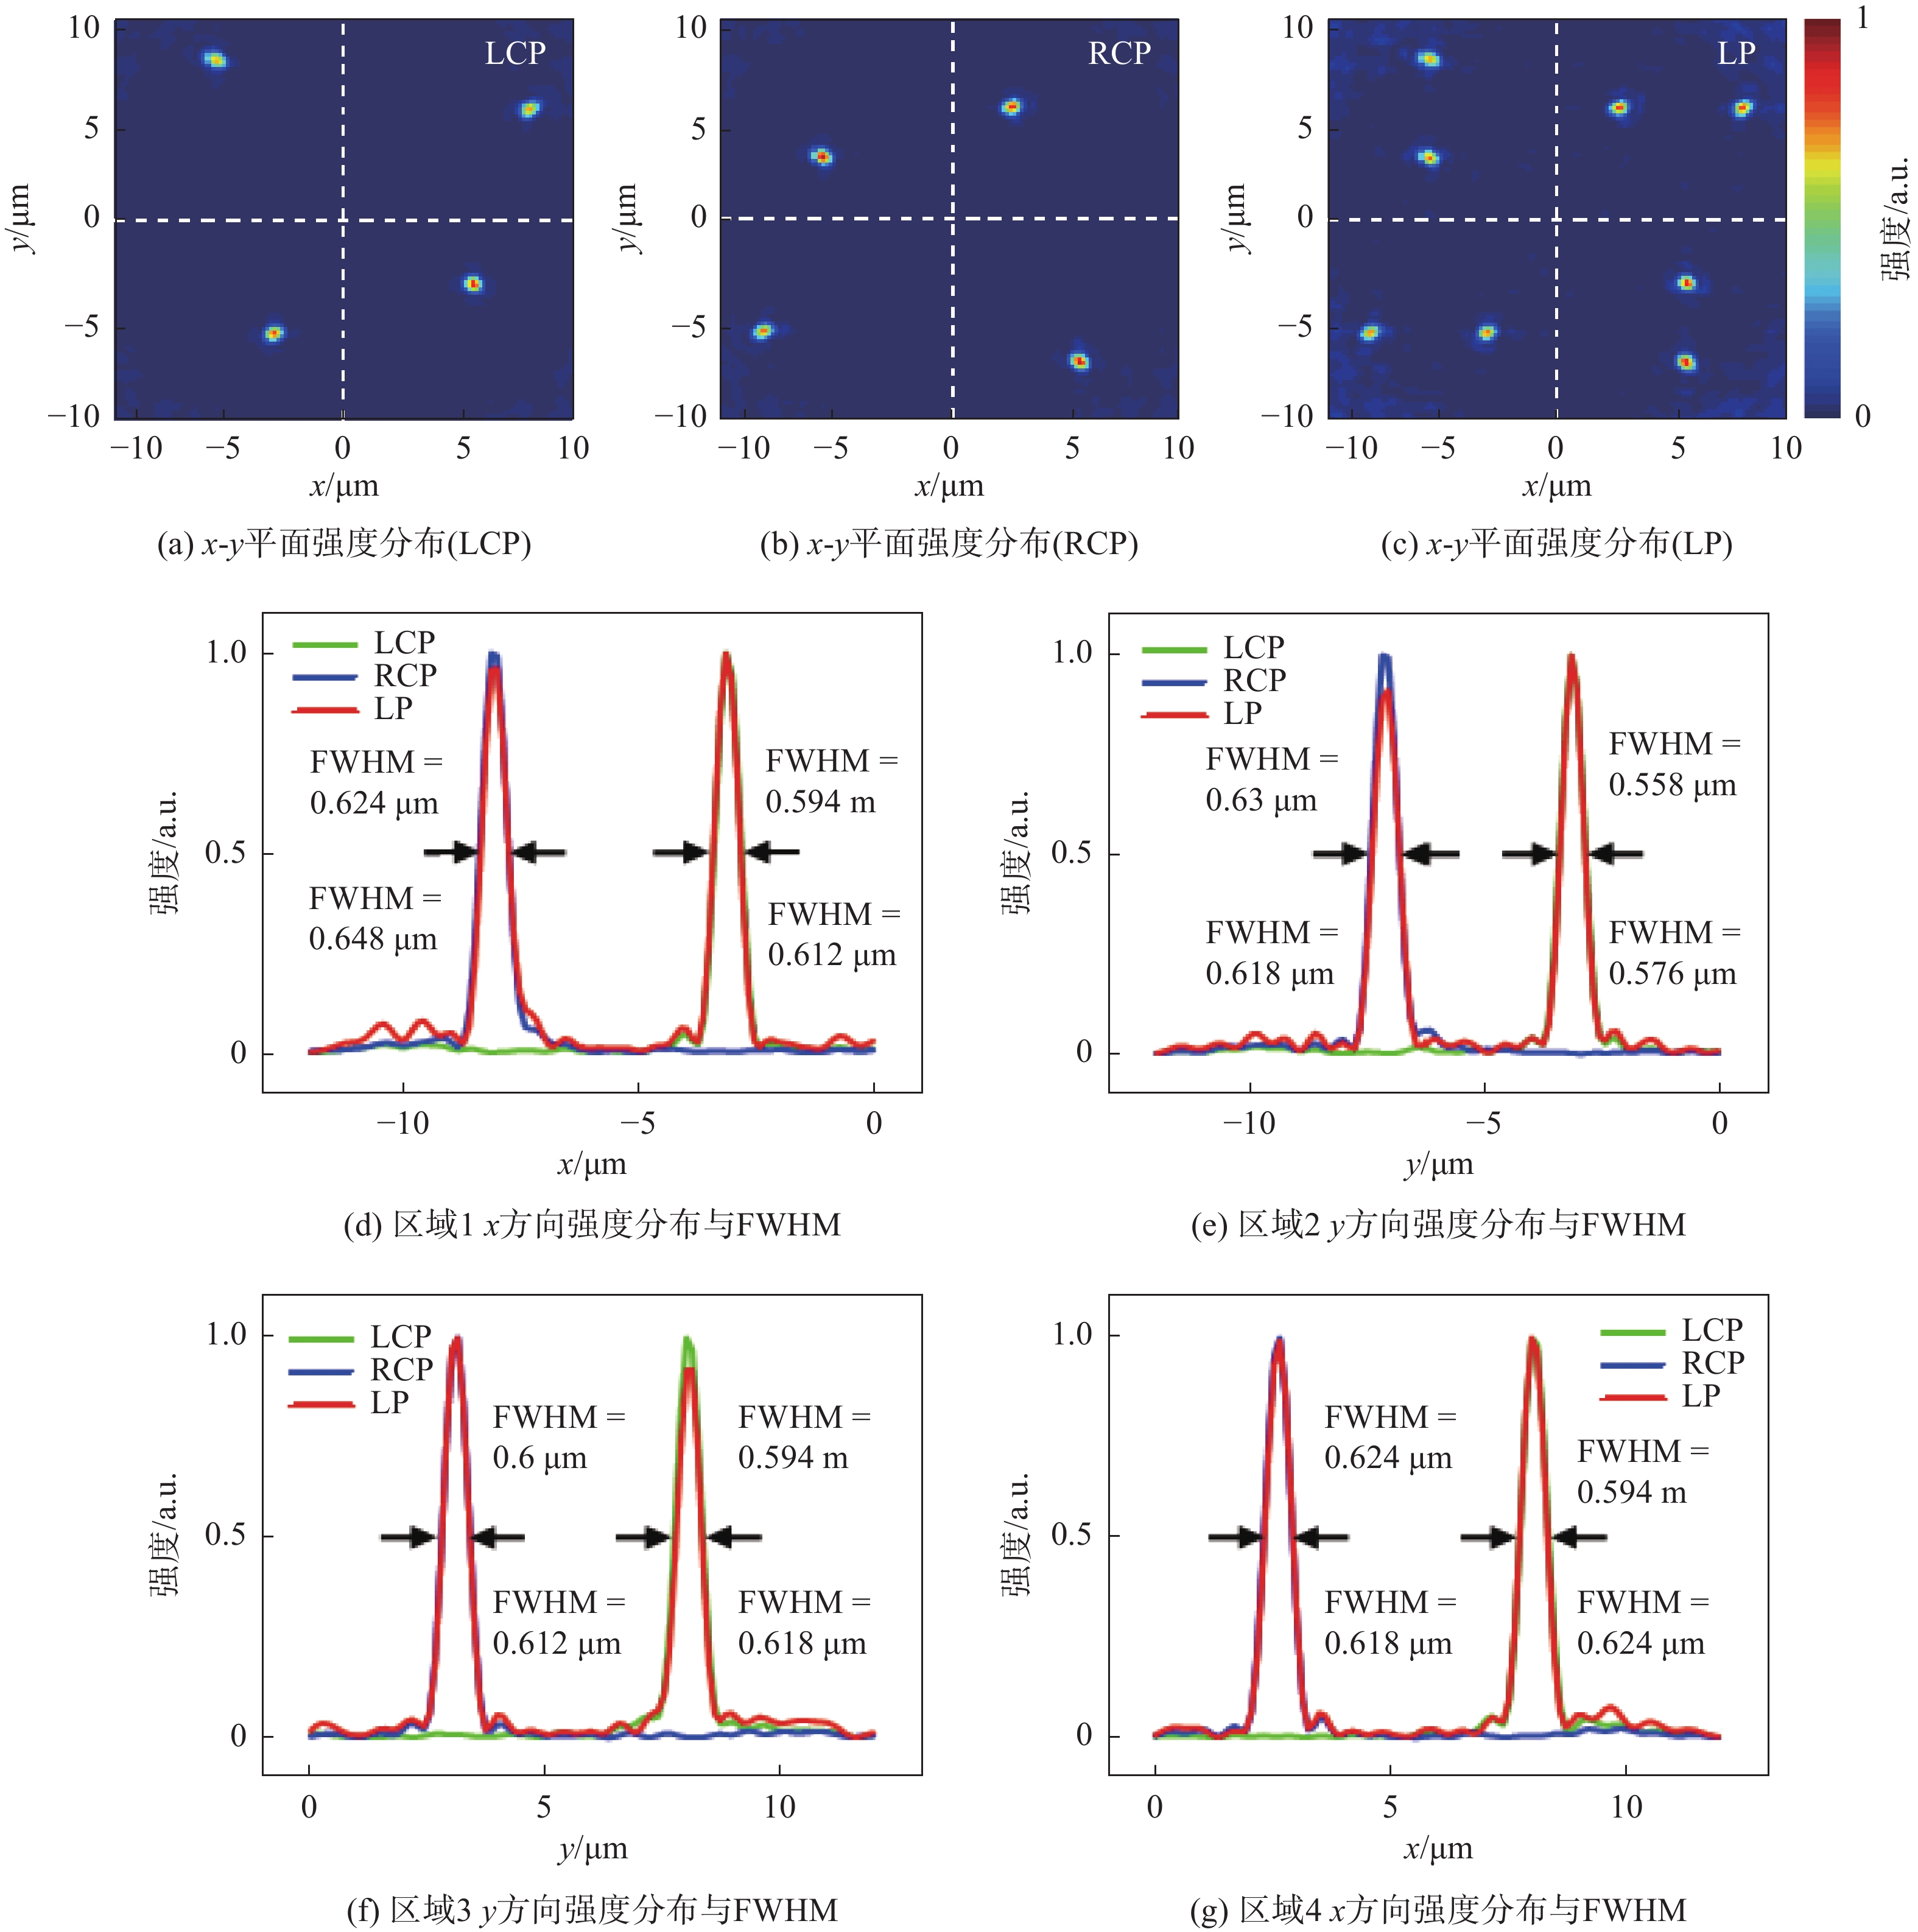
为了进一步探讨区域2下焦点与区域4左焦点的情况,重新设定了两焦点的目标位置,并通过网络重新生成了衍射单元的结构尺寸,两焦点的位置修改为(5.6 µm, −7.1 µm, 8 µm)和(2.6 µm, 5.6 µm, 8 µm)。仿真结果展示在图11中。如图11(a)~(c)所示,可以观察到两焦点聚集效果有所改善。如图11(d)~(g)所示,当LCP光入射时,区域1右焦点的FWHM为0.612 µm;区域2上焦点的FWHM为0.576 µm;区域3上焦点的FWHM为0.618 µm;区域4右焦点的FWHM为0.624 µm。当RCP光入射时,区域1左焦点的FWHM为0.648 µm;区域2下焦点的FWHM分别为0.618 µm;区域3下焦点的FWHM为0.612 µm;区域4左焦点的FWHM为0.618 µm。当LP光入射时,区域1双焦点的FWHM分别为0.624 µm和0.594 µm;区域2双焦点的FWHM分别为0.63 µm和0.558 µm;区域3双焦点的FWHM分别为0.6 µm和0.594 µm;区域4双焦点的FWHM分别为0.624 µm和0.618 µm。结果表明,双焦点受到区域边缘衍射效应与串扰的影响。这可能是由于各独立区域之间的边缘会导致相位调制的不连续性,进而引发串扰和光场分布的偏差。同时可见,当前设计在减少串扰和优化聚焦效果方面仍存在一定的改进空间,可以考虑通过提升网络性能等方式进一步优化结构参数,以及改进各区域功能策略等方式进一步提升超透镜的性能。
|
图 11 修改后的多焦点超透镜在波长为632 nm时,LCP光、RCP光以及LP光入射时的强度分布与FWHM Figure 11 The intensity distribution and FWHM of the revised multifocal metalens under LCP, RCP, or LP light incidence at the wavelength of 632 nm |
经过对前述三种超透镜设计的深入分析可知,利用已构建的串联神经网络,可以有效地实现对超透镜结构对应相位的前向预测,以及相位对应结构的逆向设计,从而满足单焦点与多焦点超透镜的设计需求。因此,可以推断串联神经网络在具备更复杂功能与应用超透镜,如多波长、多焦点复合超透镜等的逆向设计与实际生产工作中能够展现出显著的潜力。然而同时也能从预测相位分布与仿真结果中看出,由于精度、串扰等原因导致的误差与不足的影响,当前的设计仍有优化空间。此外衍射单元选择了较为简单的方柱结构,参与网络设计的参数仅有长与宽两个,更复杂的结构与更多的设计参数对串联神经网络仍将构成挑战。在设计过程中,诸如透过率、吸收损耗等因素未能得到充分考虑,这可能导致超透镜的性能下降。以吸收损耗为例,在可见光波段,光子能量高于硅的带隙,引发本征吸收效应,从而产生较大的吸收损耗。这种损耗不仅降低了入射光的透过率,还影响了超透镜的成像质量,导致聚焦效率和分辨率的下降,并可能引起透射光强分布的不均匀性。为了在网络设计中更好地考虑吸收损耗的影响,需要在数据集中引入硅的吸收损耗特性,例如折射率和消光系数等参数。在网络训练过程中,不仅要确保相位分布的准确性,还需综合考虑吸收损耗的影响,这实际上是一个多目标优化问题。需要在不同目标之间做出权衡,这无疑增加了计算的复杂度。
随着神经网络算法与仿真技术的不断进步与优化,超透镜智能化设计的深入与拓展将显著提升设计性能。在网络方面,通过引入物理约束的物理信息神经网络(physics-informed neural network, PINN)[26]、在网络训练中加入衍射求解器的基于物理模型的神经网络(physics-model-based neural network, PMNN)[27]等与物理规律更密切的网络,可以确保生成的结构不仅符合数据驱动的优化目标,还满足基本的物理规律,从而减少对大量训练数据的依赖并提高设计的物理合理性。随着数据增强与迁移学习等方法的引入,设计的参数将变得更为合理,数值的精确度得到进一步提升,误差也随之降低[28]。此外,仿真中结合多尺度建模技术,能够同时优化微观结构(如单个衍射单元)和宏观性能(如整体透镜的聚焦效果),进一步提升设计的全局优化能力和实用性[29]。为了确保设计结果与实验制备的一致性,未来研究可以引入制造误差模型和容差分析,优化设计参数以应对纳米加工中的不确定性。通过迭代设计与实验验证、高精度制造工艺以及数据驱动的方法,可以进一步提高设计结果的可制造性和实验一致性。随着这些技术的不断发展与融合,基于深度学习的逆向设计方法将在超透镜设计中展现出更广阔的应用潜力,推动光学器件向更高性能、更复杂功能的方向发展。
3 结 论综上所述,本文提出了一种基于串联神经网络的多焦点超透镜逆向设计方法。该网络高效地实现了对衍射单元相位的前向预测与结构参数的逆向设计,其最佳损失分别为
| [1] | JIANG Z X, CHAO M H, LIU Q S, et al. High-efficiency spin-selected multi-foci terahertz metalens[J]. Optics and Lasers in Engineering, 2024, 174: 107816. DOI:10.1016/j.optlaseng.2023.107816 |
| [2] | CHU Y H, XIAO X J, YE X, et al. Design of achromatic hybrid metalens with secondary spectrum correction[J]. Optics Express, 2023, 31(13): 21399–21406. |
| [3] | LI S Y, HSU C W. Thickness bound for nonlocal wide-field-of-view metalenses[J]. Light: Science & Applications, 2022, 11(1): 338. |
| [4] | ATALAY İ A, YILMAZ Y A, SAVAS F C, et al. A broad-band achromatic polarization-insensitive in-plane lens with high focusing efficiency[J]. ACS Photonics, 2021, 8(8): 2481–2488. DOI:10.1021/acsphotonics.1c00721 |
| [5] | ZHANG J C, LIANG H W, LONG Y, et al. Metalenses with polarization-insensitive adaptive nano-antennas[J]. Laser & Photonics Reviews, 2022, 16(9): 2200268. |
| [6] | HU Y W, WANG Y, XU Q, et al. Design of monofocal and bifocal lenses by new method and their application in high-gain lens antenna based on chiral metamaterial[J]. IET Microwaves, Antennas & Propagation, 2019, 13(13): 2272 − 2278. |
| [7] | CHEN L, SHAO Z L, LIU J, et al. Multi-wavelength achromatic bifocal metalenses with controllable polarization-dependent functions for switchable focusing intensity[J]. Journal of Physics D: Applied Physics, 2022, 55(11): 115102. |
| [8] | DUAN G H, ZHANG C, YANG D S, et al. Theoretical design of a bionic spatial 3D-arrayed multifocal metalens[J]. Biomimetics, 2022, 7(4): 200. |
| [9] | VAHABZADEH Y, CHAMANARA N, CALOZ C. Generalized sheet transition condition FDTD simulation of metasurface[J]. IEEE Transactions on Antennas and Propagation, 2018, 66(1): 271–280. |
| [10] | YIN Y Y, JIANG Q, WANG H B, et al. Multi-dimensional multiplexed metasurface holography by inverse design[J]. Advanced Materials, 2024, 36(21): 2312303. |
| [11] | WIECHA P R, ARBOUET A, GIRARD C, et al. Deep learning in nano-photonics: inverse design and beyond[J]. Photonics Research, 2021, 9(5): B182–B200. |
| [12] | MALKIEL I, MREJEN M, NAGLER A, et al. Plasmonic nanostructure design and characterization via Deep Learning[J]. Light: Science & Applications, 2018, 7: 60. |
| [13] | AN S S, ZHENG B W, TANG H, et al. Multifunctional metasurface design with a generative adversarial network[J]. Advanced Optical Materials, 2021, 9(5): 2001433. |
| [14] | CHEN Y Y, ZHU Y L, BRITTON W A, et al. Inverse design of ultracompact multi-focal optical devices by diffractive neural networks[J]. Optics Letters, 2022, 47(11): 2842–2845. |
| [15] | WANG F, SHU X W. Design of a bifocal metalens with tunable intensity based on deep-learning-forward genetic algorithm[J]. Journal of Physics D: Applied Physics, 2023, 56(9): 095101. |
| [16] | KHORASANINEJAD M, CHEN W T, DEVLIN R C, et al. Metalenses at visible wavelengths: diffraction-limited focusing and subwavelength resolution imaging[J]. Science, 2016, 352(6290): 1190–1194. |
| [17] | CHEN D L, WANG J J, WANG S, et al. The bifocal metalenses for independent focusing of orthogonally circularly polarized light[J]. Journal of Physics D: Applied Physics, 2021, 54(7): 075103. |
| [18] | MUELLER J P B, RUBIN N A, DEVLIN R C, et al. Metasurface polarization optics: independent phase control of arbitrary orthogonal states of polarization[J]. Physical Review Letters, 2017, 118(11): 113901. |
| [19] | LI S Q, LI X Y, WANG G X, et al. Multidimensional manipulation of photonic spin hall effect with a single-layer dielectric metasurface[J]. Advanced Optical Materials, 2019, 7(5): 1801365. |
| [20] | WANG S N, HE Y L, ZHU H W, et al. An efficient design method for a metasurface polarizer with high transmittance and extinction ratio[J]. Photonics, 2024, 11(1): 53. |
| [21] | XU P, LOU J, LI C X, et al. Inverse design of a metasurface based on a deep tandem neural network[J]. Journal of the Optical Society of America B, 2024, 41(2): A1–A5. |
| [22] | LIU D J, TAN Y X, KHORAM E, et al. Training deep neural networks for the inverse design of nanophotonic structures[J]. ACS Photonics, 2018, 5(4): 1365–1369. |
| [23] | XU J, LI Z S, DU B W, et al. Reluplex made more practical: leaky ReLU[C]//2000 IEEE Symposium on Computers and Communications (ISCC). Rennes: IEEE, 2020: 1 − 7. |
| [24] | SUN Y, FANG X Z. Robust calibration of computer models based on Huber loss[J]. Journal of Systems Science and Complexity, 2023, 36(4): 1717–1737. |
| [25] | AN X P, CAO Y, WEI Y X, et al. Broadband achromatic metalens design based on deep neural networks[J]. Optics Letters, 2021, 46(16): 3881–3884. |
| [26] | KOVACS A, EXL L, KORNELL A, et al. Magnetostatics and micromagnetics with physics informed neural networks[J]. Journal of Magnetism and Magnetic Materials, 2022, 548: 168951. |
| [27] | HE J M, GUO Z H, ZHANG Y Y, et al. Physics-model-based neural networks for inverse design of binary phase planar diffractive lenses[J]. Optics Letters, 2023, 48(6): 1474–1477. |
| [28] | ZHU R C, QIU T S, WANG J F, et al. Phase-to-pattern inverse design paradigm for fast realization of functional metasurfaces via transfer learning[J]. Nature Communications, 2021, 12(1): 2974. |
| [29] | ILLOBRE P G, LAFIOSCA P, GUIDONE T, et al. Multiscale modeling of surface enhanced fluorescence[J]. Nanoscale Advances, 2024, 6(13): 3410–3425. |