 2026, Vol. 48
 Issue (3): 41-49


2. 上海理工大学 光子芯片研究院,上海 200093
2. Institute of Photonic Chips, University of Shanghai for Science and Technology, Shanghai 200093, China
机器学习(machine learning,ML)在过去10年中取得了飞速发展,它能从大规模数据集中发现模式和规则,实现自我学习[1]和自主决策能力[2]。这些进展显著影响了人们的日常生活,并在图像识别[3-4]、自然语言处理[5]、医疗保健[6]、智能制造和教育等领域得到了广泛应用。神经网络(neural networks,NN)作为目前最广泛应用的ML架构之一,通常依赖于张量处理单元[7](tensor processing unit,TPU)和现场可编程门阵列[8](field programmable gate array,FPGA)等专用硬件单元来加速这些任务。这些硬件通过并行化ML所需的线性代数计算和矩阵乘法来提高效率。现有的数字计算硬件最初是由冯∙诺依曼架构设计的,该架构将中央处理单元(central processing unit,CPU)与存储器分离。此架构以二进制、时钟驱动的方式处理信息,程序由显式指令定义。尽管这一设计在通用计算任务中表现出色,但其线性数据传输模式却难以适应现代ML应用所需的大规模并行计算需求,对计算效率的进一步提升形成了制约。
近年来,光学神经网络[9](optical neural network,ONN)作为一种新兴技术,因其能够克服数字计算的局限性而引起了广泛关注。ONN利用光波传播的特性进行计算,通过光的衍射和干涉以及其他波动现象以光速执行矩阵乘法,从而实现大规模并行处理,并具有极低的功耗。衍射神经网络[10–13](diffractive neural networks,DNN)将神经网络参数编码到衍射光学元件中,利用多层衍射层来处理光信号。根据DNN的结构特点,可将其分为空间衍射神经网络(spatial diffractive neural networks,SDNN)和二维衍射神经网络(two-dimensional diffractive neural networks,2D DNN)。SDNN通常采用三维自由空间布局,利用多个空间衍射层处理信号,其制造通常依赖于3D打印或光刻技术[14]。相比之下,2D DNN采用平面布局,能够与光子集成电路[15–18](photonic integrated circuit,PIC)相结合,这使得其能够与调制器、探测器和分束器等其他光子元件紧密集成,从而实现更高的集成度和小型化设计。然而,通过光刻或3D打印的DNN通常是静态的,需要在制造前通过计算机仿真训练出理想化模型,这使其易受制造误差的影响,在图像分类等任务中可实现的精度降低。尽管通过误差校正算法[16]能够在一定程度上补偿制造误差所导致的性能下降,但该方案是通过对输入/输出端功率进行补偿来恢复性能,最终的精度依赖于补偿的干预,且额外电子补偿模块会增加系统复杂度,削弱光学系统在高速和低功耗信息处理中的潜在优势。
原位训练[19](in-situ training)衍射神经网络使用空间光调制器(spatial light modulator,SLM)作为衍射调制器,对空间相位进行动态编码和训练,使训练过程从计算机转移到光学系统内部,直接在物理系统中实现光学误差反向传播,从而显著提升训练效率。但该方法依赖多个SLM阵列协同工作,导致设备成本高、系统集成度低,限制了其实际应用场景。为克服这一限制,提出了面向原位训练的2D DNN概念,即利用激光直写技术将衍射神经元直接写入二维材料,实现训练与制造的同步进行,从而无需额外后处理即可获得高精度的 DNN。与基于SLM的原位训练方法相比,该方法避免了对高成本可编程光学器件的依赖,同时提升了系统集成度,实现了训练与制造的一体化,更适用于光学计算的片上集成。当前制作工艺主要依赖于光刻、3D打印等增材制造方式,或采用激光烧蚀的减材工艺,与现有双向参数更新机制的训练方法不匹配。为此,本文提出了一种适用于原位训练2D DNN的单方向权重更新策略。数值模拟表明,该训练方案可以实现与传统双向权重更新方案相当的分类精度。此外,还研究了2D DNN在不同结构中的表现以及原位训练2D DNN中误差对网络的影响。激光直写与单方向权重更新策略允许神经网络直接在衍射结构上实现训练,避免了制造兼容性问题,同时降低了系统整体复杂度,实现了信息的全光推理。本研究为原位训练DNN的高精度、低功耗光学信息处理方案的实现奠定了基础,具有广泛的应用前景,可用于视觉信息处理、通信等多个领域。
1 衍射神经网络的构建DNN采用监督学习方法进行训练,基于带标签的数据集,通过反向传播算法实现最小化损失函数。为研究原位训练DNN的可能性,本文提出了一种基于Adam优化器改进的单向参数更新方法。所有训练在Windows 11系统上,利用Python 3.9.19和TensorFlow 2.10.0来进行。每个模型训练50个周期,采用交叉熵损失函数。在空间DNN和2D DNN模型中,将输入波长设置为532 nm。
1.1 数据准备与预处理采用两个数据集进行网络模型训练:修改版美国国家标准与技术研究院(modified national institute of standards and technology,MNIST)手写数字数据库和时尚版MNIST(Fashion MNIST)手写数字数据库。为确保数据的一致性,所有图像均被转换为灰度格式。MNIST数据库是一个经典的手写数字数据集,数字范围为0~9,包括60 000张训练图像和10 000张测试图像,图像分辨率为28×28像素。Fashion MNIST数据库是更加复杂的数据集,由10类服装和配饰组成,如T恤、裤子、鞋子和包等。每张图像的分辨率也为28×28像素。Fashion MNIST数据具有更复杂的纹理和形状特征,对模型的分类能力提出了更高要求。使用这两个数据集能够全面评估模型在简单任务和复杂任务上的性能表现。
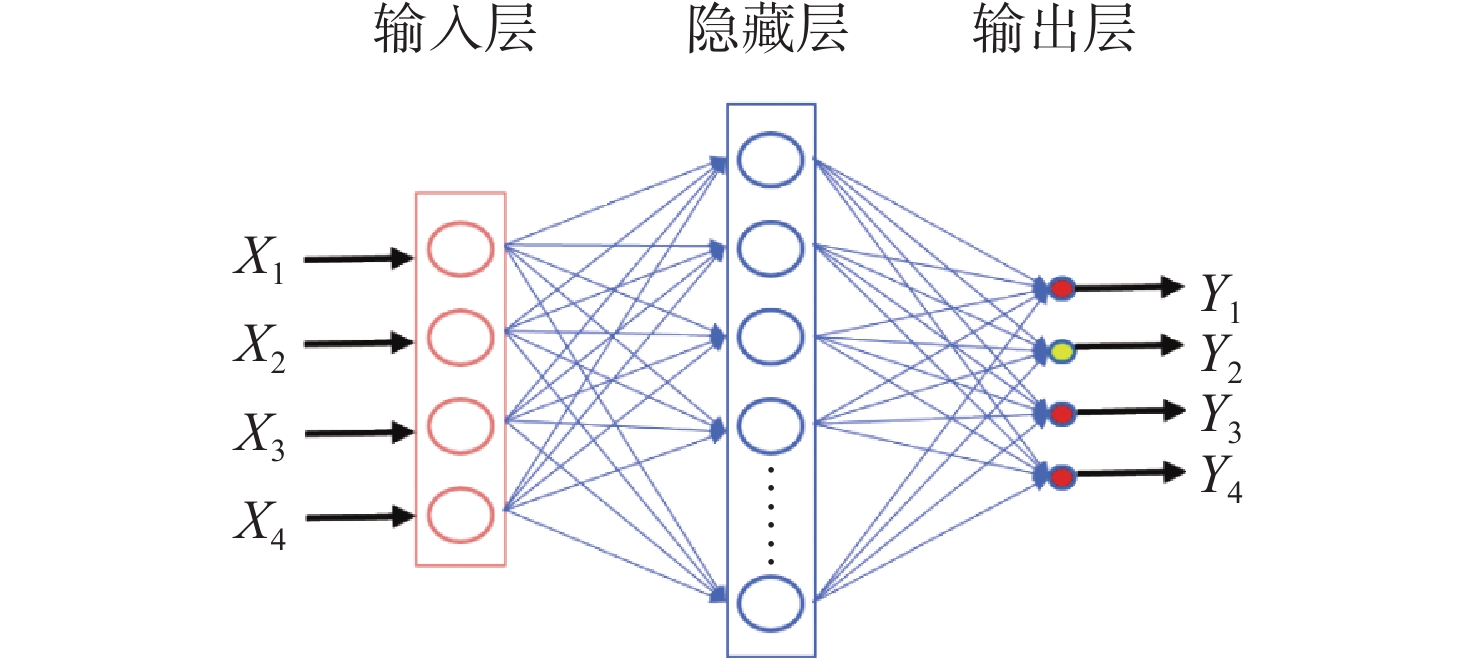
1.2 网络设计多层感知机(multilayer perceptron,MLP)是一种基础的前馈神经网络[19],由输入层、输出层和1个隐藏层组成,其结构如图1所示。隐藏层包含256个全连接神经元,使用线性修正单元(rectified linear unit,ReLU)作为激活函数;输出层包含10个神经元,采用柔性最大化函数(soft maximum,SoftMax)生成最终分类结果,对应数据集中的10个标签。
|
图 1 数字神经网络 Figure 1 Digital neural network |
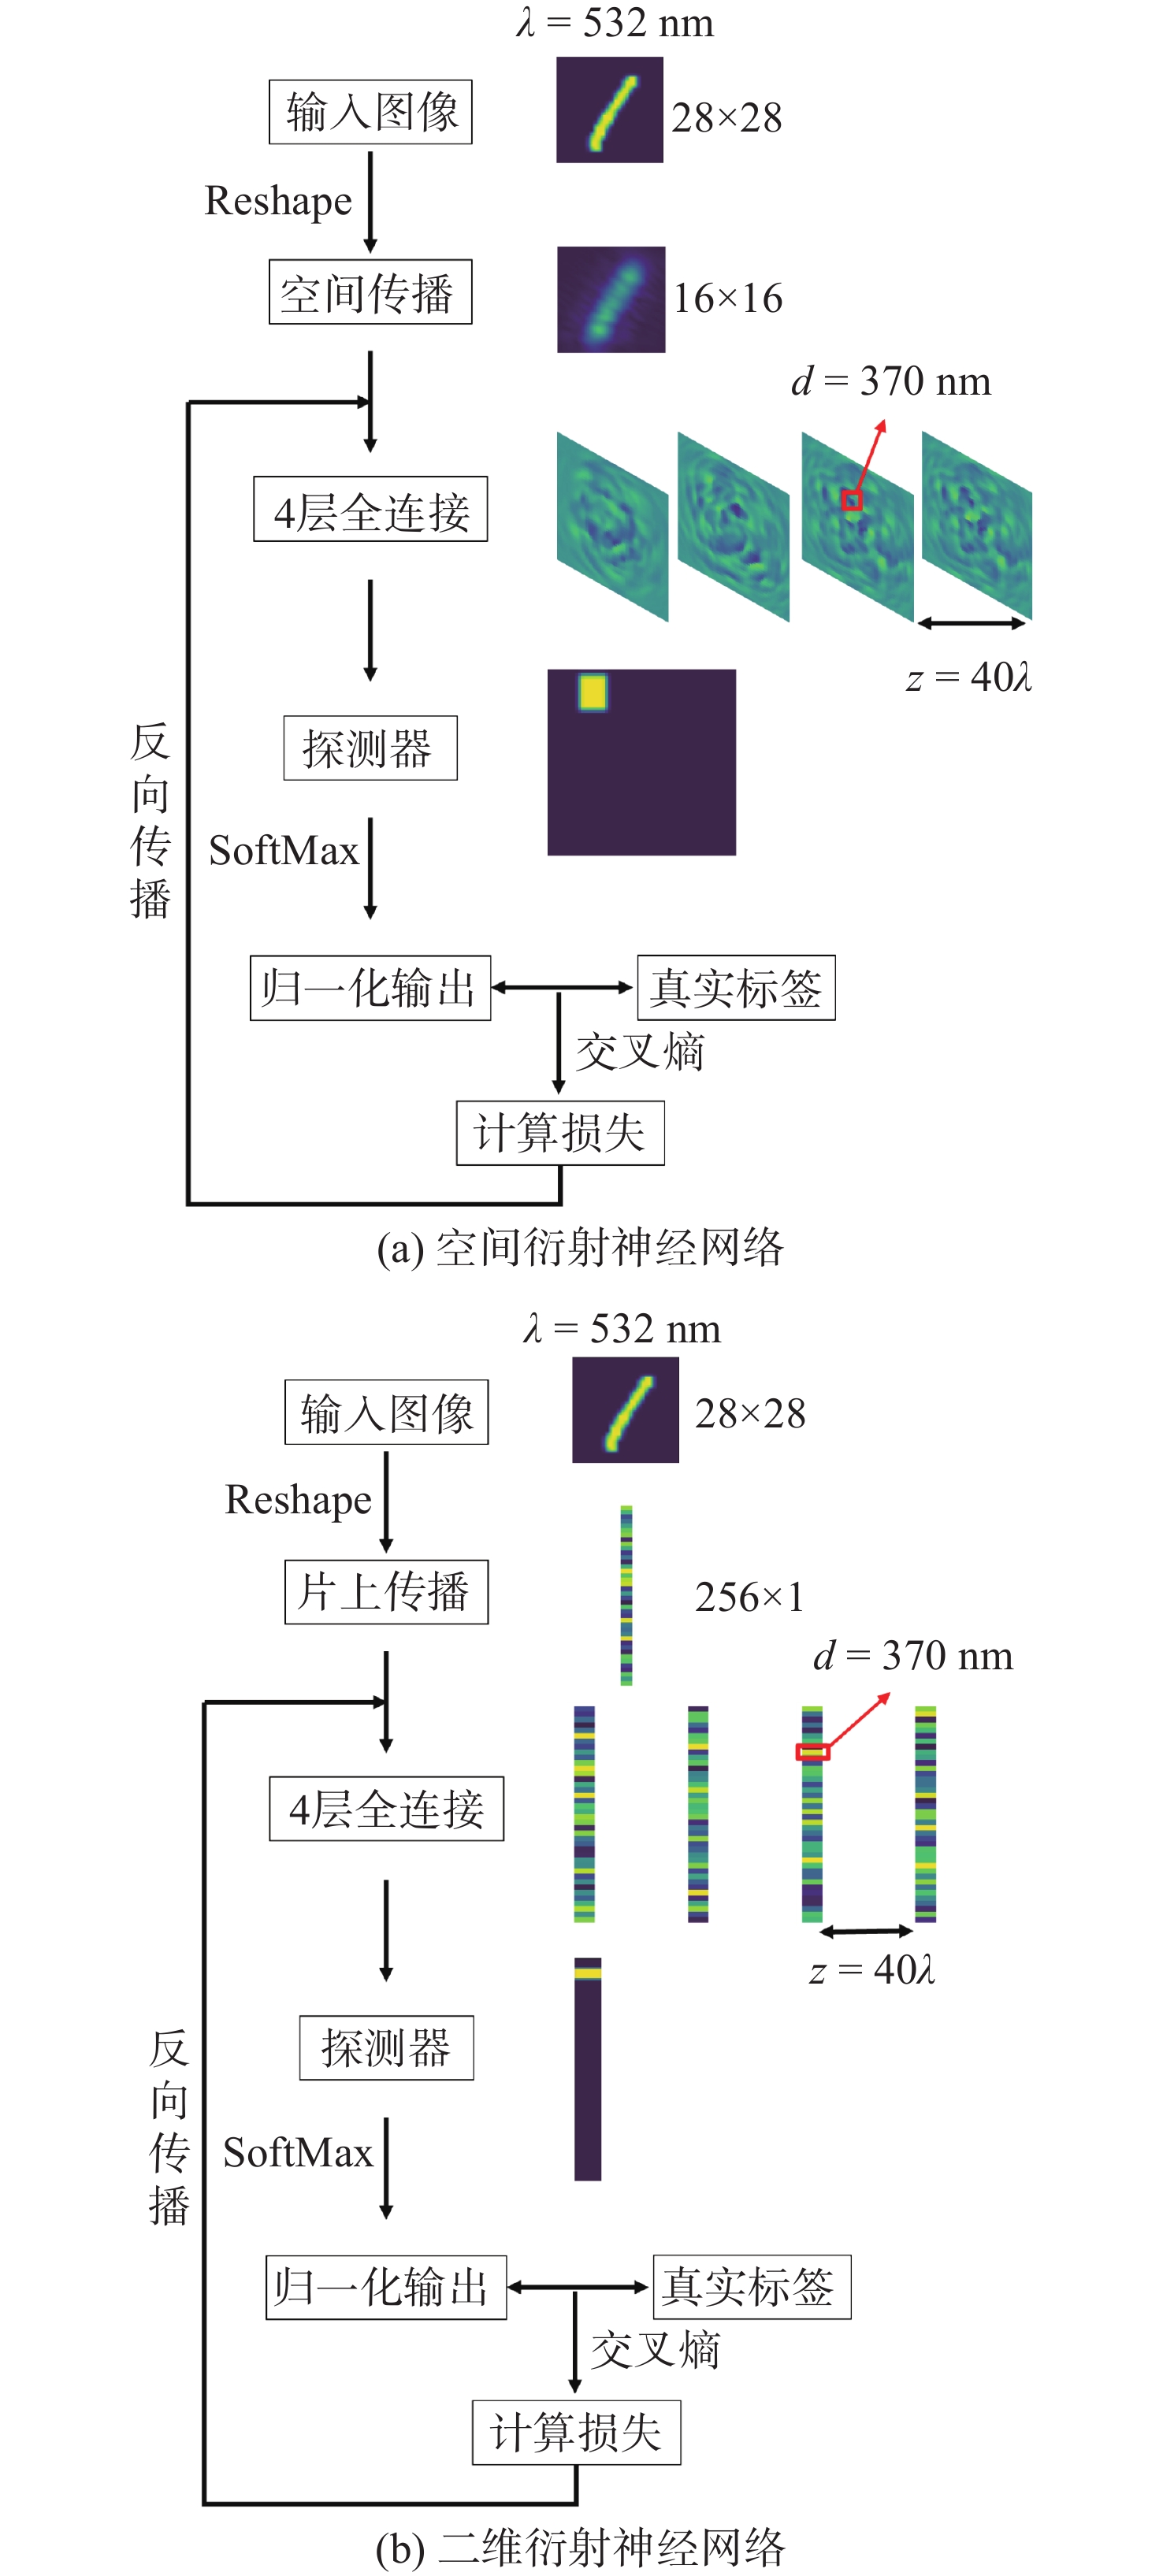
空间DNN结构如图2(a)所示,该结构由输入层、输出层和4个衍射层组成。衍射层之间的间距为40 λ。每个衍射层包含16×16个神经元,每个神经元作为独立像素,大小为370 nm。神经元接收数据集编码的光场,并通过纯相位调制进行处理和传播。在输出端,使用一个16×16的探测器阵列来捕获调制后的光信号。探测器被划分为10个区域,每个区域对应数据集中的一个标签。通过计算各区域的光强分布,系统能够识别输入的手写数字。最终,光强通过SoftMax归一化,转化为0到1的概率分布,并与真实标签相比较,计算交叉熵损失。2D DNN结构如图2(b)所示,它由输入层、输出层和4个衍射层组成,衍射层之间的间距同样为40 λ。每个衍射层由 256×1个神经元构成,每个神经元的尺寸为370 nm。每个神经元接收由数据集编码的光场,并通过纯相位调制完成调制和传播。在输出端,使用256×1的探测器阵列捕获传输并调制后的光信号。探测器被分为10个区域,每个区域对应数据集中的一个标签。通过计算探测器中不同区域的光强分布,网络能够识别输入光场中的手写数字。
|
图 2 空间衍射神经网络和二维衍射神经网络 Figure 2 Spatial diffractive neural network and two-dimensional diffractive neural network |
在MLP中,隐藏层之间的计算基于数学矩阵乘法原理;在DNN中,层间传播遵循光学矩阵乘法原理。光在空间DNN中的传播模型遵循Rayleigh–Sommerfeld衍射公式
| $ {w}_{i}(x,y,{\textit z})=\frac{{\textit z}}{{r}^{2}}\cdot \left(\frac{1}{2{\text{π}}r}+\frac{{\textit z}}{{r}^{2}}\right)\frac{1}{\mathrm{i}\lambda }\cdot {\mathrm{e}}^{\mathrm{i}\tfrac{2{\text{π}}r}{\lambda }}\cdot A{\mathrm{e}}^{\text{iΔ}\phi } $ | (1) |
式中:
| $ {w}_{i}(x,y)=\frac{1}{\text{iλ}}\cdot \left(\frac{1+\cos \theta }{2r}\right)\cdot {\mathrm{e}}^{\mathrm{i}\tfrac{2{\text{π}} r{n}_{1}}{\lambda }}\cdot A{\mathrm{e}}^{\text{iΔ}\phi } $ | (2) |
式中:
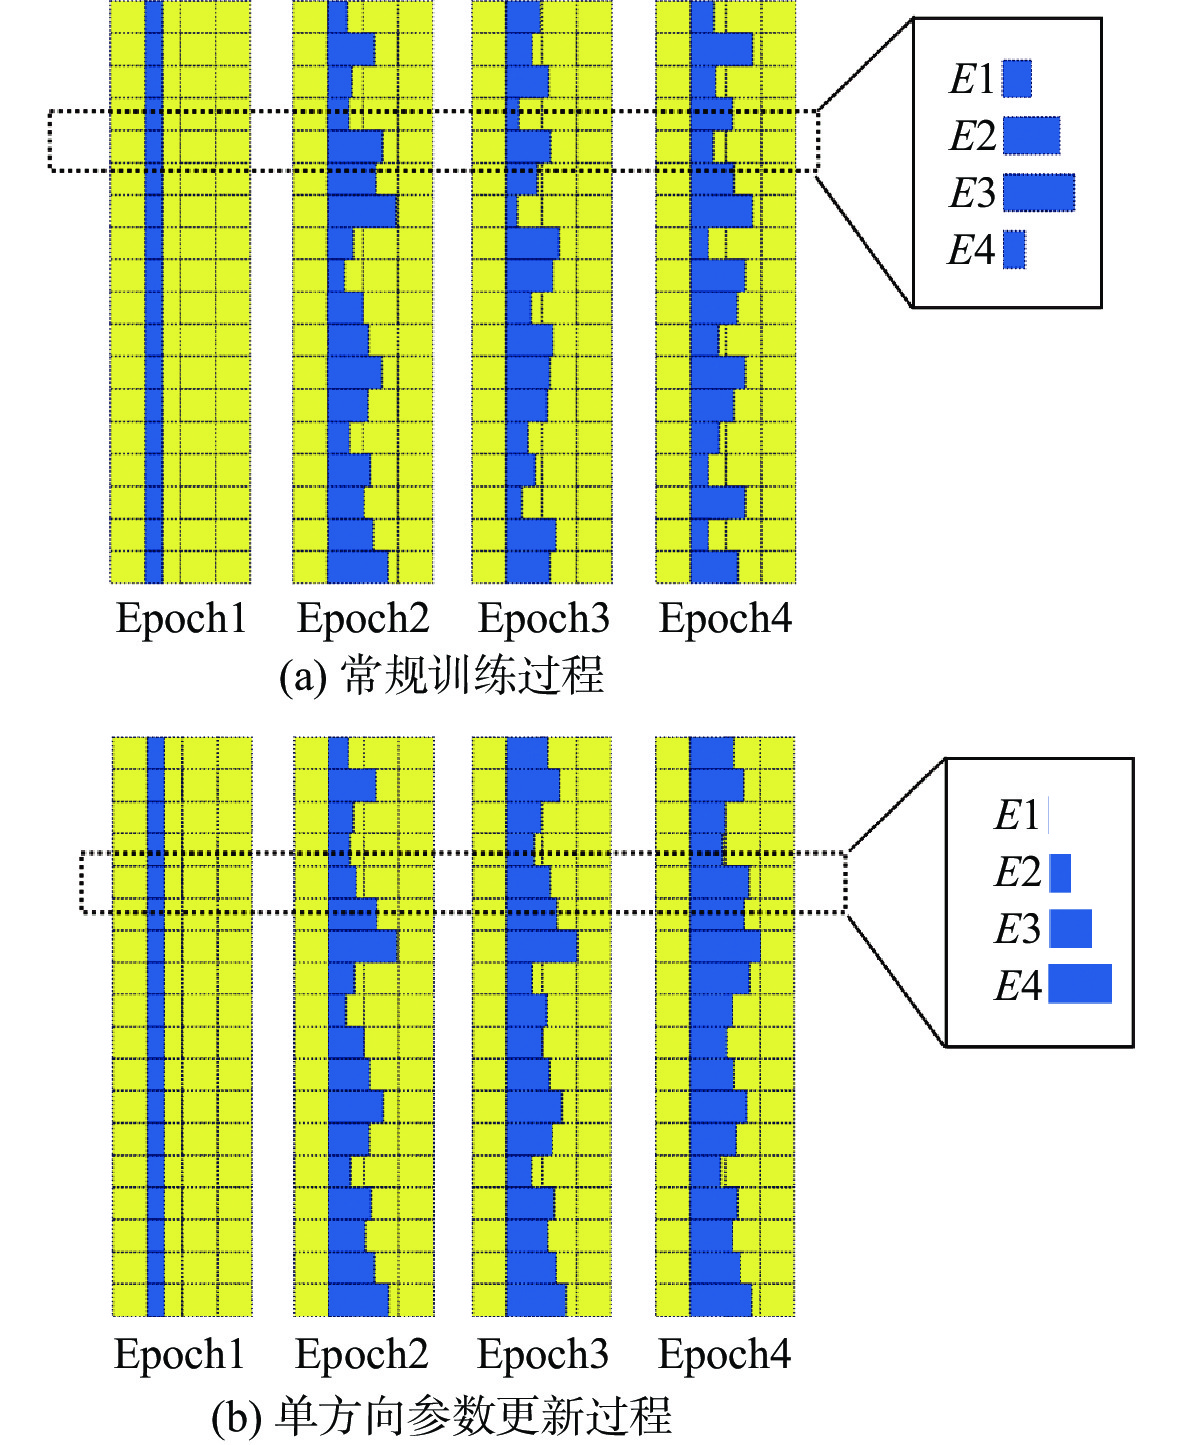
在2D DNN中,相位值作为训练参数,通常可转换为光程差,并通过物理特性(如长度或厚度)映射到物理结构中,如图3(a)中E1~E3代表学习过程中衍射神经元长度的变化过程。若要实现原位训练,则需要在训练过程中对聚合物材料进行连续的烧蚀或去除操作,这种双向的参数调整与当前制造工艺的特性存在根本性冲突。为了解决兼容性问题,本研究提出了一种适用于光学神经网络的单向参数更新策略,如图3(b)所示,它实现了制造工艺与训练方法的有机结合。在网络训练中,训练参数(相位值)通过交叉熵损失函数计算,总体目标是实现损失函数最小化。损失函数计算式为
|
图 3 常规更新策略和单方向参数更新策略 Figure 3 Standard update strategy and unidirectional parameter update strategy |
| $ L(y,{\hat y})=-\sum \limits_{i=1}^{N}{y}_{i}{\mathrm{log}} ({\hat y}_{i}) $ | (3) |
式中:
| $ {m}_{t}={\beta }_{1}\cdot {m}_{t-1}+\left(1-{\beta }_{1}\right)\cdot {g}_{t} $ | (4) |
| $ {v}_{t}={\beta }_{2}\cdot {v}_{t-1}+(1-{\beta }_{2})\cdot g_{t}^{2} $ | (5) |
接着,通过
| $ {\theta }_{t+1}={\theta }_{t}-\left|\alpha \cdot \frac{{\hat {m}}_{t}}{\sqrt{{\hat {v}}_{t}}+\epsilon }\right| $ | (6) |
式中,
神经元的密度和尺寸是网络设计中的关键参数。为分析这些参数对网络性能的影响,对比了不同网络密度下MLP、空间DNN和2D DNN的测试精度。优化了DNN和2D DNN的层间距及衍射神经元尺寸,并评估了它们在处理复杂数据方面的能力。此外,还分别在DNN和原位训练的2D DNN中引入相位误差,以此评估两种训练策略在存在制造误差条件下的适应能力。
2.1 网络架构与优化策略比较通过仿真数值比较了3种模型:MLP-1(1个隐藏层)、空间DNN和2D DNN的性能。在各模型中,衍射神经元的数量分别设置为100、256和784。MLP-1 使用ReLU激活函数,空间DNN和2D DNN采用线性结构。采用测试准确率作为性能指标,并使用3种优化策略:标准 Adam 优化器、Adam负更新策略和Adam正更新策略。实验结果如表1所示。
|
表 1 不同神经元数量和训练策略下各模型在 MNIST 数据集上的性能表现 Table 1 Performance of different models on the MNIST dataset under different neuron numbers and training strategies |
由表1可知,随着神经元数量的增加,网络的测试准确率逐步提升。在标准更新策略下,MLP-1的测试准确率在784个神经元时达到了98.19%。整体上MLP的准确率远高于DNN和2D DNN,这是因为MLP在训练过程中使用了非线性激活函数。此外,DNN和2D DNN在进行训练前会对数据做特征提取的预处理,以适应衍射层的大小,而MLP在训练过程中无需对数据集进行额外的操作,所有特征都可以参与矩阵计算。在线性网络中,空间DNN和2D DNN在神经元数量为784时,准确率均达到了90%以上。在神经元为100和256时,2D DNN的性能优于DNN。当神经元为256时,2D DNN的测试准确率比DNN高4.01%;而当神经元数量为100时,这一差距扩大至19.88%。这一结果表明,2D DNN在低神经元密度条件下表现出更高的性能优势。另一方面,将正向和负向参数更新策略应用在 MLP-1中,其准确率会大幅下降。当这两种策略应用于DNN和2D DNN时,准确率和常规更新表现相当,甚至在某些情况下会优于常规更新策略。例如,在256和784个神经元下,负向参数更新策略使空间DNN的测试准确率分别提升了1.82%和0.79%。当神经元为784个时,正向参数更新策略将2D DNN的测试准确率提高至90.46%,优于标准策略的90.13%。这一现象是因为,在MLP中被训练的参数是网络权重W和偏置b,当施加单方向参数限制时,W和b只能沿单一方向更新,可能会导致网络的权重不断积累,使得最终输出逐渐偏离最优解,从而降低了模型的分类性能。而在 DNN和2D DNN中,可训练参数是相位
在更复杂的 Fashion MNIST 数据集上,各模型的性能表现如表2所示。随着神经元数量的增加,所有模型的测试准确率均有提升,但不同模型对网络密度的敏感性存在差异。其中,MLP-1的准确率在256个神经元时达到最高,为88.97%,此时网络性能接近饱和,单纯增加神经元数量无法进一步提高准确率。DNN和2D DNN的最高测试准确率分别为83.44%和79.66%,虽然略低于MLP-1,但随着神经元数量增加,这两种模型的性能提升更显著。2D DNN的测试准确率,从100个神经元时的75.97%提升至256个神经元时的78.86%,增幅为2.89%;但当神经元数量增加至784时,准确率提升幅度不足1%,性能逐渐饱和。由此可见,256个神经元为网络复杂度和模型性能提供了最佳平衡点。此外,单向更新策略的性能与标准策略基本一致。在784个神经元的配置下,采用单向负更新的DNN和2D DNN的测试准确率分别为82.82% 和80.13%,与标准策略相差不足1%。这一结果表明,单向更新策略在光学神经网络中具有广泛的适用性。在2D DNN的256个神经元配置中,网络性能实现了准确率与网络密度的良好平衡,为后续设计提供了参考依据。
|
|
表 2 不同神经元数量和训练策略下各模型在 Fashion MNIST 数据集上的性能 Table 2 Performance of different models on the Fashion MNIST dataset under different neuron numbers and training strategies |
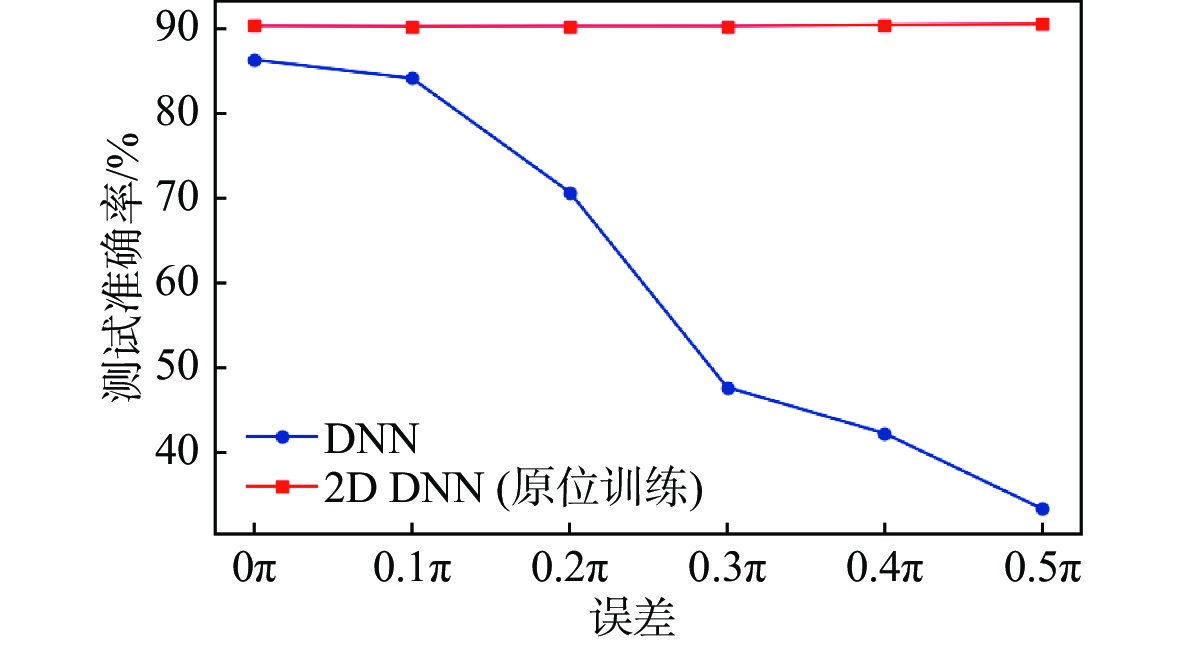
在本节研究中,分别对传统DNN和采用单方向参数更新的2D DNN进行了仿真,在结构中引入随机相位误差,用于模拟制造过程中由于工艺问题产生的误差。从完成训练的DNN中提取相位分布信息,并在其基础上添加0到0.5π的相位误差,使用测试数据集进行验证。随后,在2D DNN 的训练过程中引入相同范围的噪声,以模拟原位训练(in-situ training)过程存在的误差,并评估其在制造误差影响下的适应能力,结果如图4所示。
|
图 4 DNN和原位训练2D DNN在不同误差下的对比 Figure 4 Comparison of DNN and in-situ trained 2D DNN under different errors |
其中,DNN的准确率随着误差增加急剧下降,表现出极强的误差敏感性。而采用原位训练的2D DNN在0至0.5π的误差范围内,测试准确率始终维持在90.15%~90.39%,几乎不受误差影响。这种显著的差异主要源于训练策略的不同,DNN采用先训练后打印的方法,制造误差无法在训练过程中被补偿,因此在测试阶段当误差累积时,分类性能迅速下降。而2D DNN通过原位训练,在制造误差环境下进行学习,使得模型在训练过程中能够自适应误差并将其纳入优化,因此即使误差不断累积,测试准确率依然稳定,展示出对制造误差的鲁棒性。
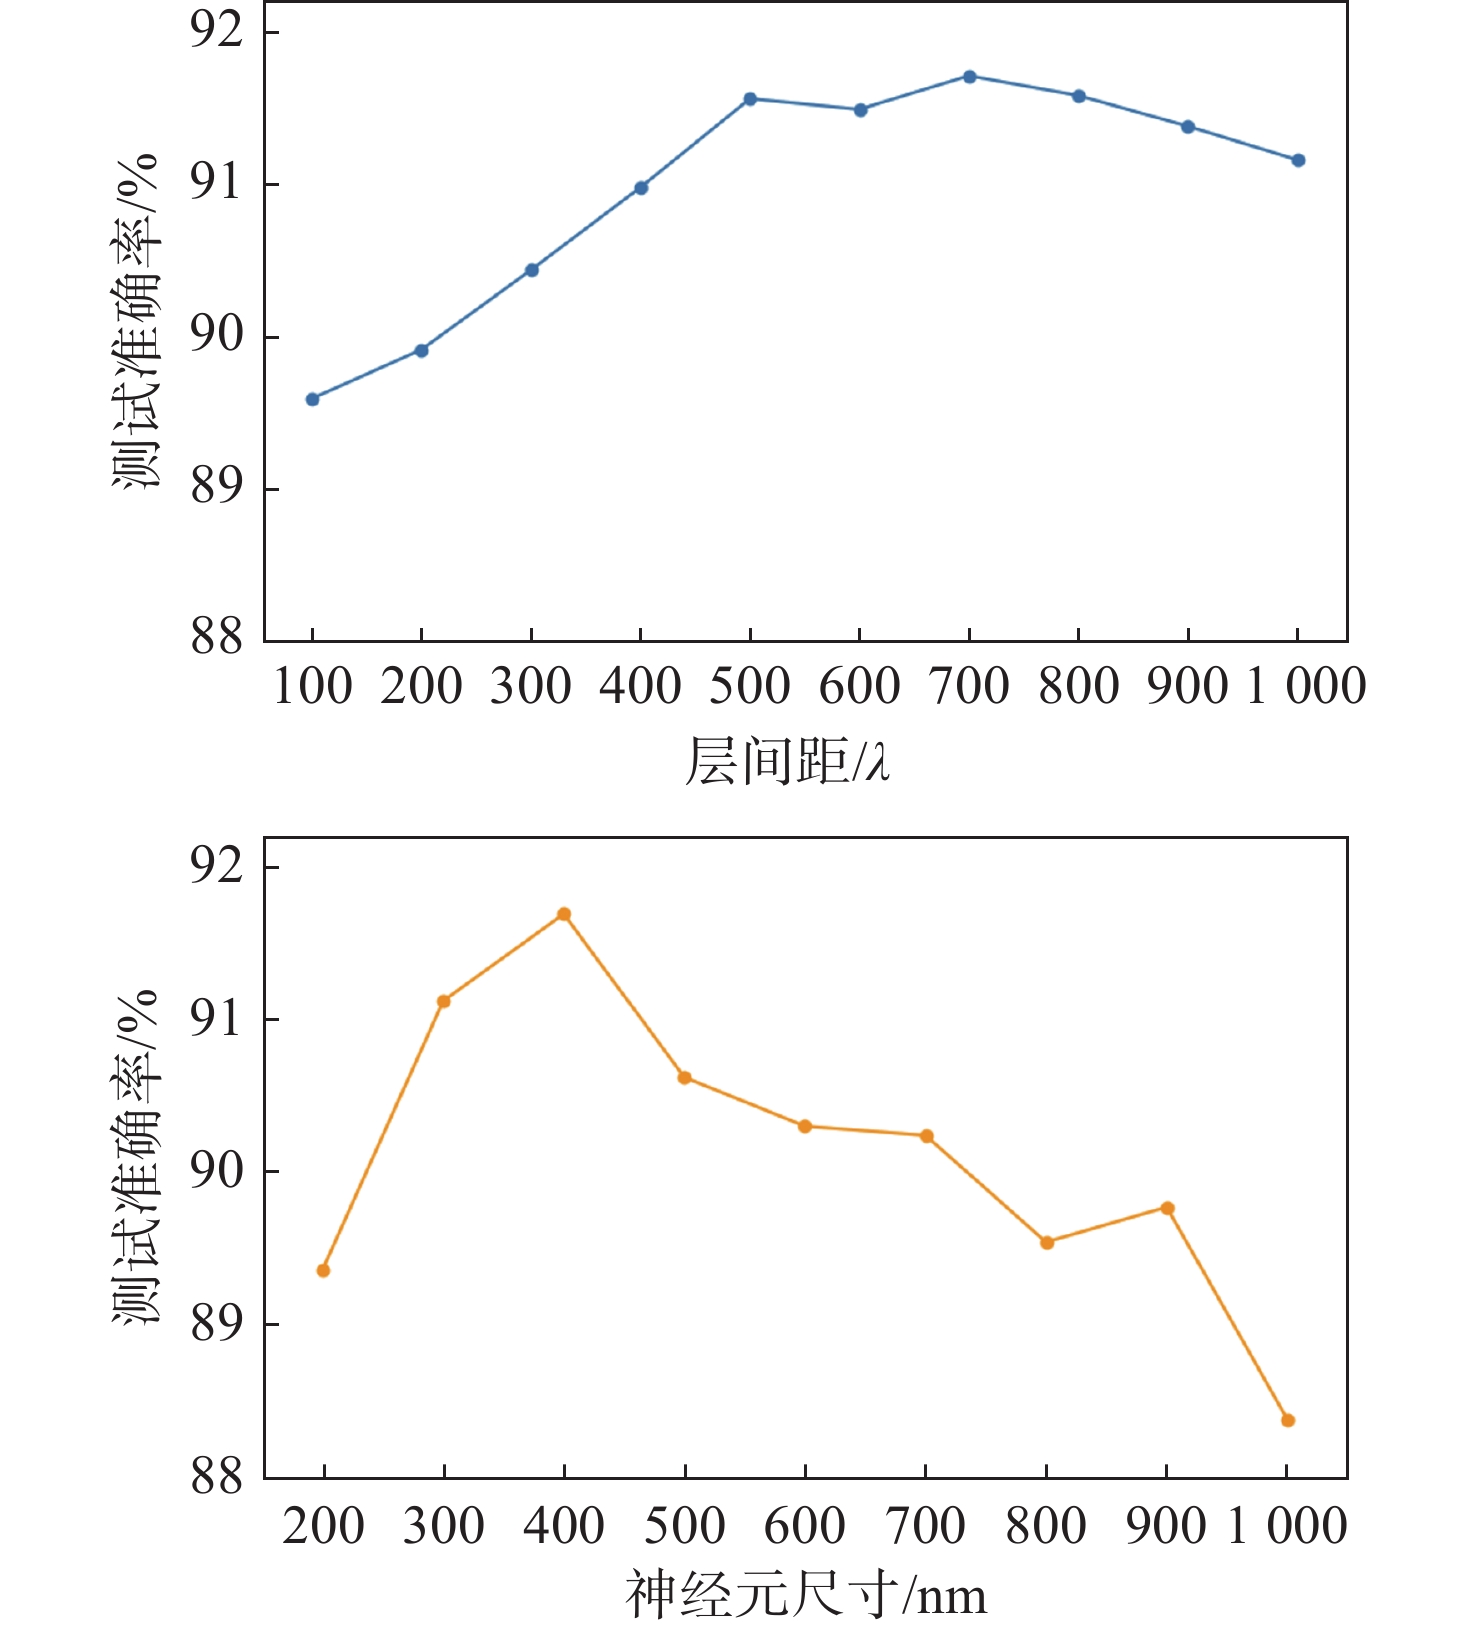
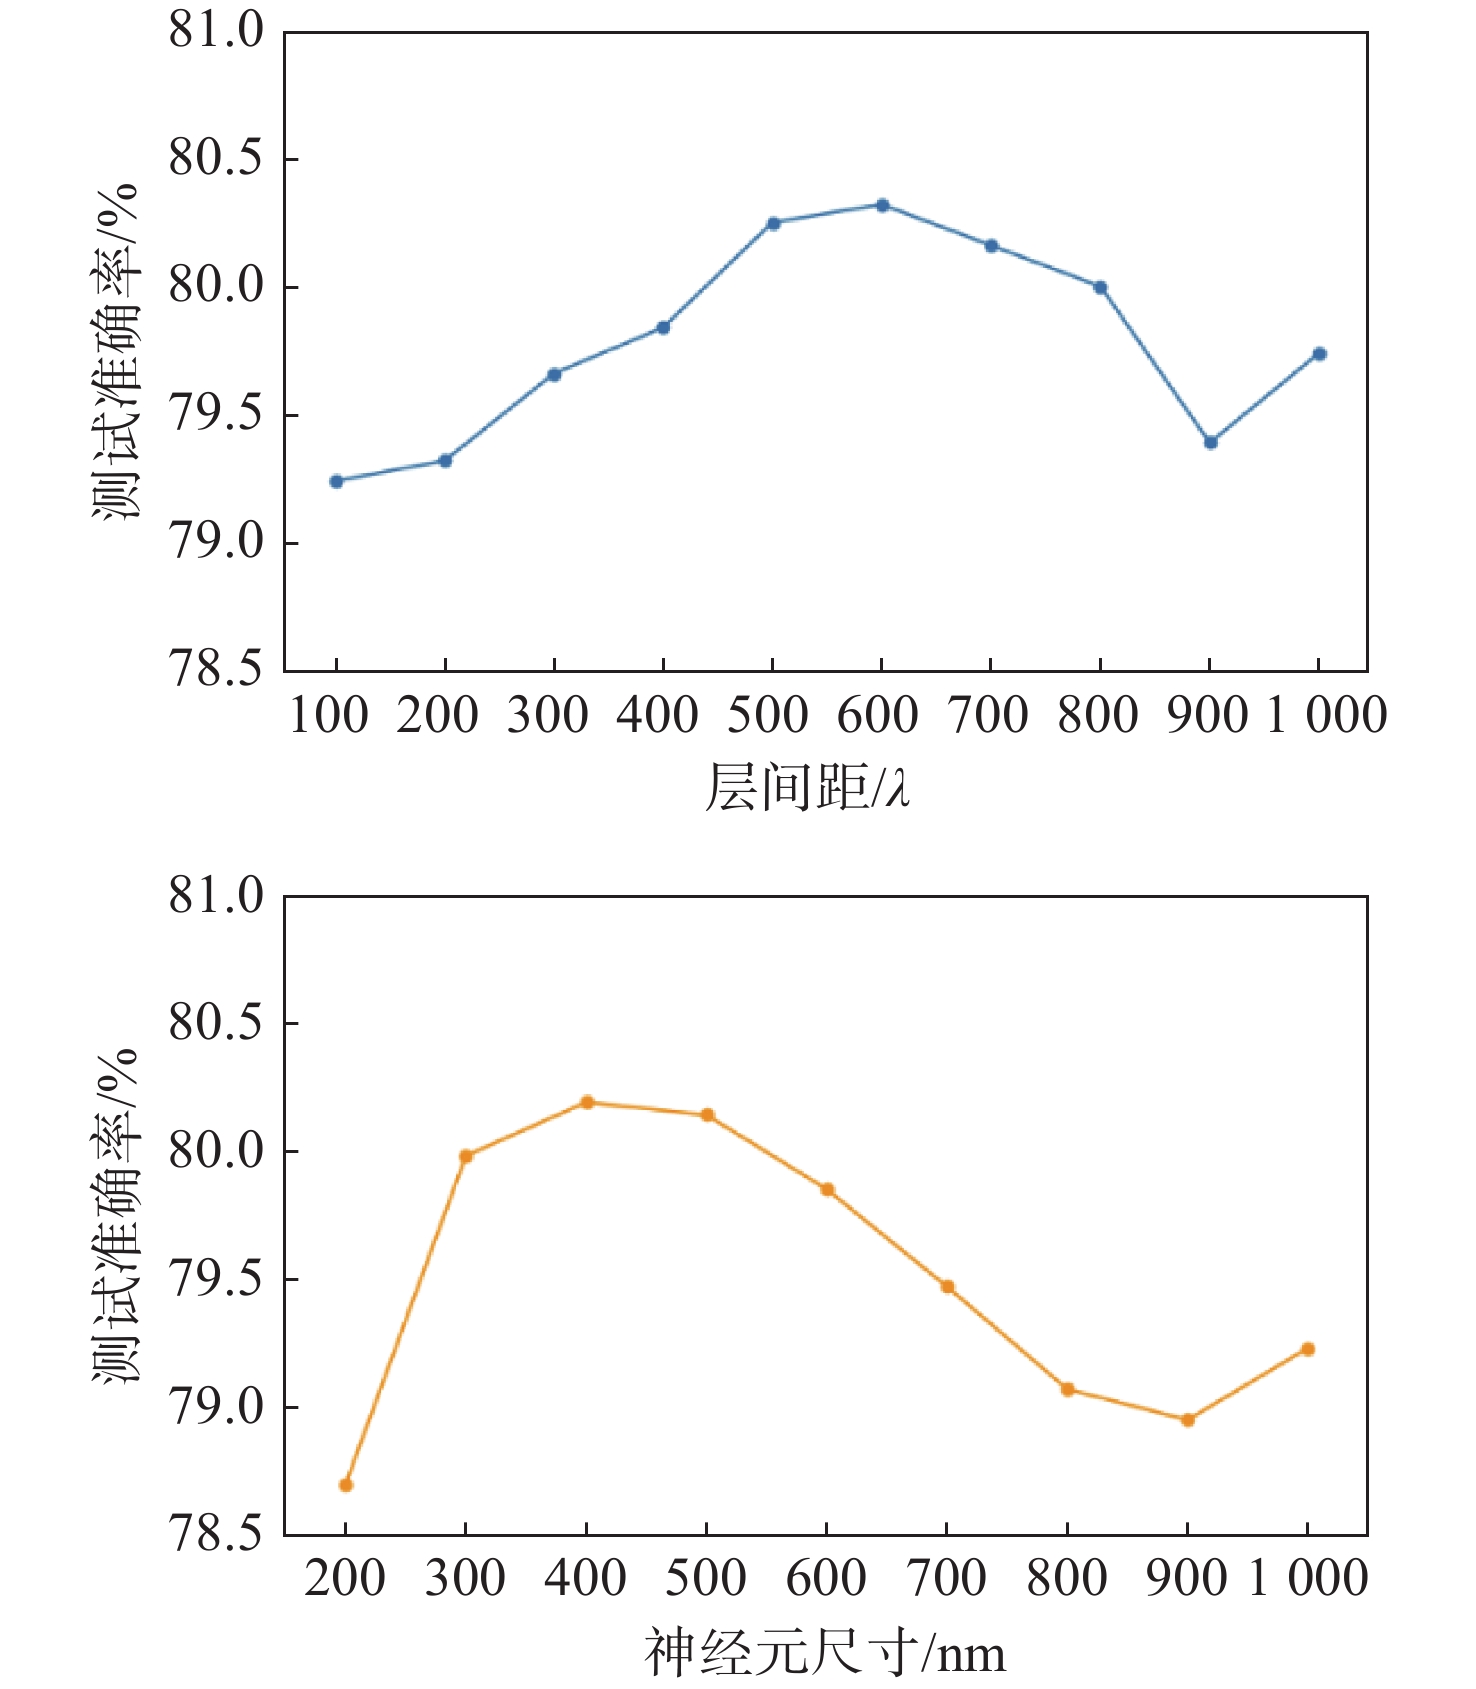
2.3 2D DNN中的参数优化基于MNIST和Fashion MNIST数据集,优化了2D DNN的两个关键参数:层间距和神经元尺寸。这些参数不仅决定了激光烧蚀工艺中的物理结构,还直接影响了2D DNN的集成尺寸和整体制造工艺的可行性。图5和图6所示为测试准确率随层间距及衍射神经元尺寸的变化趋势,其中层间距取值范围为100λ~900λ(53.2~478.0 μm)。在MNIST 数据集中,测试准确率随着层间距的增加而逐步提高,并在层间距为700λ(372 μm)时达到最高值(91.71%)。当层间距进一步增大时,准确率开始下降。
|
图 5 MNIST数据集中二维衍射神经网络中的参数优化 Figure 5 Parameter optimization of 2D diffractive neural network on the MNIST dataset |
|
图 6 Fashion MNIST数据集中二维衍射神经网络中的参数优化 Figure 6 Parameter optimization of 2D diffractive neural network on the Fashion MNIST dataset |
在Fashion MNIST数据集中,最佳层间距为600λ(319 μm)。结果表明,层间距对2D DNN 的分类性能具有显著影响,不同任务的最佳参数存在一定差异。固定层间距(z = 372 μm)后,进一步研究了神经元尺寸对测试准确率的影响。在 MNIST 数据集中,当神经元大小为400 nm时,测试准确率最高达到91.70%。神经元尺寸超过400 nm后,准确率逐渐下降,并在神经元尺寸增大至1 000 nm 时降至88.39%。在 Fashion MNIST 数据集中,分类性能呈现类似趋势,在神经元大小为400 nm 时,也获得了最佳准确率。上述结果表明,合理选择神经元尺寸对于网络性能的保持至关重要,过大的神经元尺寸可能会削弱光信号的有效传输和处理能力。
3 结 论本研究提出了一种单方向参数更新策略,并将其分别应用于空间DNN和2D DNN。结果表明,单方向参数更新策略可有效适用于ONN,性能表现与传统双向更新策略相当。本研究还在DNN和原位训练的2D DNN中引入相位误差,以此评估两种训练策略在存在制造误差条件下的适应能力。结果表明,采用单方向参数更新的2D DNN可在训练过程中将误差纳入学习过程,具有更高的鲁棒性。为进一步优化2D DNN的结构,本研究系统分析了不同层间距(53.2~478 μm)与神经元尺寸(200~1 000 nm)对网络在MNIST和Fashion MNIST数据集上测试准确率的影响。采用单方向参数更新的2D DNN实现了训练方法与制造工艺的有机结合,为原位训练 2D DNN 提供了理论支撑与技术实现路径。未来工作可进一步探索利用聚合物[21]、石墨烯[22-23]或相变材料[24]等新型材料,构建ONN的物理结构。此类材料凭借独特的光学和热学性能,具备在激光灼烧[25]等加工技术中实现高精度神经元设计的潜力,可为高效、低功耗的光学神经网络的构建提供新的思路,有望推动原位训练光学神经网络从理论研究迈向实际应用。
| [1] | NGUYEN D H, WIDROW B. Neural networks for self-learning control systems[J]. IEEE Control Systems Magazine, 1990, 10(3): 18–23. DOI:10.1109/37.55119 |
| [2] | SILVER D, HUANG A, MADDISON C J, et al. Mastering the game of Go with deep neural networks and tree search[J]. Nature, 2016, 529(7587): 484–489. DOI:10.1038/nature16961 |
| [3] | SUN J Q, LI J. Few-shot classification with Fork Attention Adapter[J]. Pattern Recognition, 2024, 156: 110805. DOI:10.1016/J.PATCOG.2024.110805 |
| [4] | KRIZHEVSKY A, SUTSKEVER I, HINTON G E. ImageNet classification with deep convolutional neural networks[C]//Proceedings of the 26th Annual Conference on Neural Information Processing Systems. Lake Tahoe: Curran Associates Inc. , 2012. |
| [5] | BROWN T B, MANN B, RYDER N, et al. Language models are few-shot learners[C]//Proceedings of the 34th International Conference on Neural Information Processing Systems. Vancouver: Curran Associates Inc., 2020: 159. |
| [6] | ESTEVA A, KUPREL B, NOVOA R A, et al. Dermatologist-level classification of skin cancer with deep neural networks[J]. Nature, 2017, 542(7639): 115–118. DOI:10.1038/nature21056 |
| [7] | JOUPPI N P, YOUNG C, PATIL N, et al. In-datacenter performance analysis of a tensor processing unit[C]//Proceedings of the 44th Annual International Symposium on Computer Architecture. Toronto: IEEE, 2017: 1 − 12. |
| [8] | LI H M, FAN X T, JIAO L, et al. A high performance FPGA-based accelerator for large-scale convolutional neural networks[C]//2016 26th International Conference on Field Programmable Logic and Applications. Lausanne: IEEE, 2016: 1 − 9. |
| [9] | SHEN Y C, HARRIS N C, SKIRLO S, et al. Deep learning with coherent nanophotonic circuits[J]. Nature Photonics, 2017, 11(7): 441–446. DOI:10.1038/nphoton.2017.93 |
| [10] | CHENG J W, HUANG C R, ZHANG J L, et al. Multimodal deep learning using on-chip diffractive optics with in situ training capability[J]. Nature Communications, 2024, 15(1): 6189. DOI:10.1038/s41467-024-50677-3 |
| [11] | XUE Z W, ZHOU T K, XU Z H, et al. Fully forward mode training for optical neural networks[J]. Nature, 2024, 632(8024): 280–286. DOI:10.1038/s41586-024-07687-4 |
| [12] | LIN X, RIVENSON Y, YARDIMCI N T, et al. All-optical machine learning using diffractive deep neural networks[J]. Science, 2018, 361(6406): 1004–1008. DOI:10.1126/science.aat8084 |
| [13] | GOI E, SCHOENHARDT S, GU M. Direct retrieval of Zernike-based pupil functions using integrated diffractive deep neural networks[J]. Nature Communications, 2022, 13(1): 7531. DOI:10.1038/s41467-022-35349-4 |
| [14] | KAZAZIS D, SANTACLARA J G, VAN SCHOOT J, et al. Extreme ultraviolet lithography[J]. Nature Reviews Methods Primers, 2024, 4(1): 84. DOI:10.1038/s43586-024-00361-z |
| [15] | ZHU H H, ZOU J, ZHANG H, et al. Space-efficient optical computing with an integrated chip diffractive neural network[J]. Nature Communications, 2022, 13(1): 1044. DOI:10.1038/s41467-022-28702-0 |
| [16] | FU T Z, ZANG Y B, HUANG Y Y, et al. Photonic machine learning with on-chip diffractive optics[J]. Nature Communications, 2023, 14(1): 70. DOI:10.1038/s41467-022-35772-7 |
| [17] | WANG Z, CHANG L, WANG F F, et al. Integrated photonic metasystem for image classifications at telecommunication wavelength[J]. Nature Communications, 2022, 13(1): 2131. DOI:10.1038/s41467-022-29856-7 |
| [18] | GU Z, MA Q, GAO X X, et al. Direct electromagnetic information processing with planar diffractive neural network[J]. Science Advances, 2024, 10(29): eado3937. DOI:10.1126/sciadv.ado3937 |
| [19] | POPESCU M C, BALAS V E, PERESCU-POPESCU L, et al. Multilayer perceptron and neural networks[J]. WSEAS Transactions on Circuits and Systems, 2009, 8(7): 579–588. |
| [20] | KINGMA D P, BA J. Adam: a method for stochastic optimization[C]//Proceedings of the 3rd International Conference on Learning Representations. San Diego: ICLR, 2015. |
| [21] | 刘帆, 隋国荣. 基于SU-8聚合物波导的多模干涉型RGB合波器[J]. 光学仪器, 2021, 43(3): 9–15. |
| [22] | 王金凤, 李辩, 孙明宇. 激光直写氧化石墨烯可调光子筛[J]. 光学仪器, 2023, 45(6): 68–75. DOI:10.3969/j.issn.1005-5630.202303030036 |
| [23] | KIM J T, CHOE J H, KIM J S, et al. Graphene-based plasmonic waveguide devices for electronic-photonic integrated circuit[J]. Optics & Laser Technology, 2018, 106: 76–86. DOI:10.1016/j.optlastec.2018.03.021 |
| [24] | NISAR M S, YANG X, LU L J, et al. On-chip integrated photonic devices based on phase change materials[J]. Photonics, 2021, 8(6): 205. DOI:10.3390/photonics8060205 |
| [25] | KAPPES R S, SCHÖNFELD F, LI C, et al. A study of photothermal laser ablation of various polymers on microsecond time scales[J]. SpringerPlus, 2014, 3(1): 489. DOI:10.1186/2193-1801-3-489 |