DBAIE:spatial-spectral double-branch attention interaction encoder for hyperspectral image classification
School of Optical-Electrical and Computer Engineering, University of Shanghai for Science and Technology, Shanghai 200093, China
高光谱图像(hyperspectral image,HSI)由高光谱遥感仪采集从可见光到短红外波段内的上百个光谱波段得到,光谱分辨率达纳米级。图像中的每个像素均含有上百个不同波段的反射信息,从而可以提供一条对应地面目标的连续光谱曲线。因此,高光谱图像蕴含着丰富且精细的空间和光谱信息。目前,高光谱遥感成像技术已经应用在军事目标检测[1]和无损检测[2]等领域,高光谱图像分类也成为其中的一个研究热点。不同于自然图像分类,高光谱图像分类是依据样本特征为每一个像素赋予类别标签。但HSI存在标记样本困难、维数高、非线性强以及混合像元等问题。某些关键区域,由于目标面积较小,难以提供充足的训练样本。在样本量有限的情况下,高维数据特征空间难以被充分覆盖,导致分类器训练精度显著下降,从而引发休斯现象[3]。传统的HSI分类方法大多侧重于探索光谱特征在分类过程中的作用,典型的机器学习方法包括K–邻近法(K-NN)和支持向量机(SVM)。此外,针对HSI光谱波段多、信息冗余的问题,降维是常用方法,如采用主成分分析(principal components analysis,PCA)。这些方法忽略了邻近像素的空间相关性,导致空间特征利用不足,仅能提取HSI的浅层特征,难以挖掘深层的抽象特征,从而限制了分类精度的提升。
深度学习算法在图像分类、目标检测、自然语言处理等计算机视觉领域取得了一些突破。深度学习可提取高光谱图像的深层特征,因此基于深度学习的高光谱图像分类任务备受关注,成为热门研究方向。Zhao等[4]提出使用PCA对高维HSI降维后,再用2D-CNN(two-dimensional convolutional neural network)对空间特征信息进行提取,并结合光谱信息进行分类。为了更好地同时提取空间–光谱特征,Hamida等[5]提出使用3D-CNN结构,并取得了很好的分类结果。Roy等[6]结合3D-CNN和2D-CNN的特点,设计了一种能够降低复杂度,并能保证分类精度的网络结构。Li等[7]采用空间注意力和通道注意力分别对空间–光谱进行特征提取,提高了分类准确率。Zhang等[8]设计了一种三重注意力残差网络以关注不同波段特征在高光谱图像分类任务中的重要性。尽管这些网络在高光谱图像分类任务上取得了显著的效果,但仍缺少表征序列光谱数据的能力,无法利用光谱维度的中期和长期依赖关系。
由于Transformer模型在图像处理领域表现良好,Hong等[9]采用光谱相邻分组光谱嵌入(groupwise spectral embedding,GSE)策略对输入通道进行预处理,并设计了一个跨模态注意力融合(cross-modal attention fusion,CAF)编码器来深度挖掘分组后光谱特征的跨层依赖关系。近年来,CNN与视觉转换器(vision transformer,ViT)的联合使用成为热门的研究方向,Sun等[10]搭建了一个同时使用了3D-CNN、2D-CNN和ViT的网络结构。该结构利用CNN网络提取浅层光谱空间特征,利用高斯特征加权器进行特征映射,利用ViT来获取深度语义特征并进行分类,该网络结构取得了很好的分类效果。Mohamed等[11]为克服Transformer需要大规模数据训练的问题,提出了一种新的因子分解自监督模型。该模型忽略了空间特征和光谱特征之间的内在联系及差异。
为了解决上述网络模型存在的不足,本文提出了一种基于空间–光谱双分支注意力交互编码(double-branch attention interaction encoder,DBAIE)的高光谱图像网络。首先利用空间–光谱双分支注意力机制(double-branch attention mechanism,DBAM)模块对空间–光谱特征分别进行提取,空间–光谱双特征交互编码(spatial-spectral dual-featurel interaction encoder,SSDIE)模块对空间–光谱特征进行交互作用,以增强特征的类别表达。最后,利用Transformer Encoder(TE)模块捕获全局序列特征并进行分类,将所设计的网络与多个先进的分类模型在3个公开数据集上进行性能比较,其在整体分类精度、平均分类精度和Kappa系数上都表现出显著优势。
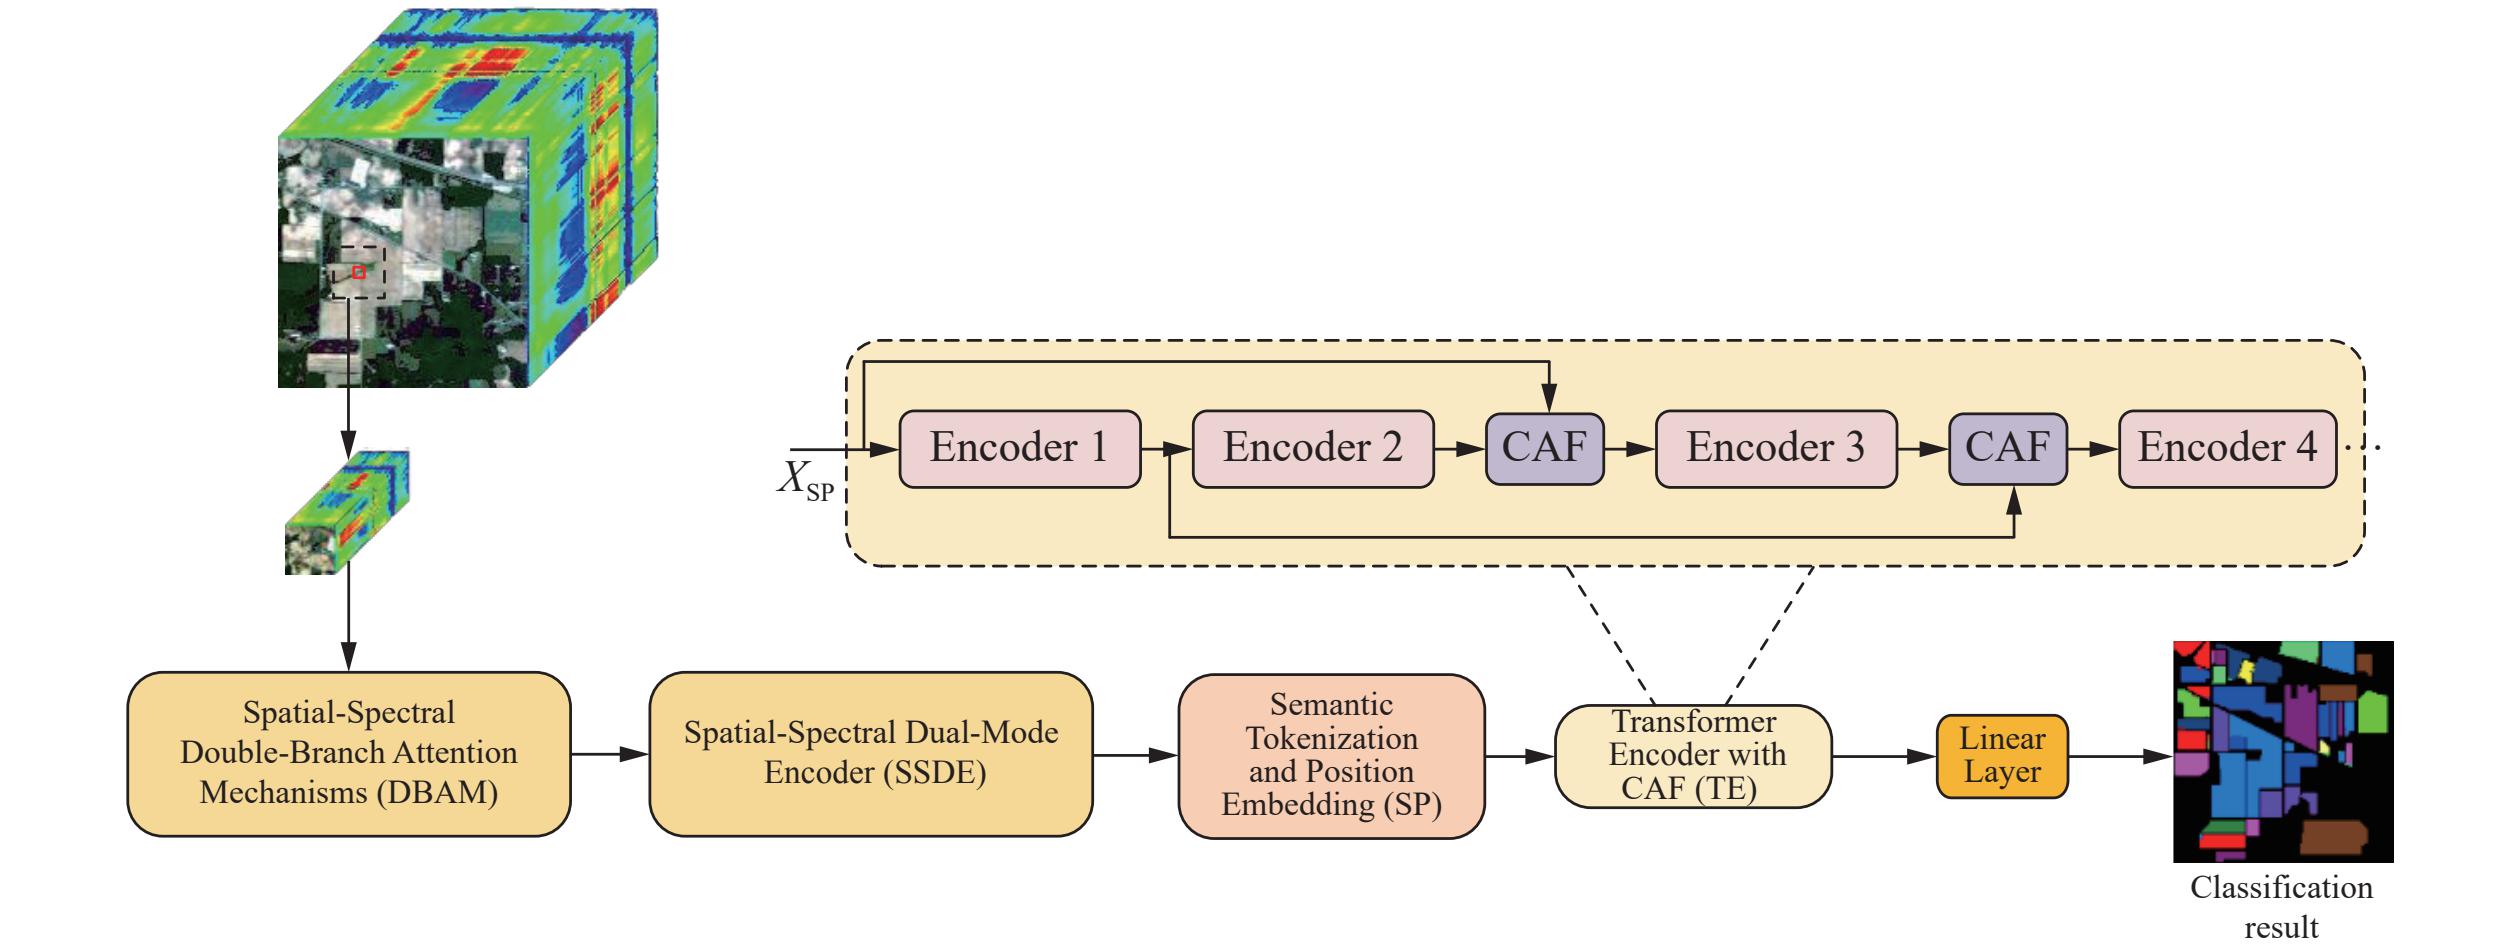
1 DBAIE-Net DBAIE的整体网络框架如图1所示。将原始数据输入到DBAM模块,同时进行空间–光谱双特征提取。在SSDIE模块对提取的特征进行交互作用,以此来增强两种特征的类别表达能力。特征经语义标记和位置嵌入模块(SP)进行语义表达能力增强后,输入到带有跨层自适应模块(CAF)的TE模块以获取特征的长期依赖关系。最后,利用线性层输出分类结果。
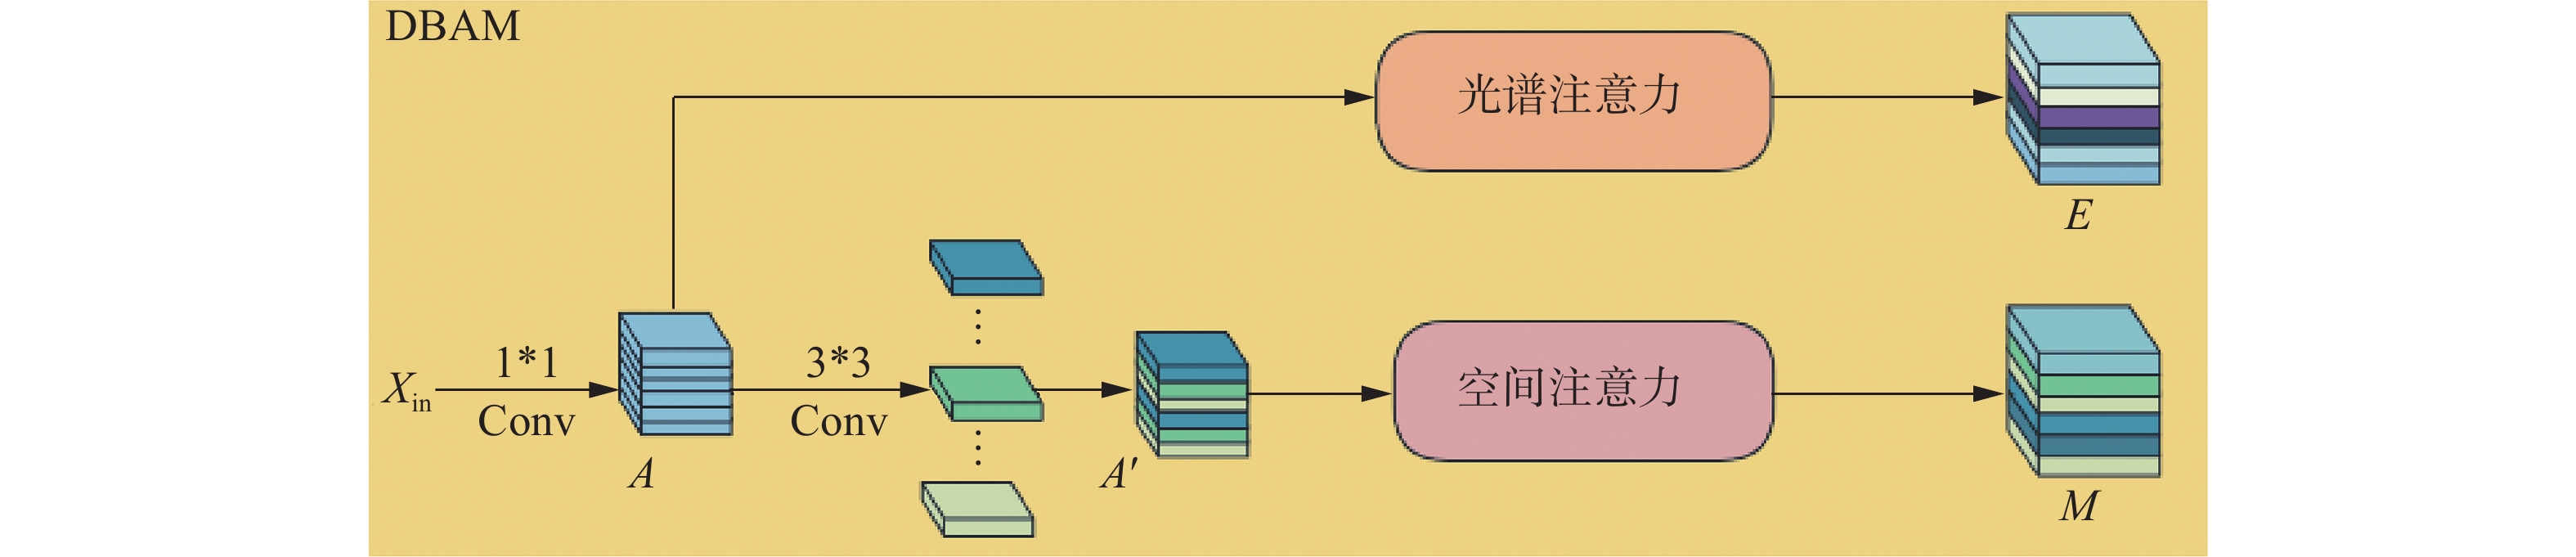
1.1 空间–光谱双分支注意力机制 原始数据Xin$ \in $RB×w×w,其中w为窗口大小,B为光谱通道数。采用一个1×1的2D卷积来实现不同光谱通道之间的信息交互,得到输入信息A$ \in $RC×w×w,其中C为通道数量。再对A进行一次3×3的2D卷积来进一步提取不同通道之间的局部空间特征,得到输出信息A′$ \in $RC×w×w,并将A和A′分别输入到光谱分支和空间分支进行特征提取。其结构示意图见图2。
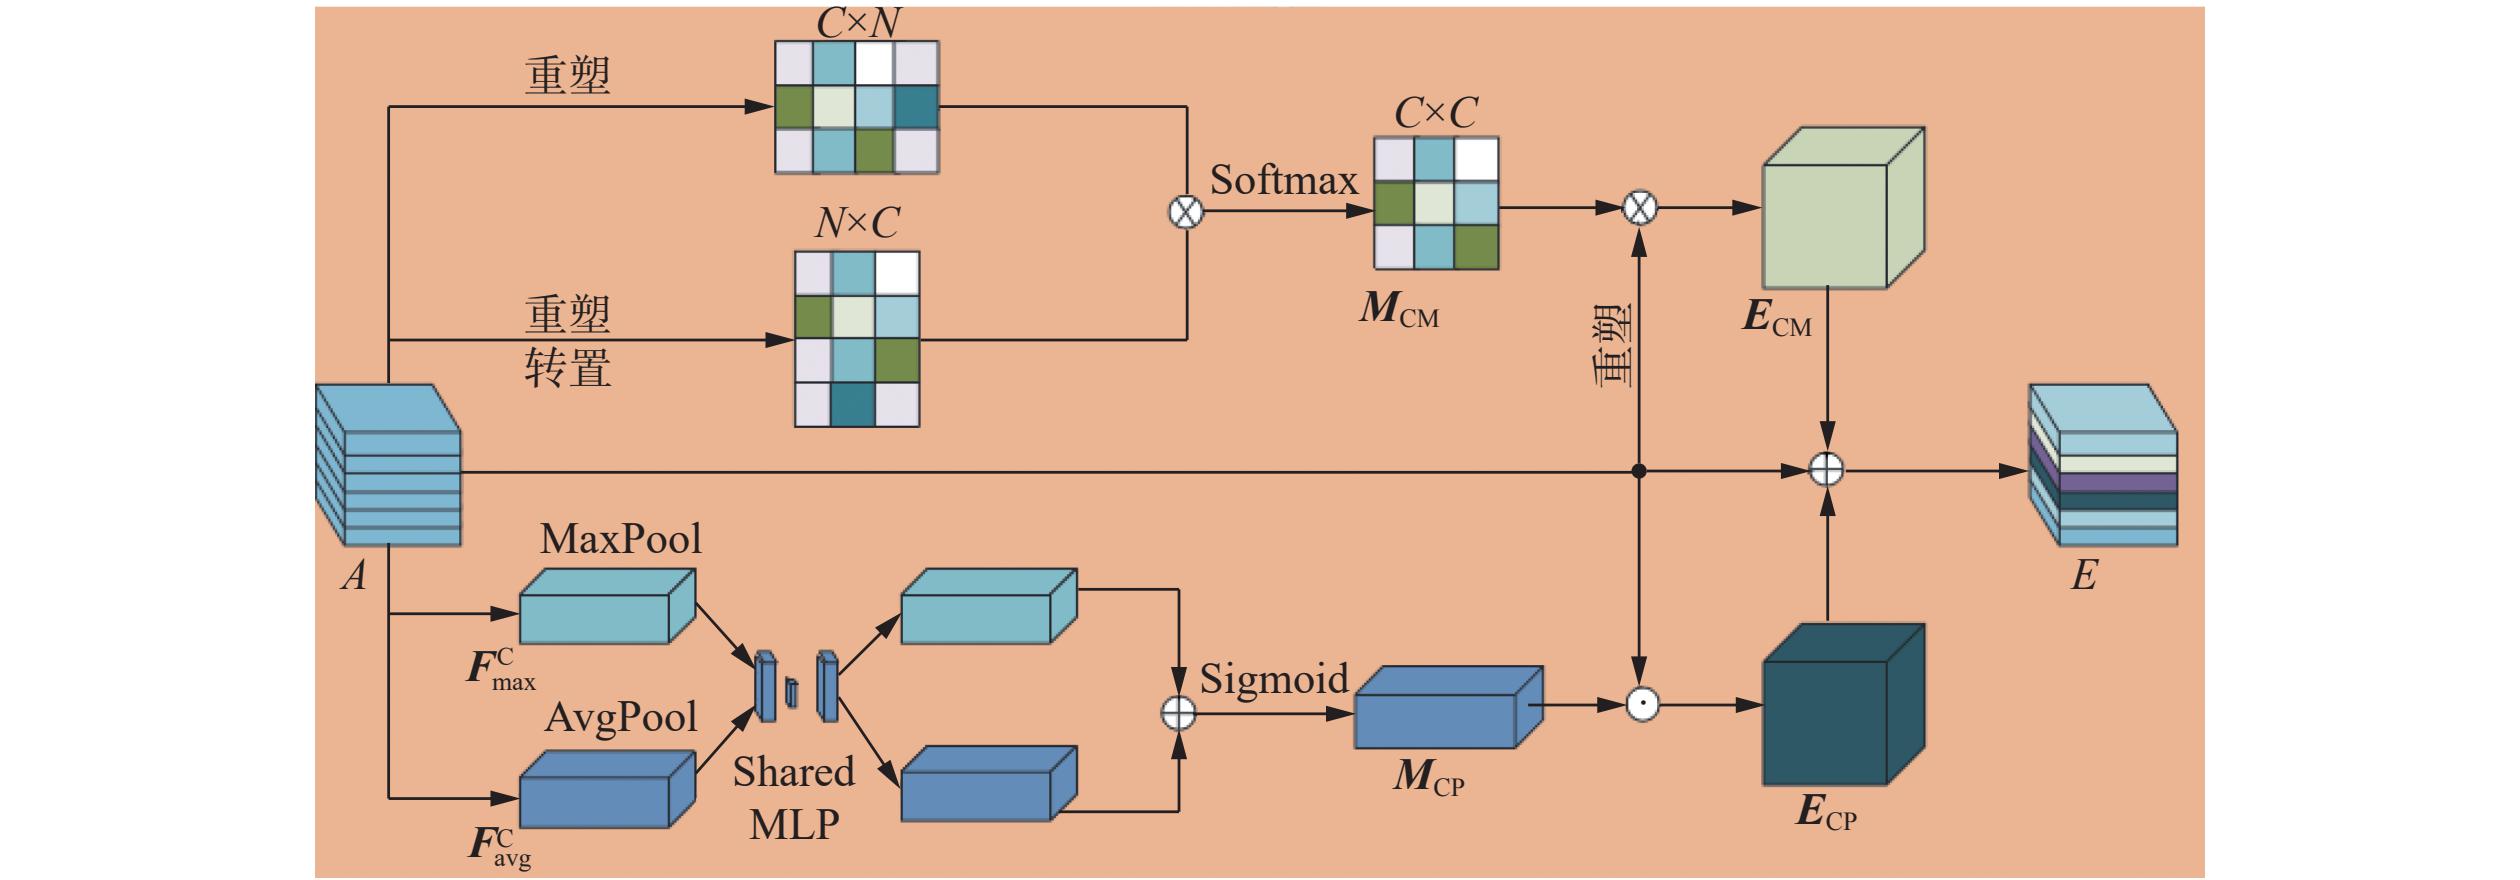
在光谱分支中采用所设计的光谱通道注意力对光谱通道之间的相互依赖关系进行建模,其结构示意图见图3。像素点之间的光谱相似性矩阵MCM$ \in $RC×C是由A及AT通过矩阵相乘,并经过一个softmax层得到
|
$ {x}_{ji}=\frac{\exp \left({A}_{i}\times {A}_{j}\right)}{\displaystyle\sum\limits_{i=1}^{C}\exp \left({A}_{i}\times {A}_{j}\right)} $
|
(1) |
式中,xji为第i通道对第j通道的影响。将MCM与A再次进行矩阵相乘,得到ECM$ \in $RC×w×w,其过程可用公式表示为
|
$ {E}_{j}=\displaystyle\sum\limits_{i=1}^{C}\left({x}_{ji}{A}_{j}\right) $
|
(2) |
全局级注意力是将每一个通道的全局特征进行平均池化和最大池化信息聚合[12],生成两个特征向量:$ {\boldsymbol{F}}_{{\mathrm{avg}}}^{C} $和$ {\boldsymbol{F}}_{\max }^{C} $。随即将其输入到多层感知注意力机中,并经过sigmoid激活函数得到全局的光谱相似性矩阵$ {{\boldsymbol{M}}}_{{\mathrm{CP}}}\in {{\bf{R}}}^{1\times C} $,与A点乘得到$ {{\boldsymbol{E}}}_{{\mathrm{CP}}}\in {{{{\bf{R}}}}}^{C\times w\times w} $。这个过程可以表示为
|
$ \begin{split}
{\boldsymbol{E}}_{{\mathrm{CP}}} = &\text{sigmoid}\left(\text{MLP}\left(\text{AvgPool}(A)\right) +\right.\\&\left. \text{MLP}\left(\text{MaxPool}(A)\right)\right) \odot A
= \\& \text{sigmoid}\left(\text{MLP}\left({\boldsymbol{F}}_{\text{avg}}^C\right) +\right.\\&\left. \text{MLP}\left({\boldsymbol{F}}_{\text{max}}^C\right)\right) \odot A
= {\boldsymbol{M}}_{{\mathrm{CP}}} \odot A
\end{split} $
|
(3) |
最终的光谱通道注意力图$ E\in {{\bf{R}}}^{C\times w\times w} $由A、$ {{\boldsymbol{E}}}_{{\mathrm{CM}}} $、$ {{\boldsymbol{E}}}_{{\mathrm{CP}}} $以及两个初始化为零的可学习权重参数$ \alpha $和$ \beta $得到,可用公式表示为
|
$ E=\alpha \otimes {{\boldsymbol{E}}}_{{\mathrm{CM}}}+\beta \otimes {{\boldsymbol{E}}}_{{\mathrm{CP}}}+A $
|
(4) |
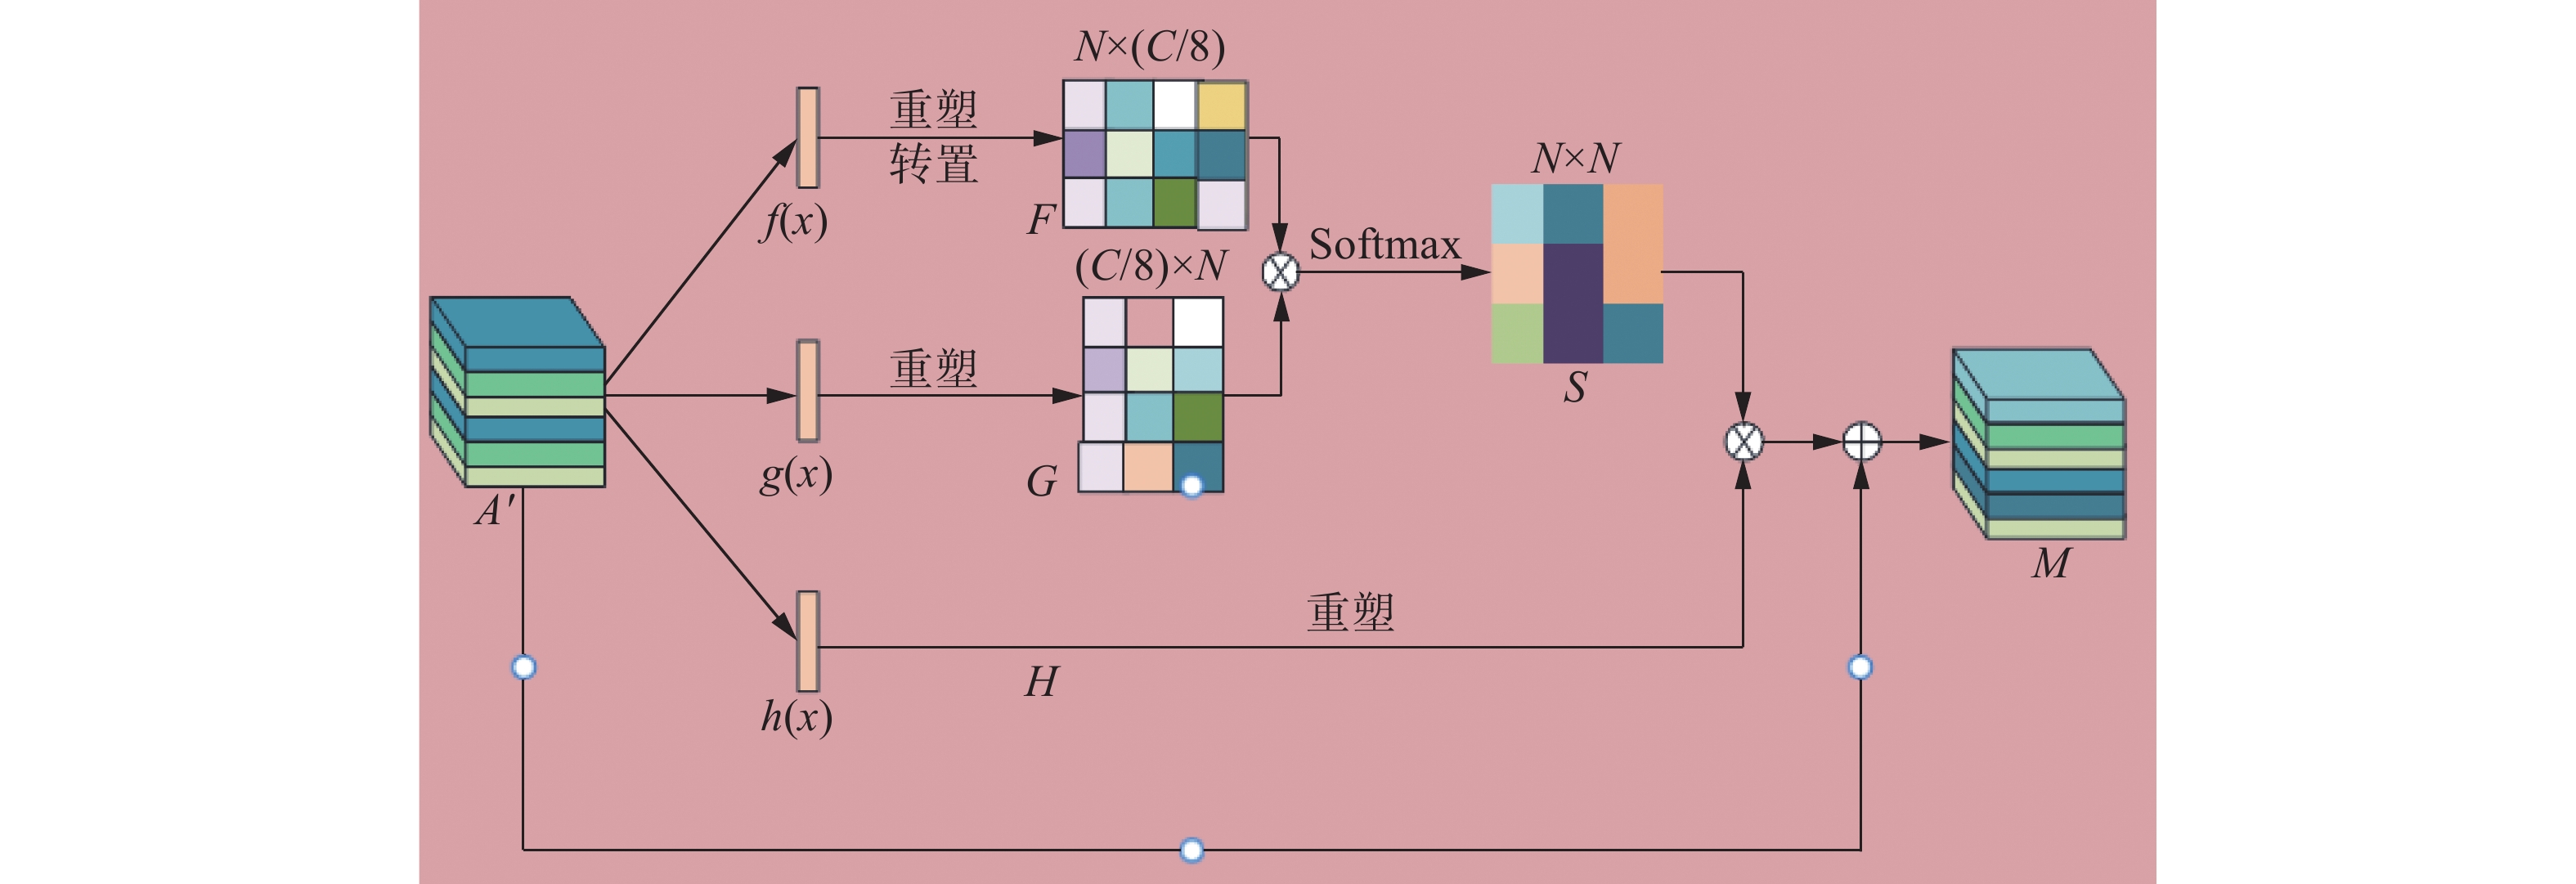
空间分支中的结构示意如图4所示。采用3个由卷积层构成的自适应聚合函数f(x)、g(x)和h(x)得到3个新的特征F、G和H,并由F和G得到空间注意力图S$ \in $RN×N,其中N=w×w,可用公式表示为
|
$ {S}_{ ji}=\frac{\exp \left({F}_{i}\times {G}_{j}\right)}{\displaystyle\sum\limits_{i=1}^{N}\exp \left({F}_{i}\times {G}_{j}\right)} $
|
(5) |
式中,Sji表示空间位置上第i个像素对第j个像素的影响,这两个位置的像素特征越相似,Sji值越大。空间维度上的长距离上下文信息被建模为M$ \in $RC×w×w,具体过程可用公式表示为
|
$ {M}_{j}=\delta \displaystyle\sum\limits_{i=1}^{N}\left({S}_{ ji}{H}_{i}\right)+{A}^{\prime} $
|
(6) |
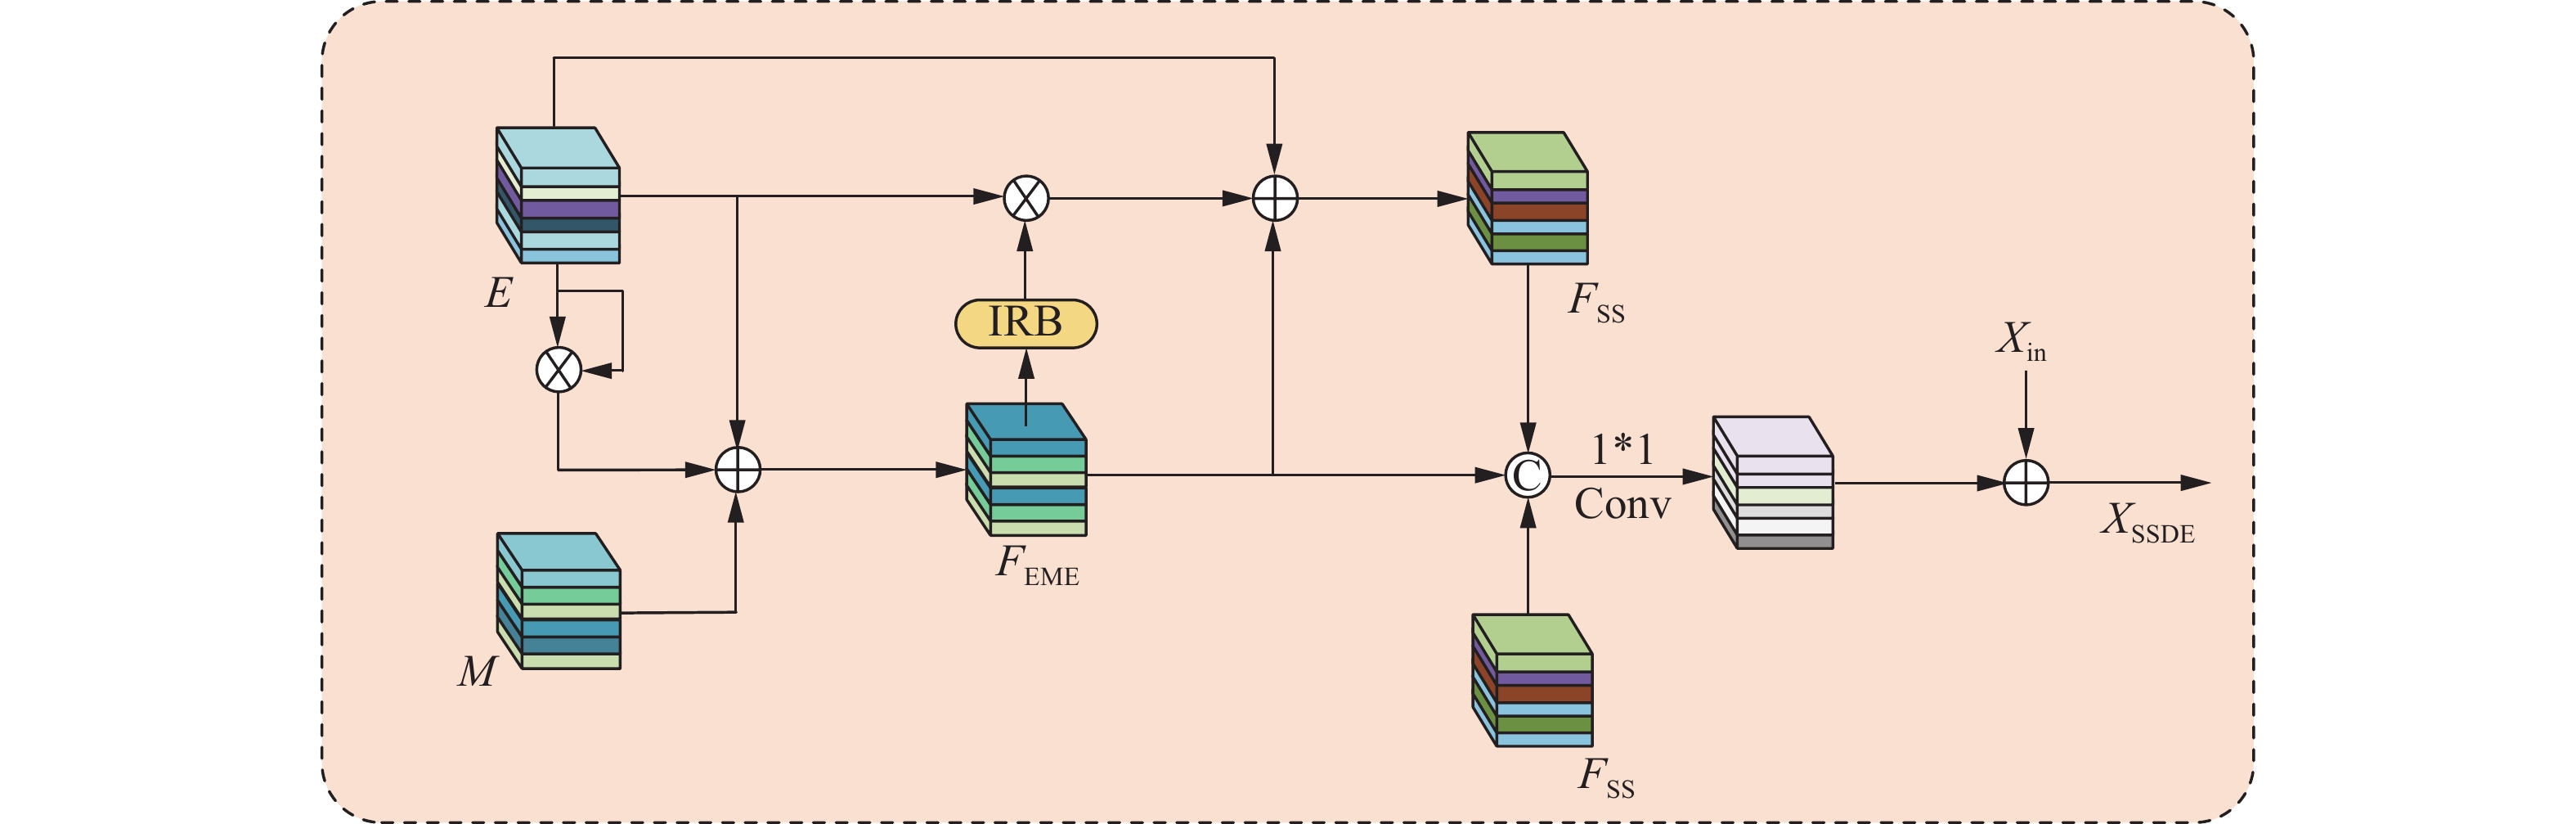
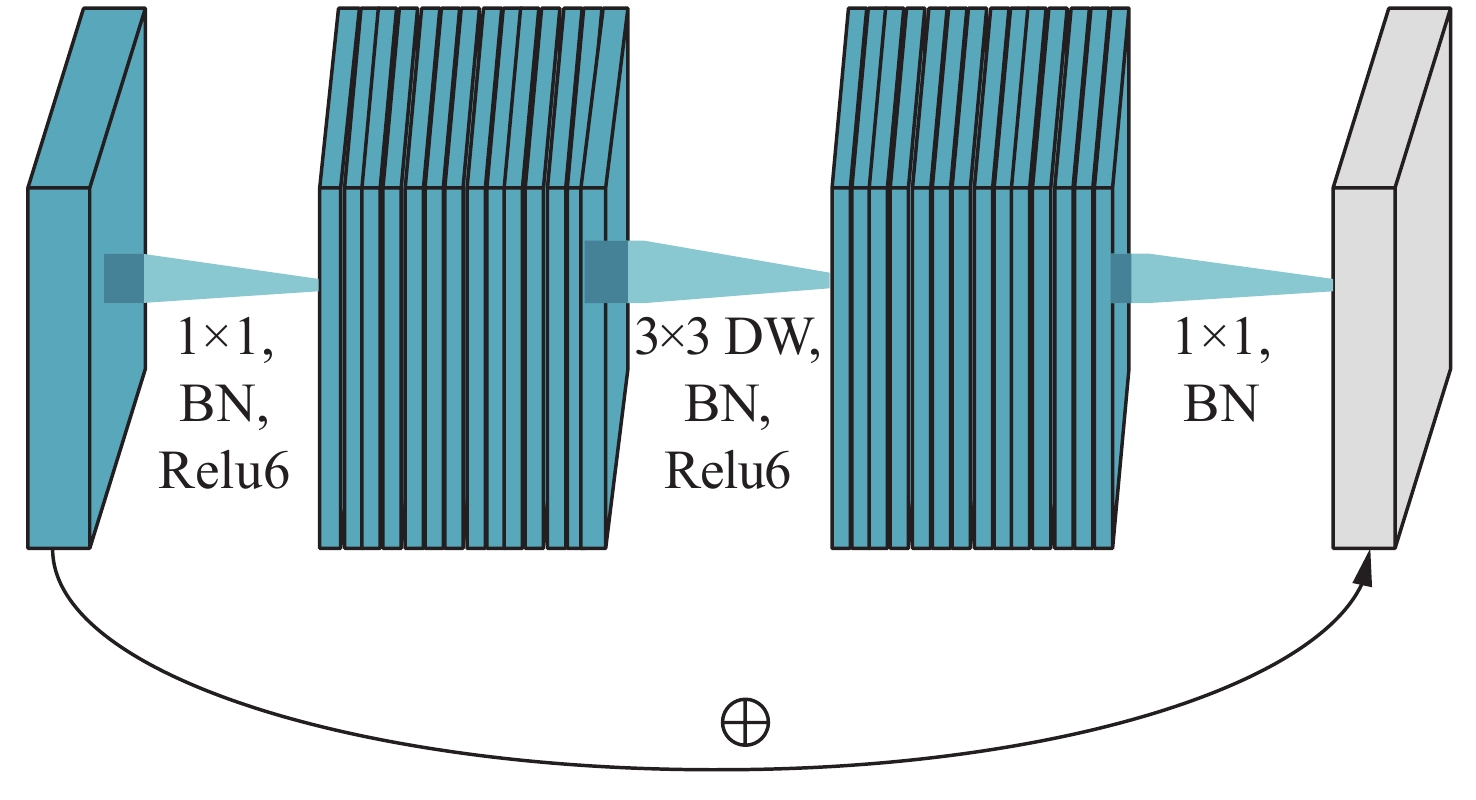
1.2 空间–光谱双特征交互编码 空间–光谱双特征交互编码(SSDIE)模块结构如图5所示,利用倒残差块(inverted residual block,IRB)进行特征提取,其结构如图6所示。在SSDIE中首先将E进行自乘操作,增强重要特征并削弱噪声。聚合特征$ {F}_{{\mathrm{EME}}} $由3部分组成,通过逐元素相加的方式融合空间–光谱特征,可用公式来表示为
|
$ {F}_{{\mathrm{EME}}}=\left(E\otimes E\right)\oplus E\oplus M $
|
(7) |
通过IRB提取$ {F}_{{\mathrm{EME}}} $的特征,并结合$ E $得到加强特征表达的$ {F}_{{\mathrm{SS}}} $,将$ {F}_{{\mathrm{SS}}} $与$ {F}_{{\mathrm{EME}}} $在光谱通道维度上进行拼接,具体过程可用公式表示为
|
$ {F}_{{\mathrm{SS}}}=\left(\mathrm{IRB}\left({F}_{{\mathrm{EME}}}\right)\otimes E\right)\oplus E\oplus {F}_{{\mathrm{EME}}} $
|
(8) |
|
$ {X}_{{\mathrm{SSDE}}}=\mathrm{PWConv}\left(\mathrm{Concat}\left({F}_{{\mathrm{SS}}}\text{,}{F}_{{\mathrm{EME}}}\text{,}{F}_{{\mathrm{SS}}}\right)\right)\oplus {X}_{{\mathrm{in}}} $
|
(9) |
式中,$ \text{PWConv} $是一次Pointwise卷积操作[13]。这种结构可以实现空间–光谱特征两者之间的交互作用,提供互补信息,从而增强空间–光谱特征的表达能力。在最后,还使用了一次长的跳跃连接,将原始输入Xin添加进来,从而防止原始特征丢失。
1.3 语义标记与位置嵌入模块 将浅层的空间–光谱特征转换为深度语义特征[10],使标记的特征更符合样本的分布。将XSSDE展平得到的特征定义为Xflat$ \in $RN×B,定义两个服从高斯分布的初始化权重矩阵$ {{\boldsymbol{W}}}_{{\mathrm{a}}}\in {R}^{B\times n} $和$ {{\boldsymbol{W}}}_{{\mathrm{v}}}\in {R}^{B\times 64} $,n为设置的数量。最终的Xpatch由两个可学习的权值来提取关键特征,可表示为
|
$ {X}_{{\mathrm{wa}}}=\mathrm{softmax}\left(T\left({X}_{{\mathrm{flat}}}{W}_{{\mathrm{a}}}\right)\right) $
|
(10) |
|
$ {X}_{{\mathrm{wv}}}={X}_{{\mathrm{flat}}}\otimes {W}_{{\mathrm{v}}} $
|
(11) |
|
$ {X}_{{\mathrm{patch}}}={X}_{{\mathrm{wa}}}\otimes {X}_{{\mathrm{wv}}} $
|
(12) |
式中:Xwa$ \in $Rn×N,Xwv$ \in $RN×64,Xpatch$ \in $Rn×64,Xpatch由Xflat经语义映射得到。通过在补丁嵌入中添加可训练的位置嵌入Xposition,可以保留图像补丁标记中的语义纹理信息。在此操作后使用值为0.1的Dropout layer,以减少消失梯度的影响,上述过程可以表示为
|
$ {X}_{{\mathrm{patch}}}=\mathrm{Concat}\left({X}_{{\mathrm{cls}}}\text{,}{X}_{{\mathrm{patch}}}\right) $
|
(13) |
|
$ {X}_{{\mathrm{SP}}}=\mathrm{DP}\left({X}_{{\mathrm{patch}}}\oplus {X}_{{\mathrm{position}}}\right) $
|
(14) |
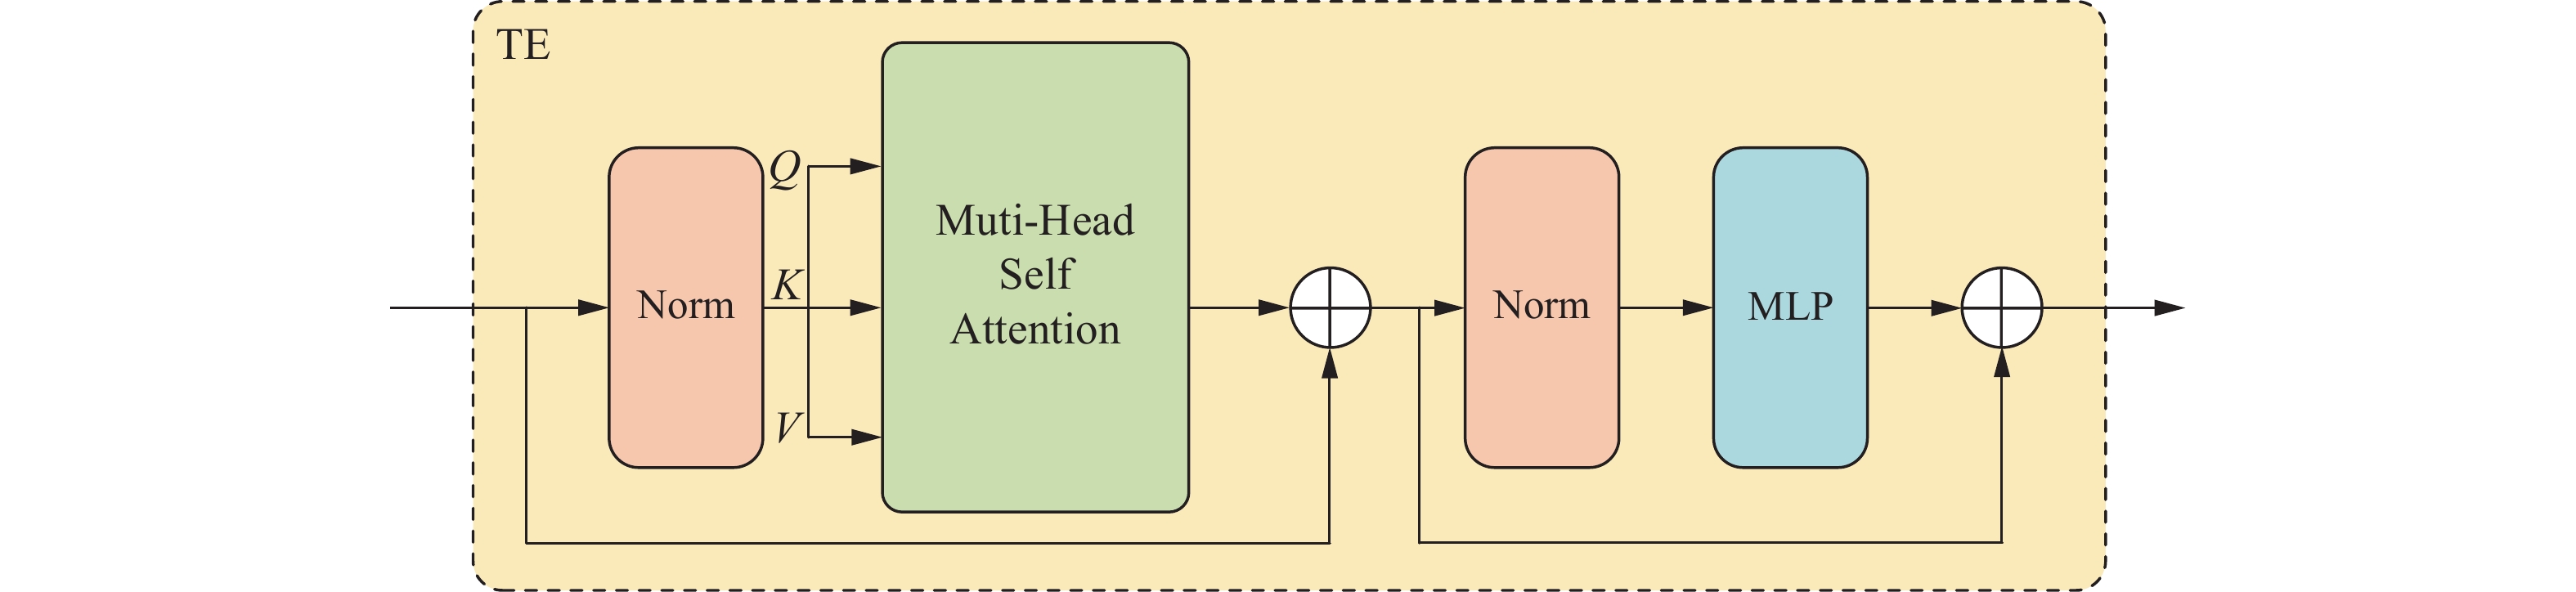
1.4 Transformer Encoder TE模块如图7所示,主要包含一个多头自注意机制(multi-head self attention,MSA)模块、一个多层感知机(multilayer perceptron,MLP)层和两个归一化(normalization)层。将带有语义标记和位置信息的patch展平作为输入,采用自注意力机制(self-attention,SA)有效捕获特征序列之间的相关性。预先初始化3个可学习权重矩阵WQ、WK和WV,并由此产生查询(Q),键值对(K、V),SA的计算公式为
|
$
{X}_{{\mathrm{SP}}}=\mathrm{DP}\left({X}_{{\mathrm{patch}}}\oplus {X}_{{\mathrm{position}}}\right) $
|
(15) |
多头自注意力使模型从不同的表示子空间和不同位置共同关注信息,使用相同的操作得到多头注意力值,并将每个头部注意力的结果都连接在一起,这个过程可以表示为
|
$ \begin{split} &
\mathrm{MSA}(Q\text{,}K\text{,}V)=\\&\quad \mathrm{Concat}(S{A}_{1}\text{,}S{A}_{2}\text{,}\cdots \text{,}S{A}_{h}){\boldsymbol{W}}
\end{split} $
|
(16) |
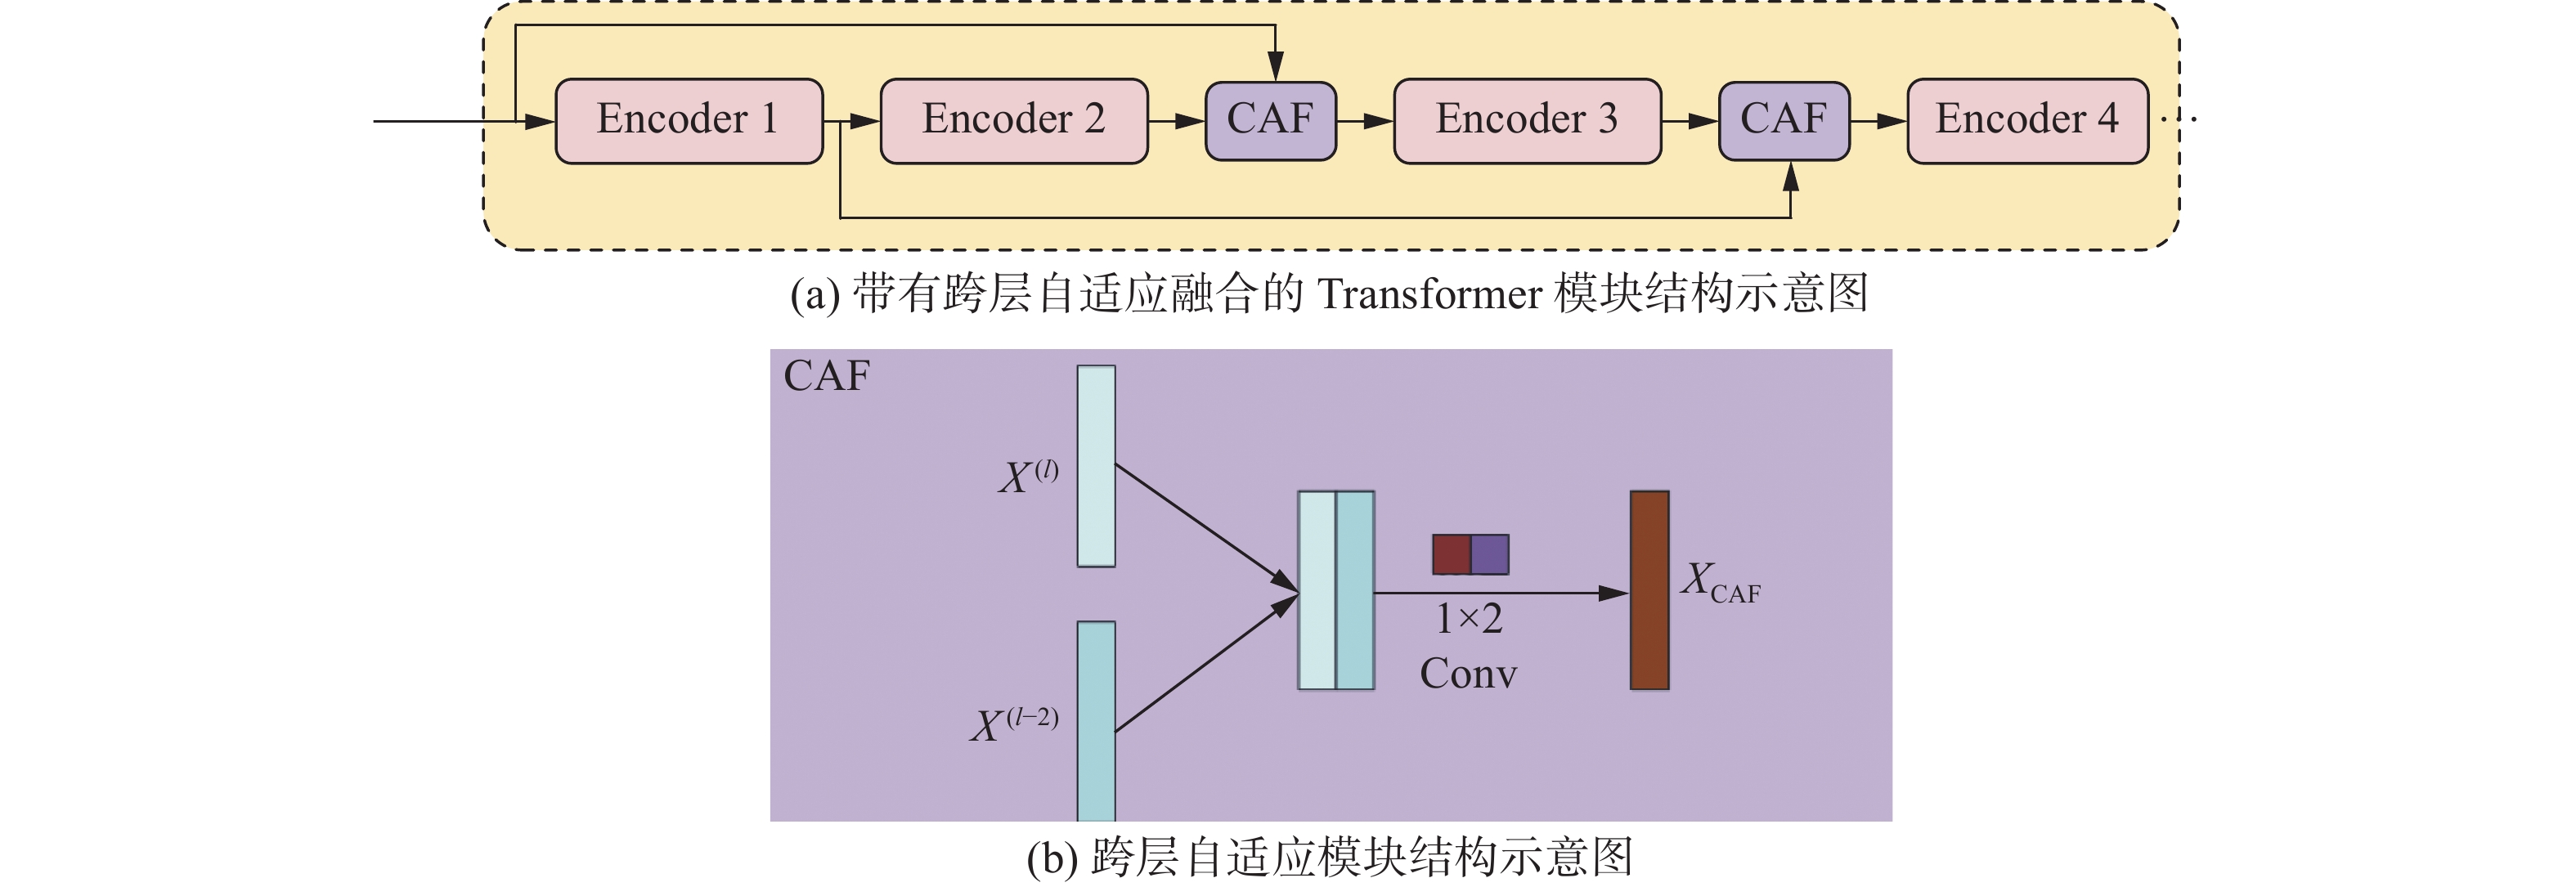
式中:h为头的数量;W为参数矩阵。多层感知机制模块由两个全连接层和一个非线性激活层组成,最后通过一个线性层和softmax函数得到最终分类结果。在不同输出层中加入了跨层自适应融合(cross-layer adaptive fusion,CAF)模块[9],结构如图8所示,以增强层之间的信息交换,减少网络学习过程中的信息损失。这个过程可用公式表示为
|
$ {X}_{{\mathrm{CAF}}}={{F}}_{{\mathrm{CAF}}}\left({X}^{\left(l\right)}\text{,}{X}^{\left(l-2\right)}\right)\;\; \left(l=2,3,4\right) $
|
(17) |
式中:X(l)和X(l−2)为第l层和(l−2)层Encoder的输出;FCAF是跨层自适应融合的函数。
2 实验结果和分析 为了评估所提出的DBAIE的分类性能,在3个公开数据集中进行实验验证,并将本文网络模型,与其他先进模型进行了比较分析。
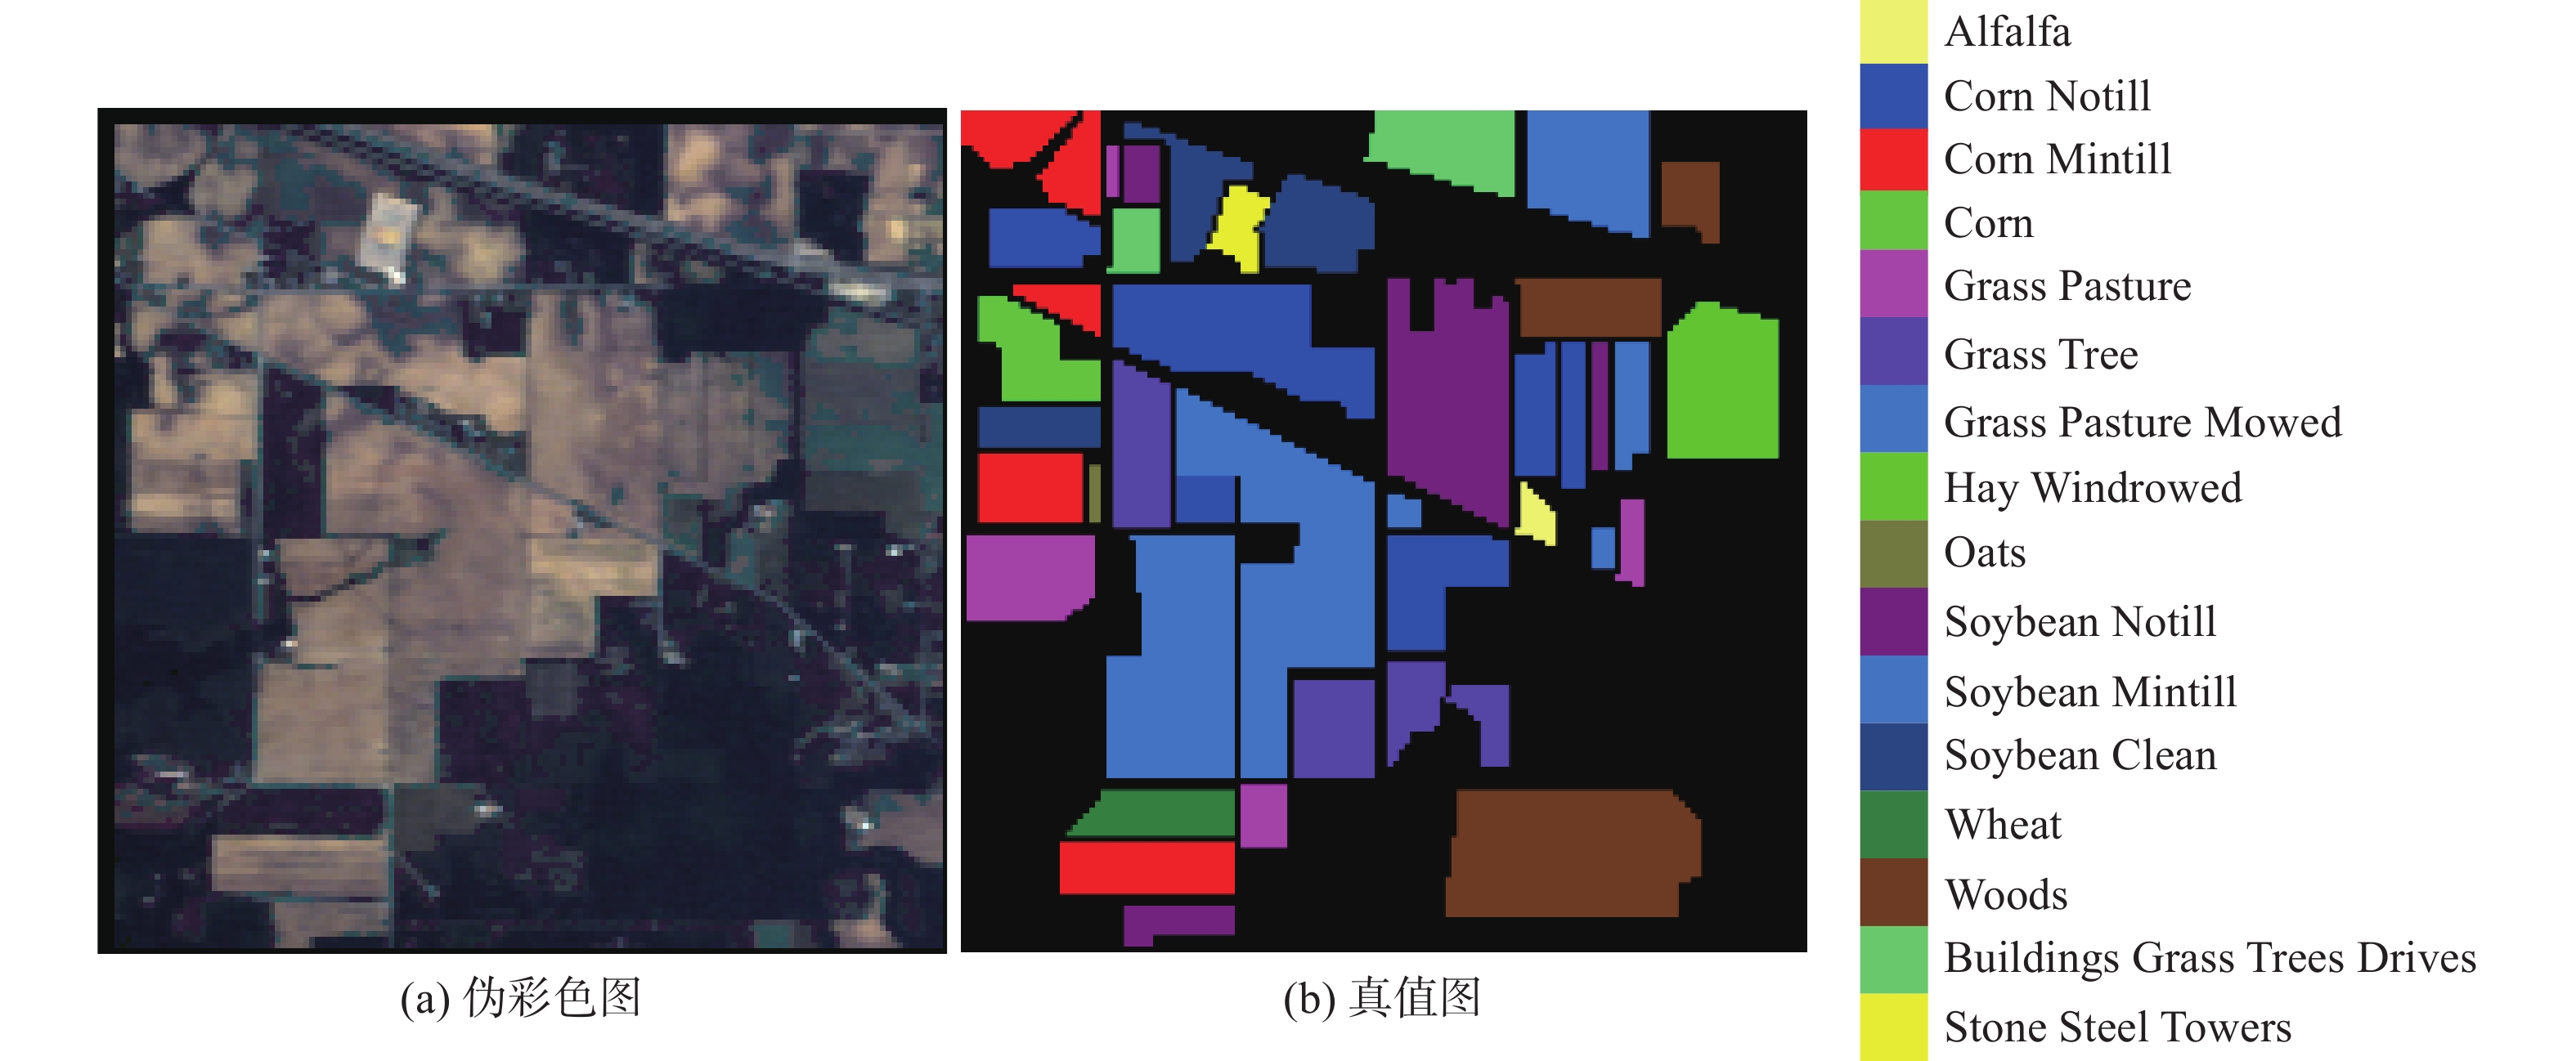
2.1 数据介绍 Indian Pines数据集是1992年由AVIRIS传感器收集的印第安纳州西北部的印度松树试验场的图像,大小为145×145 像素。剔除其中的24个噪声波段,将剩余的200个波段作为研究对象。它包含16个类别,图9(a)和(b)所示为该数据集的伪彩色图和真值图。
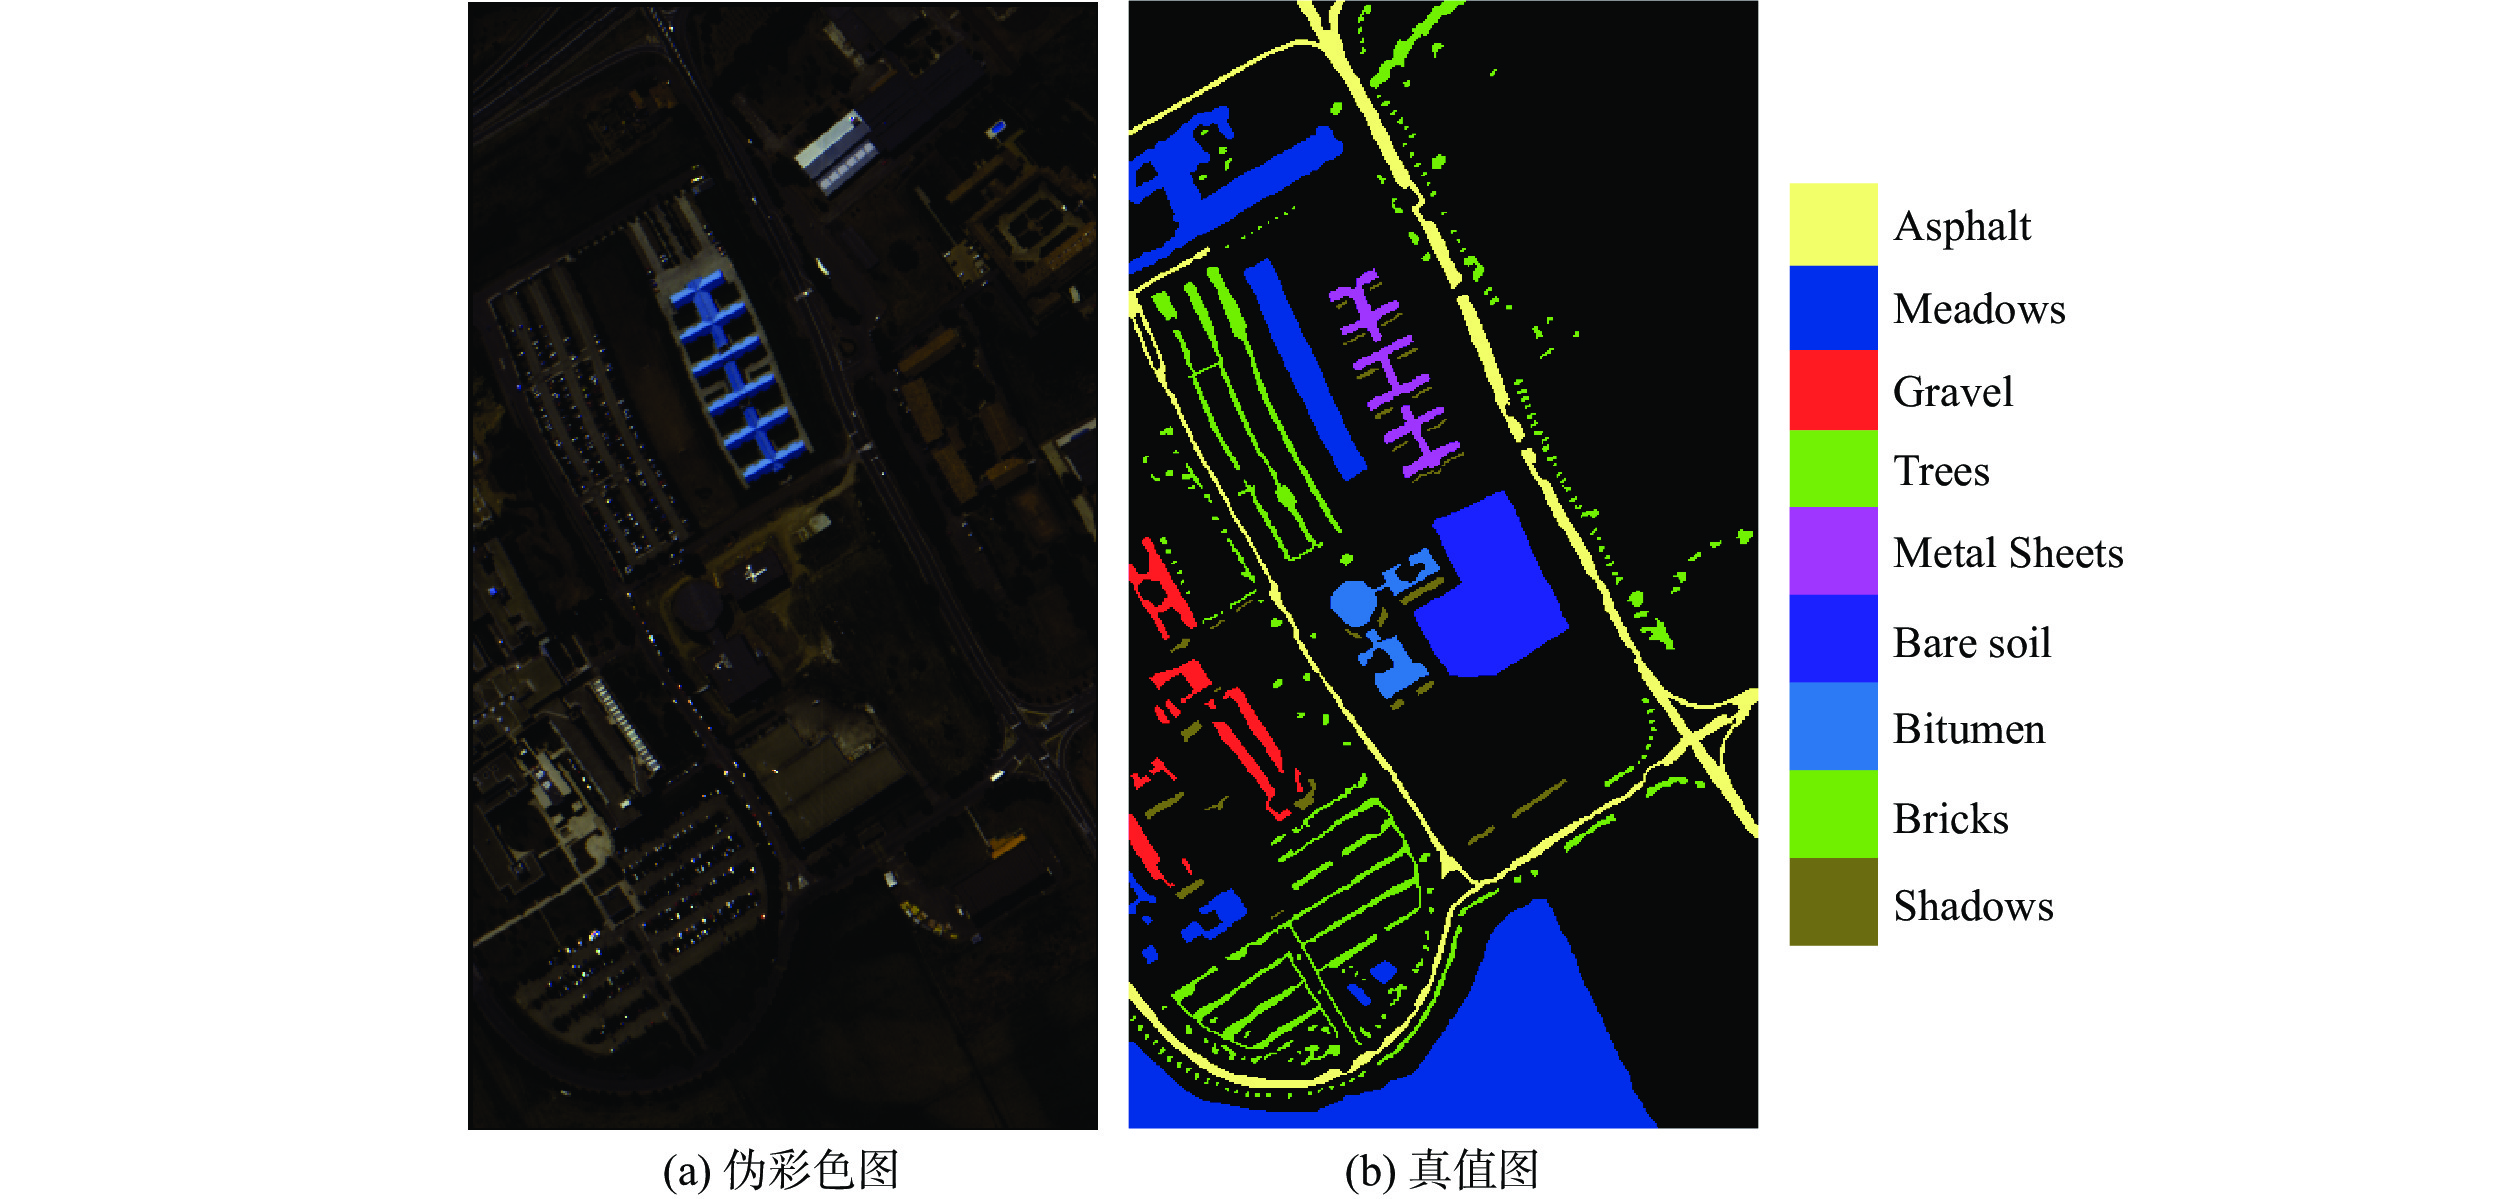
Pavia University数据集是2001年由德国机载反射光学光谱成像仪在意大利的帕维亚大学所拍摄的高光谱数据,大小为610×340 像素。其中12个波段由于受噪声影响被剔除,因此一般使用的是剩下103个光谱波段所成的图像。图10(a)和(b)所示为该数据集的伪彩色图和真值图。
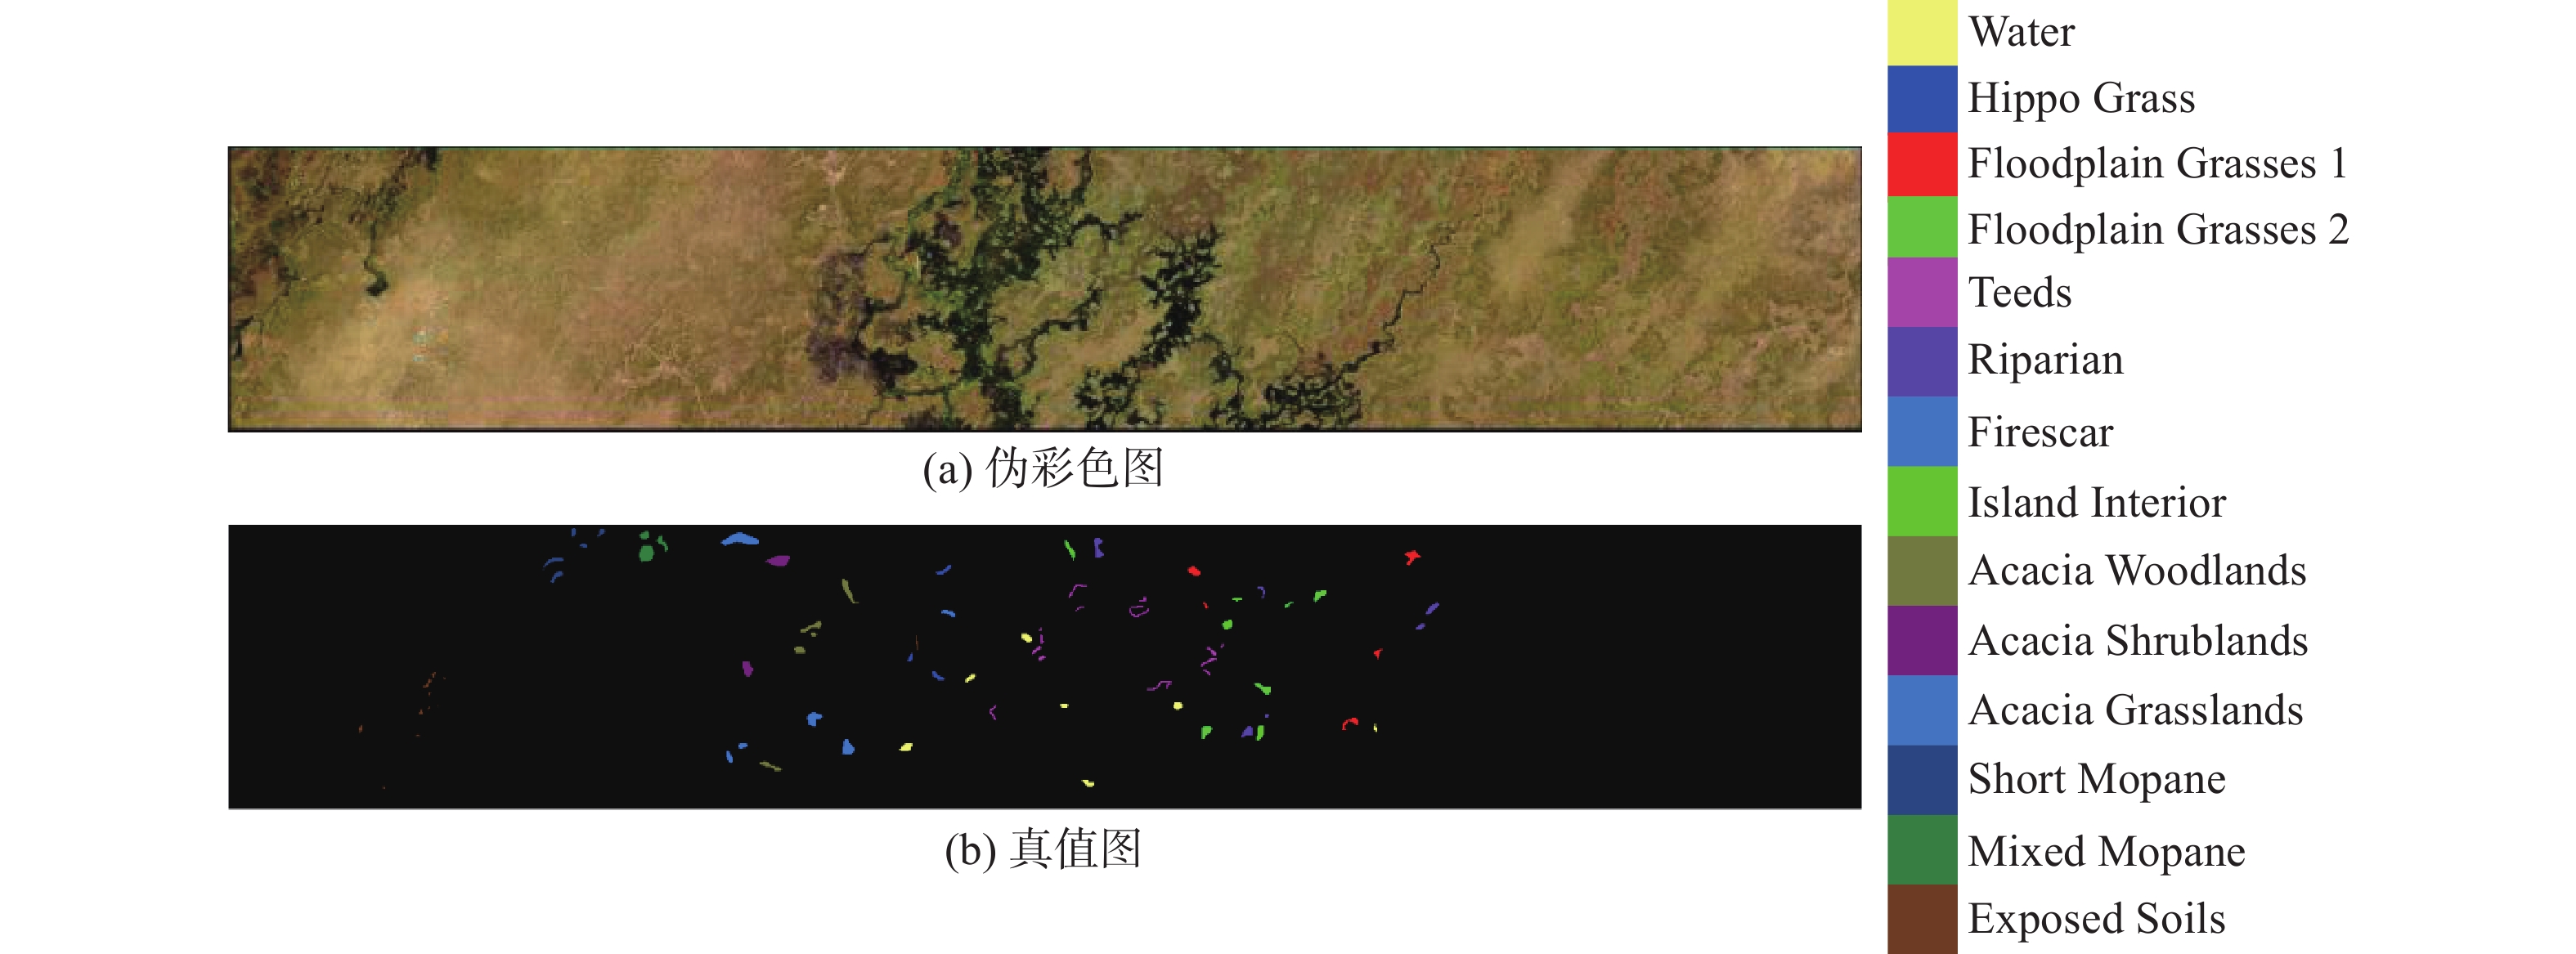
Botswana数据集是由得克萨斯大学空间研究中心在2001年至2004年期间收集的,在EO–1上通过Hyperion传感器获得,其覆盖了博茨瓦纳三角洲上空图像,大小为1496×256像素。已去除了97个未校准和受水影响的波段,剩下145个光谱波段。图11(a)和(b)所示为该数据集的伪彩色图和真值图。
表1列出了这3个数据集的土地覆盖类别名称、训练样本数量和测试样本。每个数据集按比例随机取样,被划分为训练集和测试集。从Pavia University和Botswana数据集中随机抽取5%的样本作为训练集,从Indian Pines数据集中随机抽取10%的样本作为训练集。
表 1
(Table 1)
表 1 Indian Pines、Pavia University和Botswana数据集类别及样本划分
Table 1 Class and sample division of the Indian Pines, Pavia University, and Botswana datasets
| NO. |
Indian Pines |
|
Pavia University |
|
Botswana |
| Class |
Training |
Test |
|
Class |
Training |
Test |
|
Class |
Training |
Test |
| 1 |
Alfalfa |
4 |
42 |
|
Asphalt
|
331 |
6300 |
|
Water |
13 |
257 |
| 2 |
Corn Notill
|
142 |
1286 |
|
Meadows
|
932 |
17717 |
|
Hippo Grass
|
5 |
96 |
| 3 |
Corn Mintill
|
83 |
747 |
|
Gravel
|
104 |
1995 |
|
Floodplain Grasses 1
|
12 |
239 |
| 4 |
Corn |
23 |
214 |
|
Trees
|
153 |
2911 |
|
Floodplain Grasses 2
|
10 |
205 |
| 5 |
Grass Pasture
|
48 |
435 |
|
Metal Sheets
|
67 |
1278 |
|
Teeds
|
13 |
256 |
| 6 |
Grass Tree
|
73 |
657 |
|
Bare soil
|
251 |
4778 |
|
Riparian
|
13 |
256 |
| 7 |
Grass Pasture Mowed
|
2 |
26 |
|
Bitumen
|
66 |
1264 |
|
Firescar
|
12 |
247 |
| 8 |
Hay Windrowed |
47 |
431 |
|
Bricks
|
184 |
3498 |
|
Island Interior
|
10 |
193 |
| 9 |
Oats
|
2 |
18 |
|
Shadows
|
47 |
900 |
|
Acacia Woodlands |
15 |
299 |
| 10 |
Soybean Notill
|
97 |
875 |
|
|
|
|
|
Acacia Shrublands
|
12 |
236 |
| 11 |
Soybean Mintill
|
245 |
2210 |
|
|
|
|
|
Acacia Grasslands
|
15 |
290 |
| 12 |
Soybean Clean
|
59 |
534 |
|
|
|
|
|
Short Mopane
|
9 |
172 |
| 13 |
Wheat
|
20 |
185 |
|
|
|
|
|
Mixed Mopane |
13 |
255 |
| 14 |
Woods
|
126 |
1139 |
|
|
|
|
|
Exposed Soils |
4 |
91 |
| 15 |
Buildings Grass Trees Drives
|
38 |
348 |
|
|
|
|
|
|
|
|
| 16 |
Stone Steel Towers
|
9 |
84 |
|
|
|
|
|
|
|
|
|
Total |
1018 |
9231 |
|
Total |
2135 |
40641 |
|
Total |
156 |
3092 |
|
表 1 Indian Pines、Pavia University和Botswana数据集类别及样本划分
Table 1 Class and sample division of the Indian Pines, Pavia University, and Botswana datasets
|
2.2 实验设置 评价指标:为了定量分析提出方法的有效性以及与其他先进方法的性能对比,分别使用整体分类精度(OA)、平均分类精度(AA)和Kappa(KA)系数来判断模型的分类性能。此外,为更直观地对比不同模型的性能,将分类结果可视化后进行定性对比。
环境配置:所有的实验都在Pytorch环境下进行,使用的处理器为Intel Core i5–12400F,内存为32 GB,显卡为NVIDIA RTX 3060 12 GB。
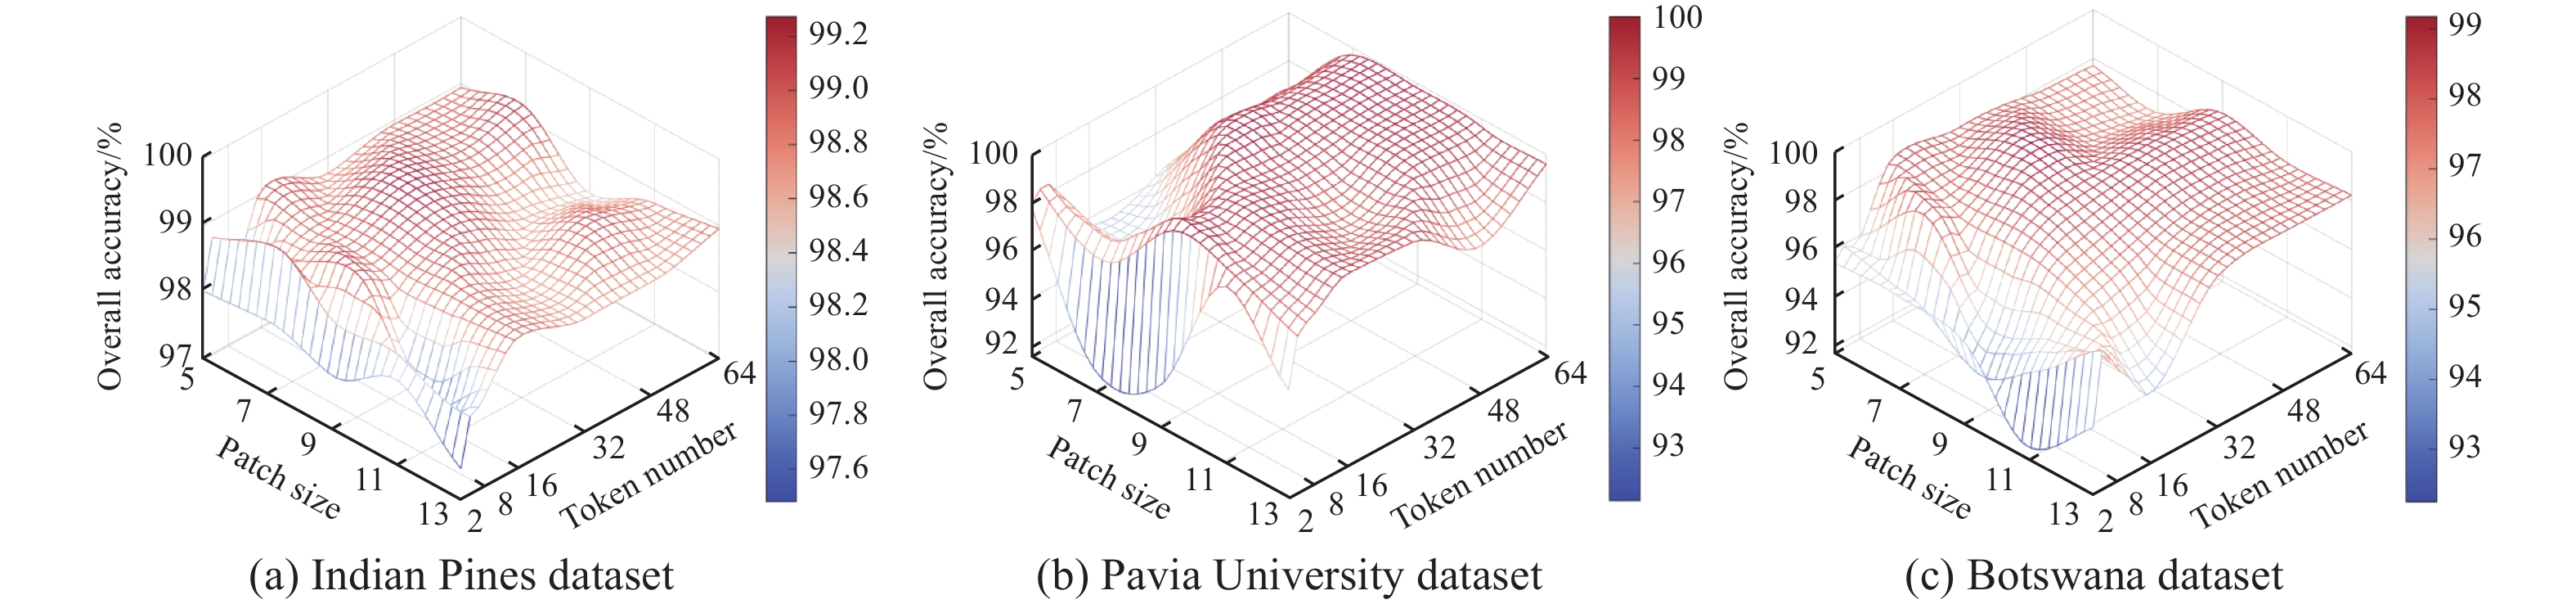
参数设置:影响模型分类效果的参数主要有两个,原始输入窗口大小w和SP模块中的数量n。分析了不同组合的w和n对3个数据集的分类精度的影响,结果如图12所示。当w$ \in $[5,11],n$ \in $[16,48]时可以得到一个局部光滑的凸函数,考虑到w和n过大会增加算力成本,在后续实验中将w设置为7,n设置为32。参数分析期间,还配置了其它参数,如批大小设置为64,epoch设置为600。
2.3 分类结果 为证明本文模型的有效性,选择了一些具有代表性的模型,如SVM、3D-CNN[14]、SpectralFormer[9]、SSFTT[10]、MorphFormer[15]、GSC[16],与其进行性能对比。为了公平比较,对比实验均采用模型原有参数设置。
定量分析:表2、表3和表4分别展示了不同模型在Indian Pines、Pavia University和Botswana 3个数据集上的OA、AA、Kappa评价指标和每一个类的分类准确率,最优结果用黑体表示。结果表明,所提出的DBAIE在3个数据集上均取得最优OA、AA和Kappa值。
表 2
(Table 2)
表 2 不同方法对Indian Pines数据集分类结果
Table 2 Classification results of different methods on the Indian Pines dataset
| NO. |
SVM |
3D-CNN |
SpectralFormer |
SSFTT |
MorphFormer |
GSC |
Ours |
| 1 |
47.82 |
73.91 |
61.39 |
100.00 |
71.42 |
68.29 |
90.47 |
| 2 |
77.94 |
94.67 |
92.06 |
96.18 |
99.22 |
95.88 |
99.30 |
| 3 |
74.81 |
89.06 |
90.89 |
98.92 |
99.59 |
98.93 |
99.59 |
| 4 |
60.33 |
73.41 |
72.89 |
100.00 |
94.39 |
89.20 |
100.00 |
| 5 |
90.47 |
94.87 |
97.24 |
99.54 |
98.39 |
98.85 |
98.85 |
| 6 |
97.12 |
99.58 |
98.78 |
99.84 |
98.32 |
99.39 |
99.54 |
| 7 |
53.57 |
75.00 |
38.46 |
100.00 |
100.00 |
100.00 |
100.00 |
| 8 |
98.95 |
99.16 |
100.00 |
100.00 |
100.00 |
100.00 |
100.00 |
| 9 |
55.00 |
95.00 |
83.30 |
61.11 |
83.33 |
66.67 |
100.00 |
| 10 |
78.18 |
87.94 |
88.45 |
98.97 |
99.31 |
94.40 |
99.21 |
| 11 |
81.91 |
92.54 |
96.01 |
99.32 |
99.59 |
98.91 |
99.68 |
| 12 |
79.59 |
83.81 |
78.46 |
97.03 |
94.56 |
94.38 |
99.06 |
| 13 |
94.63 |
99.51 |
98.91 |
100.00 |
100.00 |
100.00 |
98.91 |
| 14 |
92.88 |
99.20 |
96.48 |
99.91 |
99.64 |
98.33 |
100.00 |
| 15 |
63.98 |
84.02 |
84.48 |
100.00 |
97.98 |
87.32 |
98.27 |
| 16 |
88.17 |
93.54 |
100.00 |
91.66 |
96.42 |
96.43 |
98.80 |
| OA/% |
82.79 |
92.68 |
92.60 |
98.75 |
98.74 |
96.95 |
99.44 |
| AA/% |
77.21 |
89.71 |
86.15 |
96.40 |
95.76 |
92.94 |
98.86 |
| KA*100 |
80.37 |
91.64 |
91.54 |
98.57 |
98.56 |
96.53 |
99.36 |
|
表 2 不同方法对Indian Pines数据集分类结果
Table 2 Classification results of different methods on the Indian Pines dataset
|
表 3
(Table 3)
表 3 不同方法对Pavia University数据集分类结果
Table 3 Classification results of different methods on the Pavia University dataset
| NO. |
SVM |
3D-CNN |
SpectralFormer |
SSFTT |
MorphFormer |
GSC |
Ours |
| 1 |
92.59 |
94.48 |
97.76 |
98.65 |
100.00 |
99.25 |
99.87 |
| 2 |
96.87 |
98.70 |
98.74 |
99.94 |
99.89 |
99.55 |
100.00 |
| 3 |
74.03 |
94.48 |
86.56 |
95.48 |
95.26 |
96.94 |
95.23 |
| 4 |
88.21 |
95.85 |
96.87 |
99.45 |
97.90 |
98.21 |
98.35 |
| 5 |
99.10 |
99.40 |
100.00 |
100.00 |
100.00 |
99.84 |
100.00 |
| 6 |
75.93 |
97.71 |
97.34 |
100.00 |
98.84 |
99.56 |
99.95 |
| 7 |
63.83 |
89.54 |
81.01 |
99.36 |
96.01 |
99.76 |
100.00 |
| 8 |
85.90 |
93.48 |
93.45 |
99.14 |
99.34 |
98.97 |
99.48 |
| 9 |
99.89 |
97.25 |
99.66 |
100.00 |
99.06 |
98.44 |
98.66 |
| OA/% |
90.18 |
96.74 |
96.75 |
99.41 |
99.14 |
99.22 |
99.55 |
| AA/% |
86.27 |
95.66 |
94.60 |
99.11 |
98.47 |
98.95 |
99.06 |
| KA*100 |
86.83 |
95.73 |
95.69 |
99.22 |
99.30 |
98.97 |
99.40 |
|
表 3 不同方法对Pavia University数据集分类结果
Table 3 Classification results of different methods on the Pavia University dataset
|
表 4
(Table 4)
表 4 不同方法对Botswana数据集分类结果
Table 4 Classification results of different methods on the Botswana dataset
| NO. |
SVM-Grid |
3D-CNN |
Spectral Former |
SSFTT |
MorphFormer |
GSC |
Ours |
| 1 |
99.62 |
99.62 |
100.00 |
100.00 |
100.00 |
99.22 |
96.88 |
| 2 |
100 |
97.02 |
89.58 |
100.00 |
100.00 |
100.00 |
100.00 |
| 3 |
96.81 |
100.00 |
87.02 |
78.57 |
100.00 |
94.12 |
100.00 |
| 4 |
81.39 |
98.13 |
98.04 |
100.00 |
100.00 |
100.00 |
100.00 |
| 5 |
87.36 |
62.45 |
81.25 |
98.43 |
94.53 |
97.27 |
97.26 |
| 6 |
40.89 |
78.06 |
73.82 |
98.43 |
96.87 |
96.48 |
100.00 |
| 7 |
92.27 |
94.59 |
99.19 |
100.00 |
99.19 |
100.00 |
100.00 |
| 8 |
79.31 |
100.00 |
76.68 |
100.00 |
100.00 |
100.00 |
100.00 |
| 9 |
89.80 |
81.21 |
72.90 |
100.00 |
97.65 |
82.89 |
90.63 |
| 10 |
78.62 |
94.35 |
95.76 |
100.00 |
100.00 |
100.00 |
100.00 |
| 11 |
96.39 |
97.70 |
99.31 |
89.31 |
100.00 |
99.31 |
98.96 |
| 12 |
95.58 |
94.47 |
90.69 |
69.76 |
99.41 |
99.42 |
98.83 |
| 13 |
83.58 |
98.88 |
98.82 |
100.00 |
100.00 |
100.00 |
100.00 |
| 14 |
98.94 |
96.84 |
87.91 |
100.00 |
72.52 |
100.00 |
93.40 |
| OA/% |
86.05 |
91.44 |
89.33 |
95.39 |
98.15 |
97.21 |
98.25 |
| AA/% |
87.19 |
92.38 |
89.36 |
95.32 |
97.15 |
97.76 |
98.29 |
| KA*100 |
84.88 |
90.73 |
88.44 |
95.01 |
98.05 |
96.98 |
98.11 |
|
表 4 不同方法对Botswana数据集分类结果
Table 4 Classification results of different methods on the Botswana dataset
|
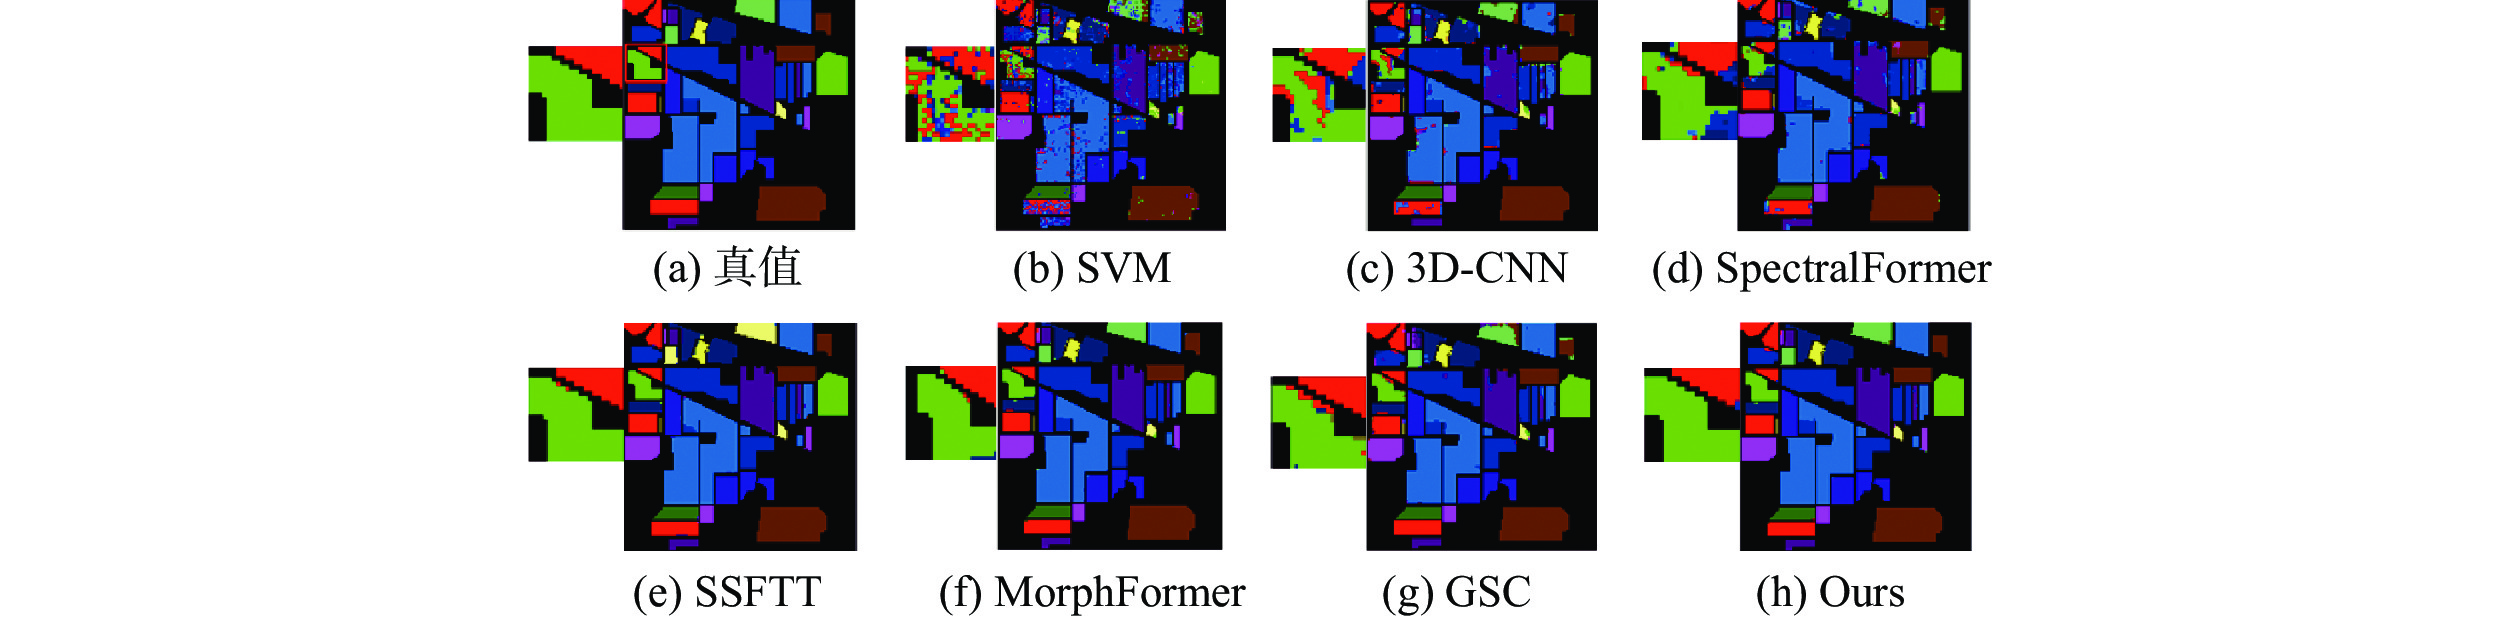
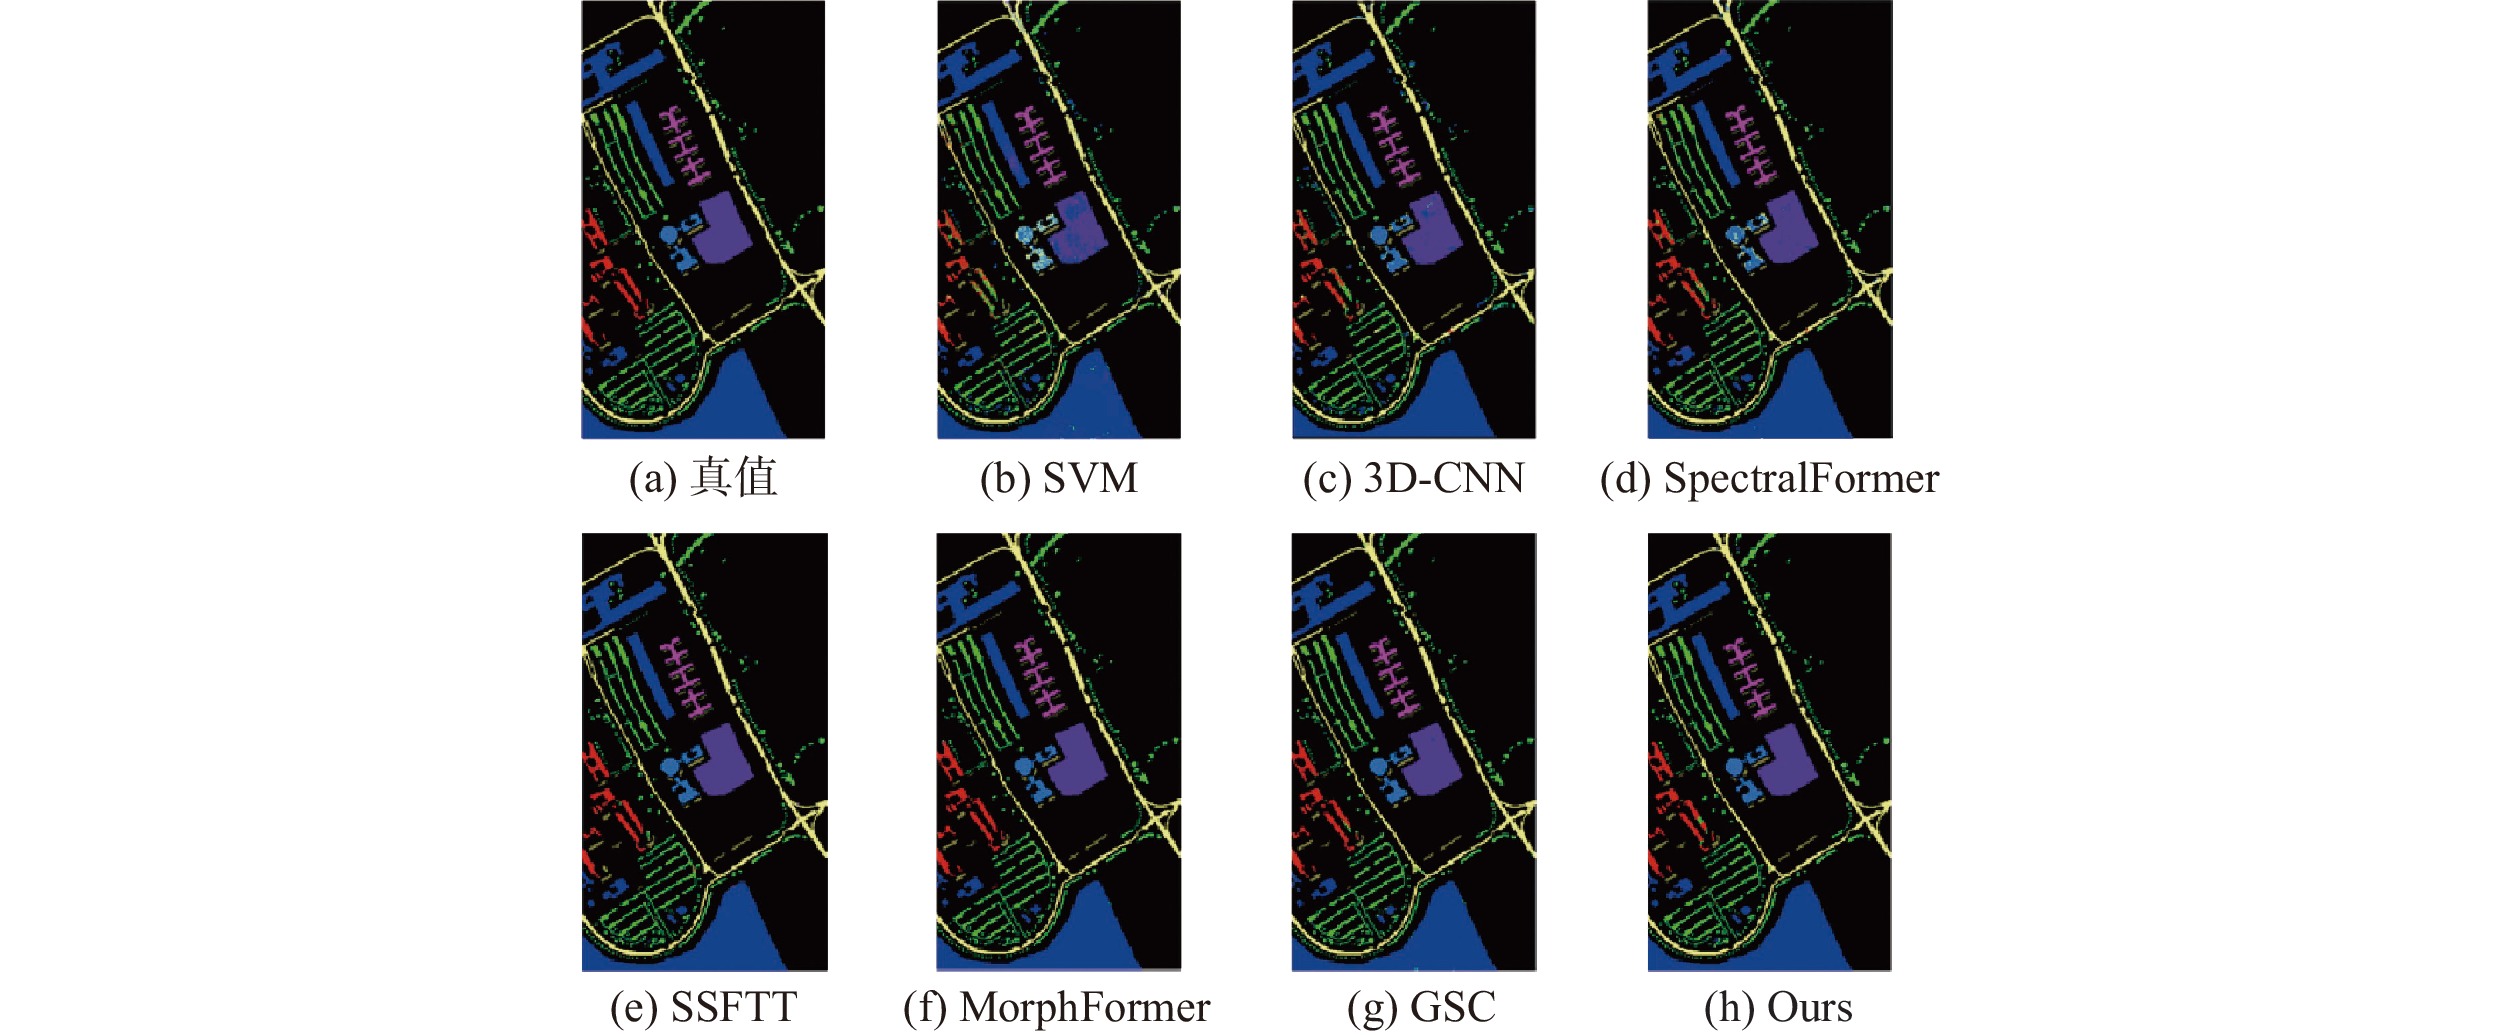
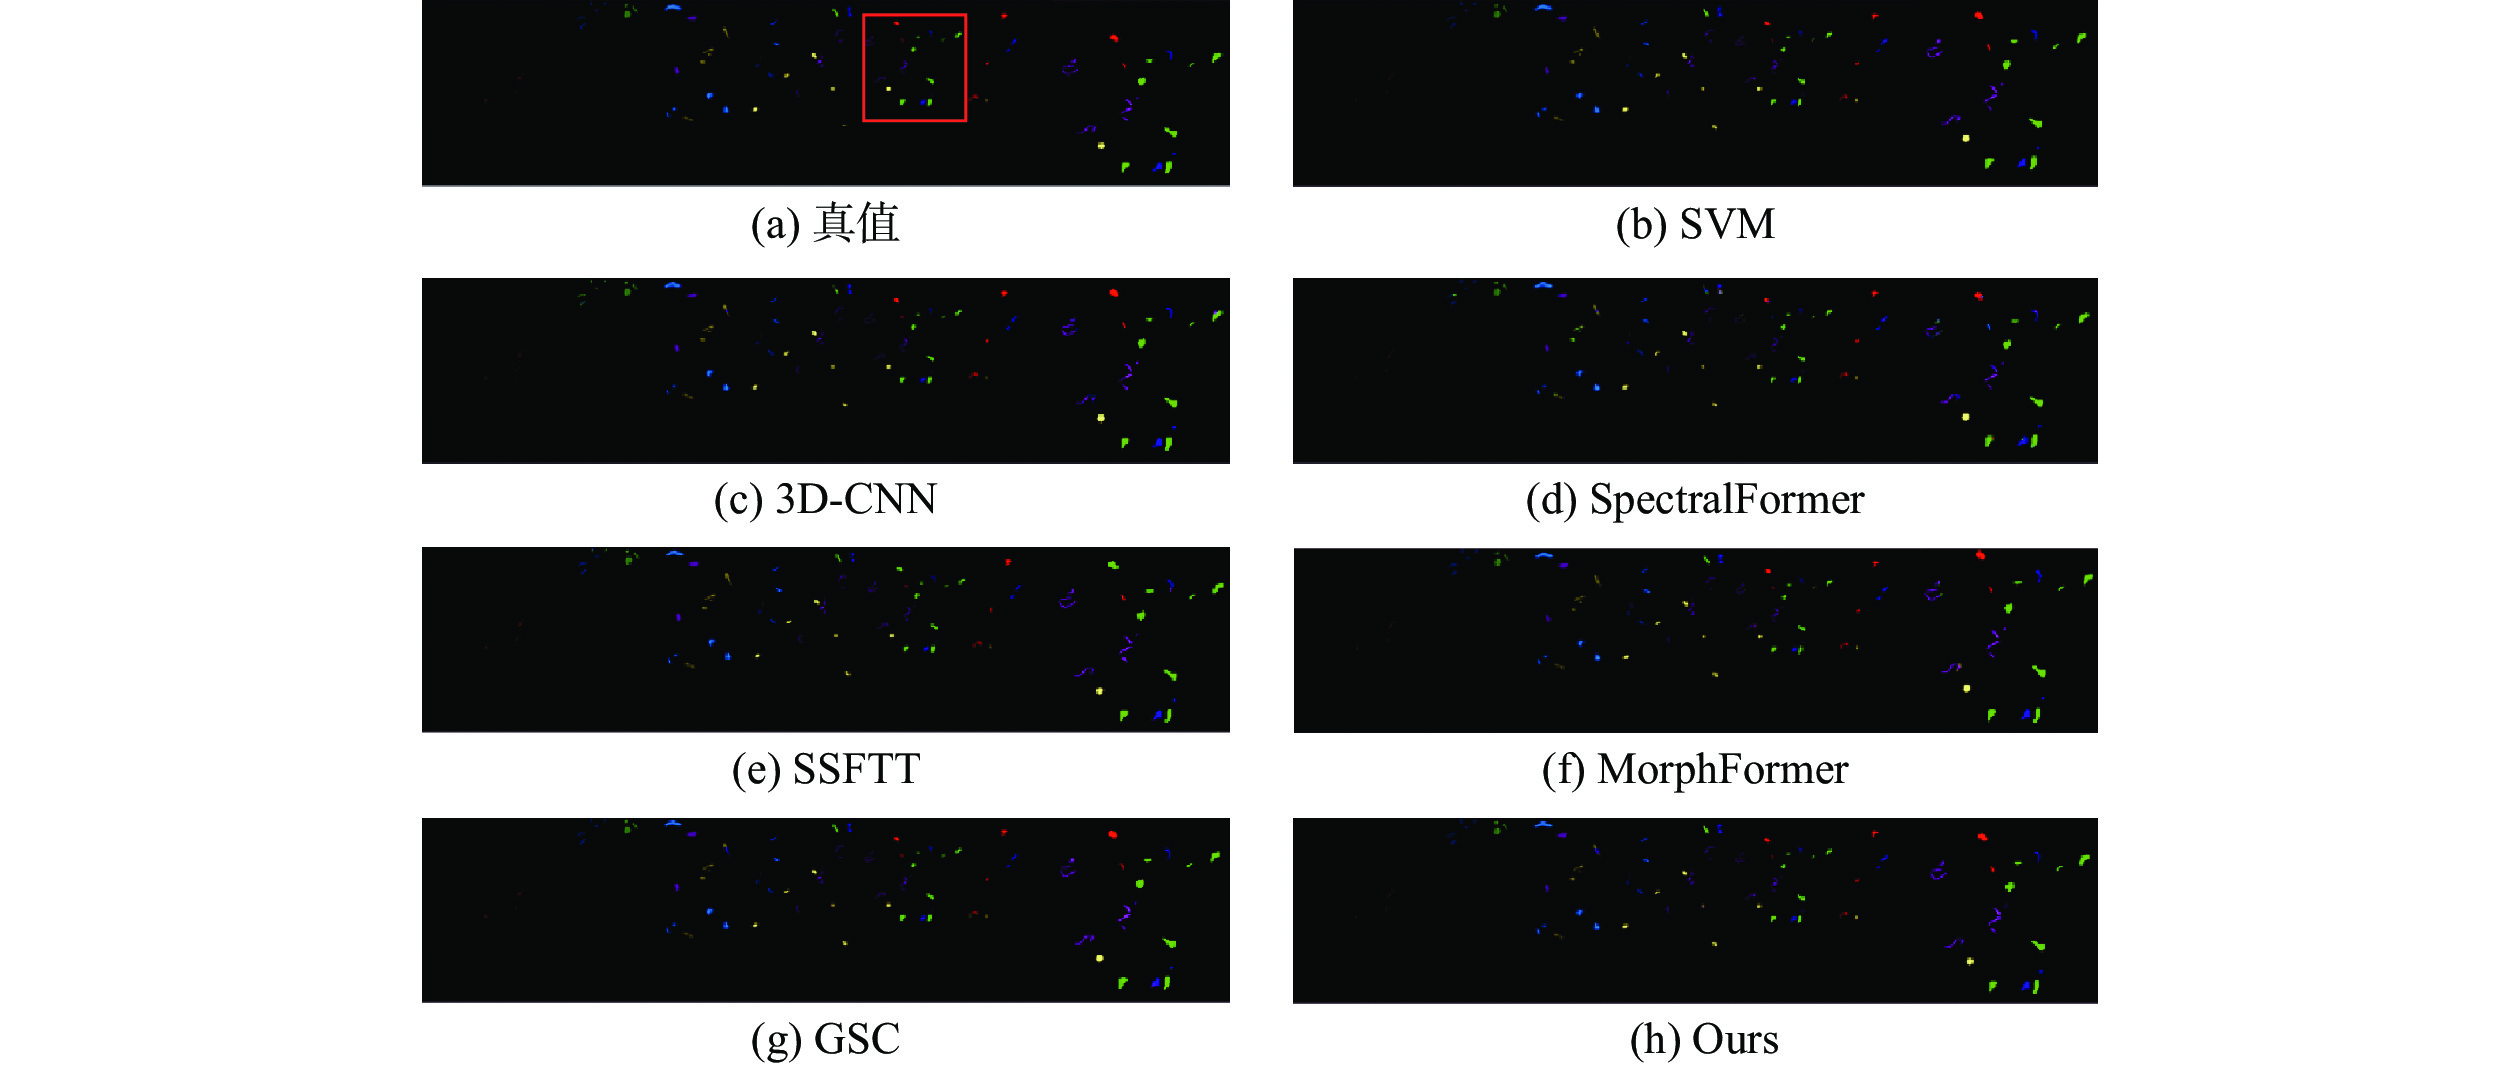
可视化分析:几种模型在3个数据集上的分类图如图13、图14和图15所示。通过对比可以明显看到,DBAIE得到的分类图明显比其他模型得到的分类图边界更清晰,与真实值分类图更相近。从图13和图15中的红框放大区域可以明显看出,DBAIE在区域边缘部分和零散区域部分比其他模型的分类效果更好,这归功于SSDIE模块对空间–光谱特征进行的交互作用,增强了不同类别的空间–光谱特征表达能力,一定程度上减少了“休斯效应”对分类结果的影响。
2.4 消融实验 为充分验证DBAIE模块的有效性,在Indian Pines数据集上进行了充分的消融实验,实验结果如表5所示。在第1个实验中,去除网络结构中的4个模块,只保留基础的ViT模型。在后续实验中,不断组合添加4个模块来证明模块对分类结果的影响。结果显示,各个模块都能有效提升模型的分类性能,在4个模块同时使用时的分类结果最佳。对比实验3、4、5可以发现,分别在实验3的基础上添加DBAM和SSDIE模块都能提高分类准确率,验证了两个模块的有效性。完整的DBAIE模型取得了最佳的准确率,证明了网络整体的有效性。
表 5
(Table 5)
表 5 Indian Pines数据集上消融实验结果
Table 5 Ablation study on the Indian Pines dataset
| Cases | Component | | Metric | | DBAM | SSDIE | SP | CAF | | OA/% | AA/% | KA*100 |
| 1 | ×
| ×
| ×
| ×
| | 90.01 | 84.58 | 88.60 | | 2 | ×
| ×
| ×
| √
| | 95.59 | 86.48 | 91.56 | | 3 | ×
| ×
| √
| √
| | 95.18 | 94.95 | 94.78 | | 4 | ×
| √
| √
| √
| | 98.16 | 97.70 | 98.00 | | 5 | √
| ×
| √
| √
| | 98.54 | 98.51 | 98.42 | | 6 | √
| √
| √
| √
| | 99.44 | 98.86 | 99.36 |
|
表 5 Indian Pines数据集上消融实验结果
Table 5 Ablation study on the Indian Pines dataset
|
3 结 论 本文提出一种联合空间–光谱双分支注意力特征交互编码的高光谱图像分类网络,利用注意力机制提取空间–光谱两种特征后进行两类特征间的信息交互作用,以此增强特征表达能力。通过与多个先进的分类模型在3个数据集上进行比较,验证模型整体的有效性;通过充分的消融实验验证每个模块的有效性。虽然本文所提出的模型已经取得较高分类精度,但在空间–光谱双分支注意力特征提取时难免存在特征冗余问题。因此,在后续的工作中可考虑设计一种交叉空间–光谱注意力特征提取机制以解决特征冗余问题。目前大多数算法往往只能在特定的数据集范围内取得优异性能,当遇到训练集中未出现的类别时,可能会出现明显的精度下降。本文提出的模型也存在相同的问题,后续可考虑采用元学习策略来解决此类问题。
 2026, Vol. 48
 Issue (3): 50-62